


Python 使用 simplejson 与 json 模块解析 JSON 全指南

本文详细讲解 Python 中如何使用标准库 json 与第三方 simplejson 模块进行 JSON 数据的读写、解析与格式化输出。通过实际代码演示嵌套字典与列表的逐层提取方法,并对比两者在无 C 扩展环境下的序列化效率,帮助开发者在实际项目中合理选择数据交换方案并规避性能瓶颈。
一、JSON 简介与 Python 模块选择
JSON(JavaScript Object Notation)是一种轻量级、独立于编程语言的数据交换格式。它基于文本,语法简洁,易于人类阅读编写,同时也便于机器解析与生成。现代编程语言普遍支持 JSON 标准,Python 提供了标准库 json 以及功能更丰富的第三方库 simplejson 来进行数据序列化与反序列化。
核心语法结构:
- 对象(Object):无序的键值对集合,以
{}包裹,键值间以冒号分隔,多组之间用逗号分隔。{"name": "Peggy", "email": "peggy@gmail.com"} - 数组(Array):有序的值集合,以
[]包裹,元素间用逗号分隔。[{"name": "Peggy"}, {"name": "John"}]
JSON 值支持字符串、数字、布尔值(true/false)、null 以及嵌套的对象或数组。Python 中的字典(dict)与列表(list 分别对应 JSON 的对象与数组。
二、JSON 数据的读写与序列化
在 Python 中,JSON 的序列化(序列化)指将 Python 对象转换为 JSON 字符串或写入文件;反序列化(deserialization)指将 JSON 字符串或文件读取为 Python 对象。官方推荐的操作入口为 json.dumps()/json.loads() 与 json.dump()/json.load()。
第1步:读取外部 JSON 文件
目的:将磁盘上的 JSON 数据载入内存转为 Python 字典或列表。
入口:Python 脚本环境
动作:使用内置 open() 打开文件并调用 json.load()。
import simplejson as json

# 使用 open 替代废弃的 file(),显式指定编码防止乱码
with open('table.json', 'r', encoding='utf-8') as f:
    data = json.load(f)
print(data)完成状态:控制台成功输出 Python 字典或列表结构,无异常报错。
第2步:内存对象转换与格式化输出
目的:将 Python 对象转为 JSON 字符串,并通过缩进与按键排序提升可读性。
动作:调用 json.dumps() 配置参数。
# 假设已加载 data = [{'Message': '{"DescibeTableWithPartSpec": "false"}', 'Query': 'desc zt1;', 'Result': 'OK'}]
formatted_json = json.dumps(data, sort_keys=True, indent=4)
print(formatted_json)
[
{
"Message": "{\"DescibeTableWithPartSpec\": \"false\"}",
"Query": "desc zt1;",
"Result": "OK"
}
]参数说明:sort_keys=True 对字典键按字母顺序排列;indent=4 启用 4 空格缩进美化排版。
三、嵌套结构解析实战
实际业务返回的 JSON 往往包含多层嵌套。解析的核心思路是先定类型,再按索引/键名逐级提取。
import simplejson as json

# 模拟读取包含复杂结构的 data.json
with open('data.json', 'r', encoding='utf-8') as f:
    root = json.load(f)

print(type(root))  # <class 'dict'>
第3步:逐层提取字典与列表元素
- 定位目标字段:进入顶层字典的
'data'键。inner_list = root['data'] print(type(inner_list)) # <class 'list'> - 获取首个对象:列表需使用整数索引访问,取
[0]。first_item = inner_list[0] print(type(first_item)) # <class 'dict'> - 提取具体属性:通过
key获取机器机房名称。machine_location = first_item['idc'] print(machine_location) # 杭州德胜机房
操作要领:Python 解析 JSON 后,数据类型会严格映射为 dict/list/str/int/float/bool/NoneType。建议在访问深层键前使用 type() 或 in 运算符校验层级结构,避免 KeyError 或 TypeError。
四、性能对比与最佳实践
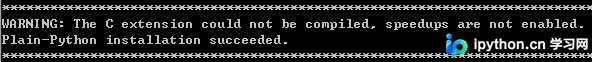
虽然 simplejson 兼容性极佳且支持部分高级特性,但在纯 Python 环境(未安装 C 编译扩展)下,其序列化为字符串的速度远低于 Python 3 自带的 json 模块。官方 json 底层默认绑定 C 加速模块,吞吐量通常高出数倍。
基准测试代码逻辑如下(计时循环 1 秒统计序列化次数):
import time
import json

test_data = {
    'name': '百合',
    'config': {'chips': 1000, 'probability': 0.5},
    'active': True
}

start_time = time.time()
count = 0
while True:
    count += 1
    _ = json.dumps(test_data)
    if time.time() - start_time >= 1:
        break

print(f"loop_num: {count}")
实测环境下,标准 json 模块每秒可处理约 3.6 万次 1KB 数据序列化,而原版 simplejson 在缺乏 C 扩展时通常不足 1500 次。建议常规开发直接采用内置 json 模块获取最高性能;仅在需要特殊编码控制、高精度浮点数或特定容错策略时,才优先考虑升级带有 Cython 编译环境的 simplejson。
总结而言,掌握 open() 流式读取、dumps()/loads() 内存交互以及层级提取逻辑,即可覆盖绝大多数 JSON 解析场景。合理评估性能开销,能够显著提升数据管道处理效率。
以上就是 Python 使用 simplejson 与 json 模块解析 JSON 的详细内容,更多关于 Python 数据处理与性能优化的资料请关注本站其它相关文章!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















