


JavaScript正则表达式基本语法详解

本文系统梳理了JavaScript中正则表达式的基础用法,从定义方式、修饰符到核心元字符、范围匹配、预定义类等语法结构进行了全面解析。文章重点阐述了如何通过贪婪模式转换、括号分组及前瞻/后顾断言来精确控制文本匹配流程,帮助开发者高效构建符合业务逻辑的字符串处理规则。
创建正则表达式与核心修饰符
正则表达式本质上是一种用于描述字符串匹配模式的模板。在JavaScript中,创建正则表达式主要有两种方式:
- 构造函数 (RegExp):适用于动态生成复杂的正则场景。
var reg = new RegExp('<%[^%>]+%>', 'g'); - 字面量 (/ /)
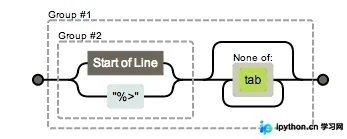
var reg = /<%[^%>]*%>/;
在编写正则时,通常结合以下修饰符来实现特定的匹配效果:
g(global):全文搜索,不会在找到第一个匹配项后就停止。i(ignore case):忽略大小写进行匹配。m(multiple lines):多行匹配模式,更改^和$的含义,使其分别在各行的开头和结尾进行匹配。
掌握元字符与字符类构建
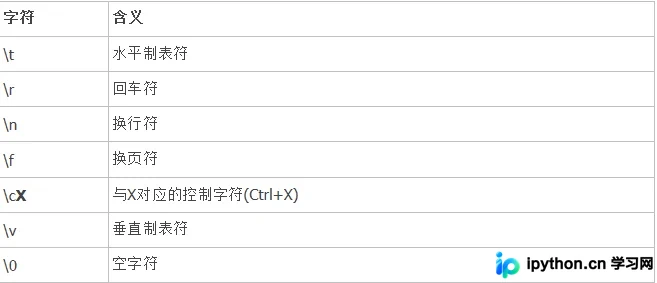
正则需要处理的特殊符号被称为元字符,其中包含大量的转义组合。常用的独立元字符包括:( [ { \ ^ $ | ) ? * + .。
1. 字符类 ([]) 与反向类
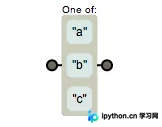
默认情况下,一个普通字符(如 a)仅匹配自身。利用方括号可以构建“类”,表示匹配括号内的任意单个字符。例如,[abc] 能够匹配 a、b 或 c。
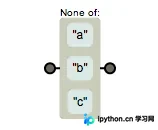
若要排除特定字符,可在左括号后添加 ^ 构成反向类。例如 [^abc] 意味着匹配除了 a、b、c 之外的所有字符。
2. 范围类 (x-y)
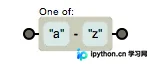
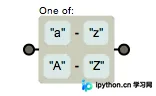
为了简化书写,正则提供了范围区间。例如,匹配全部数字无需逐个数位,使用 [0-9] 即可;匹配全部小写字母可以使用 [a-z]。如果需要包含大写和小写字母,可以直接连写为 [a-zA-Z]。
3. 预定义类
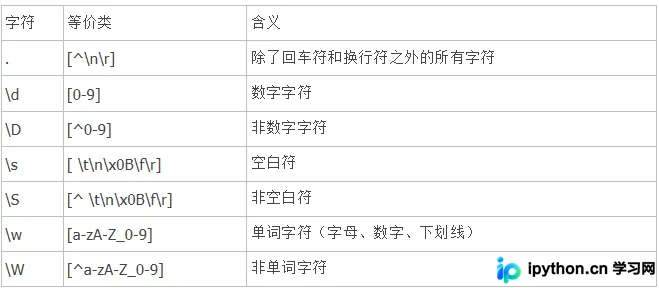
对于高频使用的字符集,JS引擎提供了便捷预定义类(如 d 代表数字,w 代表单词字符),大幅简化了代码复杂度。
边界定位与量词控制
精准的文本抓取需要严格的锚点限制与数量控制。
1. 边界匹配
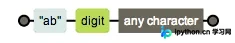
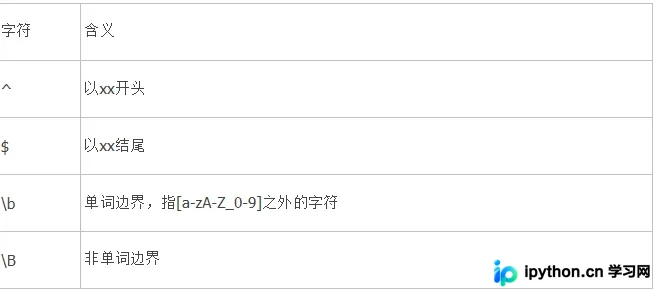
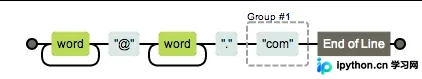
常用的边界符号包括单词边界 b 和字符串边界。在处理类似邮箱地址等结构化字符串时,正确放置边界符号至关重要。
2. 量词
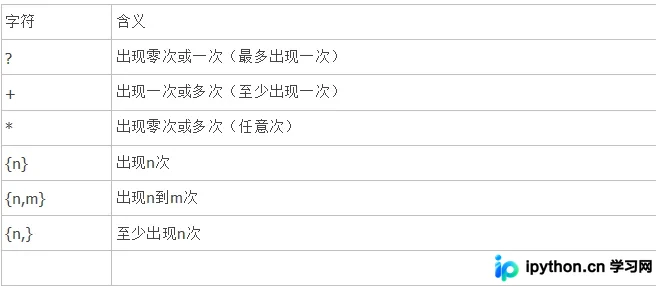
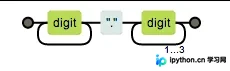
量词决定了前面的元素重复出现的次数,常见的包括 + (至少一次)、* (零次或多次) 以及 {n,m} (指定范围)。例如,匹配保留一位小数点的数字可写作 d+.d{1,2}。
3. 贪婪模式与非贪婪模式
量词在默认状态下采用贪婪模式,即尽可能多地匹配字符。例如在字符串 123456789 中使用 /d{3,5}/g 时,由于贪婪特性会优先凑齐上限,结果为 ["12345", "678"]。
'123456789'.match(/\d{3,5}/g); // 结果: ['12345', '678']
若需改为非贪婪模式(尽可能少地匹配),只需在量词后方追加问号 ?。此时正则会在满足条件后立即停止尝试。
'123456789'.match(/\d{3,5}?/g); // 结果: ['123', '456', '789']
分组捕获与前瞻断言
1. 分组 (())
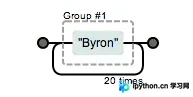
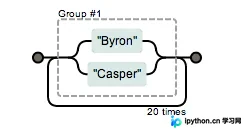
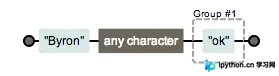
通过括号可以将多个字符视为一个整体单位进行操作。例如匹配连续出现 20 次的 Byron:((Byron){20})。如果需要在 “Byron” 或 “Casper” 之间择一匹配,可使用或运算符 |:((Byron|Casper){20})。
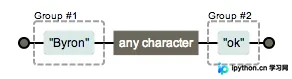
执行带有分组的正则时,捕获的内容会被自动编号。外层分组的优先级靠前。此外,如果使用 ?: (如 (?:Byron))进行分组,则该组参与整体匹配但不会产生编号返回。
2. 前瞻断言 (Lookahead & Lookbehind)
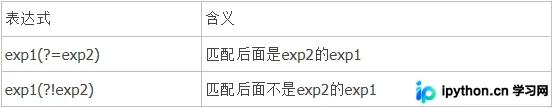
前瞻断言允许在不消耗文本的前提下检查后续内容是否符合要求:
- 正向先行断言 (Positive Lookahead):
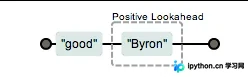
exp1(?=exp2)。只有当exp1之后的内容严格匹配exp2时,才认为exp1成功。示例:/good(?=Byron)/仅在后面紧跟 Byron 时匹配 good。 - 负向先行断言 (Negative Lookahead):
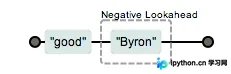
exp1(?!exp2)。只要exp1之后的内容不匹配exp2即成功。示例:/good(?!=Byron)/只要后面不是 Byron 就会匹配 good。
这两种断言在实际应用中能极大提升复杂文本过滤的灵活性。
 以上就是JavaScript正则表达式基本语法的核心内容,更多关于正则应用与优化的技术资料请关注本站其它相关文章!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















