


JavaScript 数组实现队列与堆栈及性能优化指南

在 JavaScript 开发中,利用原生 Array 方法模拟队列和堆栈是常见操作。本文总结了 push、pop、unshift 等方法的基本用法,并通过测试揭示 unshift 在高并发或大数据量场景下的性能损耗,提供基于 reverse 的优化方案。
队列与堆栈的核心概念
队列(Queue)和堆栈(Stack)是两种基础的线性数据结构,它们在操作元素进出的顺序上有本质区别:
第1步:理解队列机制 (FIFO)
队列遵循先进先出(First In First Out, FIFO)原则。最早插入的元素会最先被取出,就像现实生活中的排队叫号。
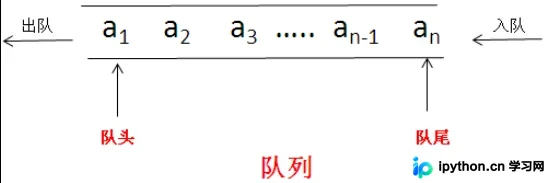
第2步:理解堆栈机制 (LIFO)
堆栈遵循后进先出(Last In First Out, LIFO)原则。最后插入的元素最先被取出,类似于叠放盘子,后放上去的只能先拿走。
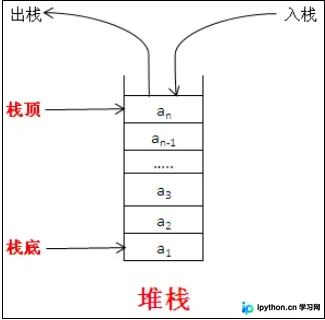
使用 JavaScript 数组实现基础结构
JavaScript 的数组对象提供了四个核心方法,足以让我们构建上述两种结构:
push():在数组末尾添加元素。pop():删除并返回数组最后一个元素。unshift():在数组开头添加元素。shift():删除并返回数组第一个元素。
第3步:实现队列逻辑
要实现队列,关键在于保证先进来的元素在最前面被移除。虽然可以直接使用 unshift 入队和 pop 出队,但在下面的示例中为了演示原理,使用了 unshift 进行入队操作:
<script type="text/javascript">
// 创建一个数组来模拟队列
var a = new Array();
console.log(a);

// 入队操作:在数组开头添加元素
console.log("入队");
a.unshift(1);
console.log(a); // [1]
a.unshift(2);
console.log(a); // [2, 1]
a.unshift(3);
console.log(a); // [3, 2, 1]
a.unshift(4);
console.log(a); // [4, 3, 2, 1]

// 出队操作:从数组末尾移除(因为先进来的在最前,需要翻转到最后移除)
console.log("出队,先进先出");
console.log(a);
console.log(a.pop()); // 输出 1
console.log(a);       // [4, 3, 2]
</script>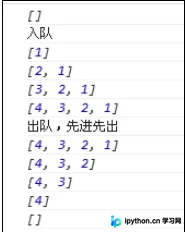
在实际工程开发中,更推荐的队列实现方式是使用 push 入队(末尾),shift 出队(头部)。
第4步:实现堆栈逻辑
要实现堆栈,即后进先出。最直观的方法是在数组末尾增加元素(push),并从数组末尾移除元素(pop)。
<script type="text/javascript">
// 创建一个数组来模拟堆栈
var a = new Array();
console.log(a);

// 入栈操作
console.log("入栈");
a.push(1);
console.log(a);        // [1]
a.push(2);
console.log(a);        // [1, 2]
a.push(3);
console.log(a);        // [1, 2, 3]
a.push(4);
console.log(a);        // [1, 2, 3, 4]

// 出栈操作:从数组末尾移除
console.log("出栈,后进先出");
console.log(a);
console.log(a.pop()); // 输出 4
console.log(a);       // [1, 2, 3]
</script>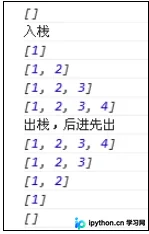
关键操作的性能差异分析
尽管 push 和 unshift 都能实现向数组添加元素,但它们的时间复杂度存在显著差异:push 的操作通常非常高效,而 unshift 每次执行时都需要将现有数组索引重新计算并偏移,当数据量大时,性能开销明显。
第5步:基准测试 - Push vs Unshift
下面通过代码验证两者在处理 100,000 次循环时的耗时差异:
<script type="text/javascript">
var arr = [];
var startTime = +new Date();
// 执行 10万次 push
for (var i = 0; i < 100000; i++) {
    arr.push(i);
}
var endTime = +new Date();
console.log("调用push方法往数组中添加10万个元素耗时" + (endTime-startTime) + "毫秒");

startTime = +new Date();
arr = [];
// 执行 10万次 unshift
for (var i = 0; i < 100000; i++) {
    arr.unshift(i);
}
endTime = +new Date();
console.log("调用unshift方法往数组中添加10万个元素耗时" + (endTime-startTime) + "毫秒");
</script>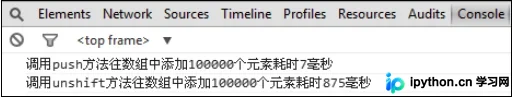
测试结果显而易见:unshift 比 push 慢约两个数量级。因此,在大数组场景中应尽量避免使用 unshift。
性能优化策略:巧用 Reverse
如果业务逻辑强制要求在数组前端插入元素,但又不想承担 unshift 的低性能,可以使用一种替代方案:先用高效的 push 按逆序插入元素,然后一次性调用 reverse() 翻转数组。
第6步:反转法优化实践
该方案的核心在于利用 reverse 方法极低的性能损耗。
<script type="text/javascript">
var a = new Array();
// 假设我们需要模拟一个需要从头取的数据流,但不希望影响整体性能
a.push(4)
a.push(3);
a.push(2);
a.push(1);

console.log("数组反转之前");
console.log(a); // [4, 3, 2, 1],此时4在最前,但如果是连续push进来的,顺序可能不对
// 这里展示标准的reverse效果
// 比如我们正确按顺序 push 1, 2, 3, 4
var tempArr = [1, 2, 3, 4];
console.log(tempArr.reverse()); // [4, 3, 2, 1]
</script>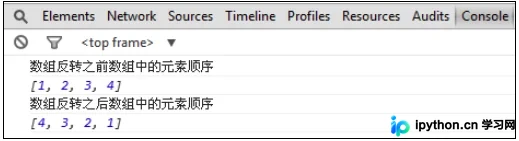
第7步:Reverse 自身的性能测试
为了确保万无一失,我们再次对 reverse 单独进行测试:
<script type="text/javascript">
var arr = [], s = +new Date;
for (var i = 0; i < 100000; i++) {
    arr.push(i);
}
arr.reverse();
console.log("调用reverse方法耗时:" + (+new Date - s) + "毫秒");
</script>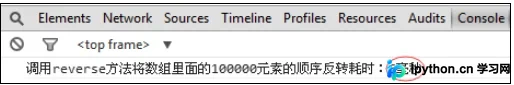
结论: reverse 的执行速度极快,接近纯内存操作。结合 push 和 reverse 是实现高性能“前端插入”需求的优选方案。
总结
通过本文的梳理,我们掌握了在 JavaScript 中利用 push、pop、unshift、shift 实现标准队列和堆栈的方法。同时明确了在生产环境中应当警惕 unshift 带来的性能陷阱,善用 reverse 进行架构层面的微调。
以上就是在javascript中通过数组来实现队列和堆栈并分析相关方法性能的详细内容,更多关于js数据结构与算法优化的资料请关注本站其它相关文章!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















