


Python浅拷贝与深拷贝机制解析

本文深入解析Python中浅拷贝与深拷贝的核心机制。通过代码示例说明,浅拷贝仅复制外层容器及内部不可变对象的引用,可变对象仍共享内存地址;深拷贝则递归创建新对象。文章对比了切片、list()与copy.deepcopy()的实现差异,并解释了不可变类型在两种拷贝中的内存优化策略。
在探讨浅拷贝与深拷贝的具体概念之前,我们先观察一个具体的代码现象:
a = ['scolia', 123, [], ]
b = a[:]
b[2].append(666)
print a
print b
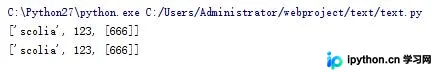
为什么仅仅对变量b进行了修改,却导致变量a的内容也发生了改变?正如我之前在文章中提到的:Python序列中存储的实际上是内存地址的引用。
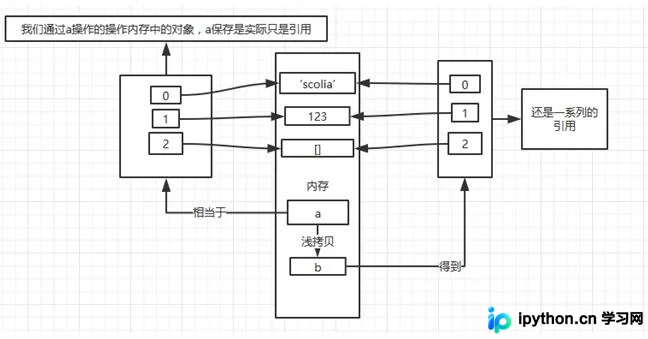
因此,当我们通过b去修改其内部包含的空列表时,实际上是在修改内存中同一个对象,这自然会影响到了变量a。
a = ['scolia', 123, [], ]
b = a[:]
print id(a), id(a[0]), id(a[1]), id(a[2])
print id(b), id(b[0]), id(b[1]), id(b[2])
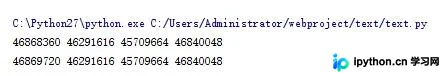
代码验证结果确认无误:尽管a和b是两个独立的对象实例,但它们内部包含的引用指向的是相同的内存地址。这就是所谓的“新对象,旧内容”现象。
然而,浅拷贝的行为并不止于此,请看下面的情况:
a = ['scolia', 123, [], ]
b = a[:]
b[1] = 666
print a
print b
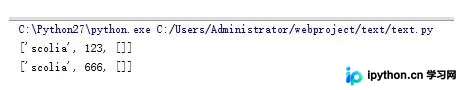
这又是如何发生的呢?
阅读过我之前关于Python变量赋值说明的读者应该知道:对于字符串、数字等不可变数据类型,修改操作实际上等同于重新赋值。在这里,这相当于刷新了引用指向。
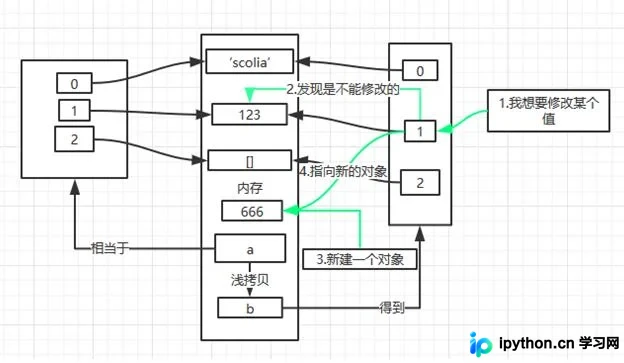
让我们通过代码来验证这一点:
a = ['scolia', 123, [], ]
b = a[:]
b[1] = 666
print id(a), id(a[0]), id(a[1]), id(a[2])
print id(b), id(b[0]), id(b[1]), id(b[2])
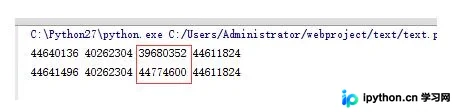
结果显示符合预期。
上述内容即为浅拷贝的总结:浅拷贝仅复制了一系列引用。当我们对拷贝出的对象中的可变数据类型进行修改时,并未改变该可变对象的引用,因此会影响原对象;而对不可变对象进行修改时,则是新建了对象并刷新了引用,因此与原对象的引用不同,结果也随之不同。
创建浅拷贝的方法主要有:
1. 使用切片操作
2. 使用list()工厂函数新建对象(例如:b = list(a))
那么,深拷贝是否就是将内部引用的对象重新创建一遍,并生成一系列新的引用呢?
大体上是这样,但对于字符串、数字等不可变对象而言,重新创建一份似乎有些浪费内存。既然在修改时总会新建对象并刷新引用,那么保留原来的引用也无妨,这还能达到节省内存的目的。
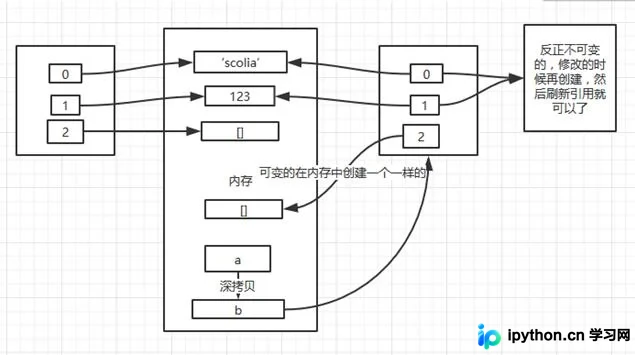
下面通过代码进行验证:
from copy import deepcopy
a = ['scolia', 123, [], ]
b = deepcopy(a)
b[1] = 666
print id(a), id(a[0]), id(a[1]), id(a[2])
print id(b), id(b[0]), id(b[1]), id(b[2])
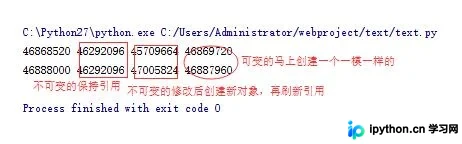
验证结果正确。
深拷贝的创建方式:
1. 正如代码示例所示,只能通过内置的copy模块中的deepcopy()方法来创建。
关于深浅拷贝的问题就先讨论到这里,如果发现错误或需要补充的地方,以后会继续更新。
以上这篇深入理解Python中的浅拷贝和深拷贝就是小编分享给大家的全部内容了,希望能给大家一个参考,也希望大家多多支持本站。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















