


C# 使用正则表达式提取 HTML 纯文本

在 C# Web 或后端开发场景中,常需从 HTML 富文本中提取纯文字内容。通过 System.Text.RegularExpressions 库中的正则替换机制,可按顺序剔除 JavaScript、CSS 样式块及所有 HTML 标记,并清理冗余空格与异常引用符,最终输出整洁的字符串。
准备工作
本示例基于标准 .NET Framework 或 .NET Core/5+ 环境,依赖 using System.Text.RegularExpressions; 命名空间。无需额外安装第三方 NuGet 包(如 AngleSharp),适用于简单的轻量级文本抓取需求。
执行步骤
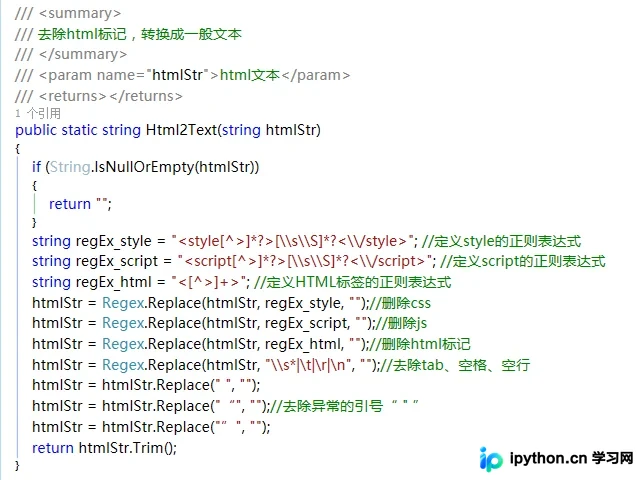
第1步:构建基础方法框架
创建一个静态辅助类方法 Html2Text,接收 HTML 字符串作为输入参数。首先进行非空判断,若输入为空则直接返回空字符串,以节省无效计算资源。
第2步:剔除内联样式表与脚本块
在处理前,优先移除可能包含敏感数据或干扰阅读的 <style> 和 <script> 块及其内部内容。
- 定义
regEx_style匹配<style[^>]*?>[\s\S]*?</style>。 - 定义
regEx_script匹配<script[^>]*?>[\s\S]*?</script>。 - 调用
Regex.Replace将这些区域替换为空。
第3步:剥离所有 HTML 标签
使用 regEx_html = "<[^>]+>" 匹配任意尖括号内的内容并删除,确保只留下可见的文本节点。
第4步:清洗空白字符
执行 Regex.Replace(htmlStr, "\\s*|\t|\r|\n", ""),批量删除换行符、制表符及普通空格。随后再次替换连续的空格,防止部分排版残留。
第5步:标准化与去重特殊符号
由于不同来源的 HTML 可能混用直引号(")与 HTML 实体编码引号(”),通过链式 Replace 清除异常的引号字符,最后调用 Trim() 去除首尾空格。
public static string Html2Text(string htmlStr)
{
    if (String.IsNullOrEmpty(htmlStr))
    {
        return "";
    }
    // 定义各部分的正则表达式模式
    string regEx_style = "<style[^>]*?>[\\s\\S]*?</style>";
    string regEx_script = "<script[^>]*?>[\\s\\S]*?</script>";
    string regEx_html = "<[^>]+>";

    // 依次执行替换操作
    htmlStr = Regex.Replace(htmlStr, regEx_style, ""); // 1. 删除 CSS
    htmlStr = Regex.Replace(htmlStr, regEx_script, ""); // 2. 删除 JS
    htmlStr = Regex.Replace(htmlStr, regEx_html, "");   // 3. 删除 HTML 标记

    // 4. 去除各类空白符(含 tab、回车、换行)
    htmlStr = Regex.Replace(htmlStr, "\\s*|\t|\r|\n", "");
    htmlStr = htmlStr.Replace(" ", ""); // 清理剩余空格

    // 5. 针对某些乱码或异常编码的引号进行清洗
    htmlStr = htmlStr.Replace("\"", "");
    htmlStr = htmlStr.Replace("‘", "").Replace("’", "");

    return htmlStr.Trim();
}
排错与建议
关于 Unicode 标点符号:代码中涉及的特殊引号替换逻辑可能因编辑器或源文件编码(如 UTF-8 vs GBK)显示不同。如果运行后发现特定引号未被清理,请检查源码文件实际保存的字节表示,并确保 Replace 中使用的是原始可视字符。
性能考量:该方法对简单结构网页速度较快,但若需解析复杂的嵌套 DOM 树,正则替换在复杂场景下可能存在遗漏,建议引入专业的 HTML 解析库(如 CsQuery 或 HtmlAgilityPack)。
以上就是C#使用正则表达式过滤html标签提取纯文本的详细内容,更多关于C#正则处理与前端格式清洗的资料请关注本站其它相关文章!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















