


Python内存管理机制详解:引用计数与垃圾回收

梳理Python对象的存储原理,解析引用计数的工作原理、整数与短字符串缓存特性,以及容器对象如何保存引用。深入探讨循环引用导致的内存滞留问题及底层探测算法,最后说明基于分配差值的GC触发阈值与分代回收机制的实际运作流程。
Python对象的引用与内存存储
Python作为动态类型的语言,核心设计原则是对象与引用分离。赋值语句如 a = 1 并不会直接创建新的数字实体,而是创建一个名为 a 的引用,使其指向内存中已存在的整数对象 1。这种机制类似于使用工具(引用)去操作实物(对象)。
借助内置函数 id() 可以获取对象的身份标识,即该对象在内存中的地址。该函数返回十进制数值,可通过 hex(id()) 转换为十六进制格式便于核对。为验证引用与对象的对应关系,可使用 is 关键字判断两个引用是否指向同一块内存地址:
# 小整数与短字符串会被解释器缓存,共享同一对象
a = 1
b = 1
print(a is b)  # 输出 True

a = "good"
b = "good"
print(a is b)  # 输出 True

# 长字符串未缓存,创建独立对象
a = "very good morning"
b = "very good morning"
print(a is b)  # 输出 False
上述逻辑同样适用于可变容器。无论列表还是字典,通过赋值操作生成的始终是新的引用指向同一实例。若需创建完全独立的副本,必须调用拷贝方法而非简单赋值。
引用计数规则与容器对象关联
Python维持内存状态的基础是引用计数(Reference Count)。每个对象内部维护一个计数器,记录当前有多少引用正指向它。当新建对象分配给新变量时,计数加一;当变量被重新赋值或销毁时,计数减一。
容器对象(如列表、字典)内部并不直接存储元素本身,而是存储指向这些元素的引用。自定义类继承基础对象后,其属性同样以引用形式保存外部对象:
class Container:
    def __init__(self, target):
        self.target = target

external_list = [1, 2, 3]
container = Container(external_list)
# container.target 与 external_list 指向同一内存地址
print(id(container.target) == id(external_list))  # 输出 True
监控引用计数的标准做法是使用 sys.getrefcount()。需注意该函数调用机制:当引用作为参数传入时,Python会在栈帧内临时创建一个新的参数引用,导致返回值比预期值大 1。因此对比多次调用结果时,应关注相对变化量而非绝对值:
from sys import getrefcount

list_ref = [1, 2, 3]
print(getrefcount(list_ref))  # 初始状态通常为 2(全局变量引用+参数临时引用)

new_ref = list_ref
print(getrefcount(list_ref))  # 引用增加,结果为 3
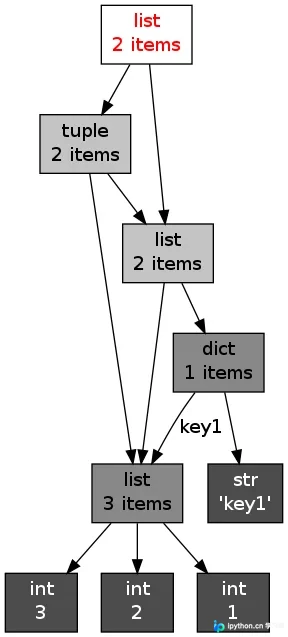
对于结构复杂的嵌套引用,建议安装第三方库 objgraph 进行可视化排查。系统环境需预先准备图形绘制依赖:sudo apt-get install xdot | sudo pip install objgraph
循环引用检测与垃圾回收触发
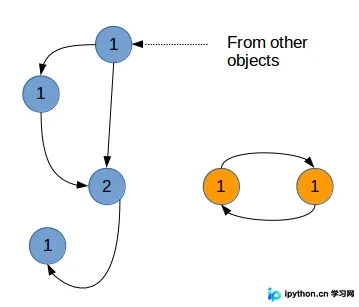
当多个对象相互持有引用时,会形成引用环(Reference Cycle)。即使切断所有外部入口,环内对象的引用计数依然不为零,传统引用计数法无法释放这部分内存。例如以下代码构建的双向闭环:
a = []
b = [a]
a.append(b)
del a
del b
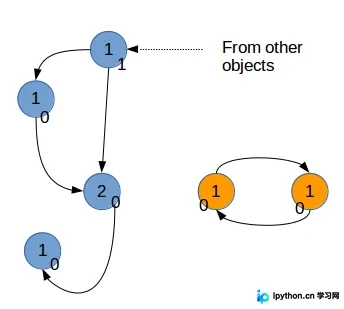
# 此时无任何外部变量可访问这两个列表,但它们的引用计数均为 2为解决此问题,Python垃圾回收模块(gc)会定期运行循环检测算法。该算法通过复制并递减遍历过程中遇到的引用数,最终仅对剩余计数大于零的对象链保留,其余标记为可回收。执行流程如下:
在触发回收之前,Python首先依赖对象分配与撤销次数的差值进行决策。通过 gc.get_threshold() 可查看当前配置,默认输出元组结构如 (700, 10, 10)。当活跃对象累计数超过第一阈值时,系统将暂停常规任务执行扫描周期。生产环境中频繁触发全量扫描将造成明显卡顿,建议在压测后按需调整:
import gc

# 查询当前阈值配置
print(gc.get_threshold())  # 示例输出: (700, 10, 10)

# 强制触发一次完整清理(含循环检测)
removed_count = gc.collect()
分代回收策略与调优方法
全量扫描开销较高,因此现代Python引入分代回收(Generational Garbage Collection)机制。核心假设是:存活时间越久的对象,未来变为垃圾的概率越低。系统按生命周期将对象划分为三代(Generation 0、1、2):
- 第0代(Gen 0):所有新创建的对象默认归入此代。每次垃圾回收必定全盘扫描 Gen 0。
- 第1代(Gen 1):经历指定次数 Gen 0 清理后仍存活的对象晋升至 Gen 1。Gen 1 清理频率受第二个阈值控制。
- 第2代(Gen 2):长期存活的“长寿”对象归入此代。扫描频率最低,由第三个阈值决定。
参数配置直接映射上述分级逻辑。修改阈值可平衡内存利用率与CPU消耗。由于 gc.collect() 属于阻塞操作,涉及大规模数据处理的脚本中建议结合事件循环或后台线程调度:
# 调整回收频率:每 700 次分配触发基础扫描
# Gen 0 每 10 次清理触发 1 次 Gen 1 清理
# Gen 1 每 5 次清理触发 1 次 Gen 2 清理
gc.set_threshold(700, 10, 5)
以上就是Python内存管理机制的详细内容,更多关于Python语言特性与性能优化的资料请关注本站其它相关文章!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















