


C++哈夫曼树构建、编码与译码原理及实现

发布时间:2026-10-14 |
4人浏览过
哈夫曼树是带权路径长度最短的二叉树,广泛应用于数据压缩领域。本文将剖析如何使用 C++ 从零构建哈夫曼树,掌握根据权值生成前缀编码表的算法逻辑,并演示如何通过遍历树结构将二进制编码序列还原为原始文本。
哈夫曼树的构建原理
哈夫曼树(Huffman Tree),又称最优二叉树,是指在一棵包含 n 个叶子结点的二叉树中,其带权路径长度(WPL)达到最小。构建的核心思想是贪心算法:每次从候选集合中选取两个权值最小的结点,合并为一个新结点,直至剩余只有一个根结点。
第1步:初始化与选择策略
在进行建树前,需要确定结点的结构。通常使用一个包含权值(weight)、双亲下标(parent)、左右孩子下标(lchild, rchild)的结构体来静态或动态分配内存。假设有 n 个字符,最终树共有 2n-1 个结点。
- 目的:定位当前未被合并的最小权值结点。
- 操作:编写
Select函数,在parent == 0的未连接结点中,找出权值最小的两个下标s1和s2。注意这两个结点必须互不相同且从未参与过合并。
第2步:循环合并构造树
这是算法的关键阶段,需执行 n-1 次循环:
- 入口:初始时叶子结点占用了
1~n的下标。 - 动作:调用
Select找到最小两结点s1,s2;设定当前新结点的下标为i(从n+1开始)。设置HT[s1].parent = i,HT[s2].parent = i,并将HT[i]的左右孩子分别指向s1和s2,新结点权值为二者之和。 - 完成状态:当循环结束,下标
2n-1处即为根结点,整棵树构建完毕。
哈夫曼编码表的生成
编码遵循前缀编码原则,即任意一个字符的编码都不是另一个字符编码的前缀。由于哈夫曼树结构天然满足这一条件,编码过程是从叶子出发向上回溯。
第3步:逆向求取编码
- 目的:为每个叶子结点生成对应的
0/1二进制串。 - 操作:对于第
i个字符,从其自身下标开始,沿parent域向根结点回溯。若当前结点是父结点的左孩子,则记录'0';若是右孩子,则记录'1'。 - 细节:由于是倒着生成的,需定义一个临时缓冲区。从最低位开始填充,到达根结点后,将有效段复制到最终的编码表中。
哈夫曼译码过程解析
译码是编码的逆过程。给定一串二进制序列,将其还原为原始字符序列,关键在于如何在树中准确判定“读完一个字符”。判断依据是是否到达了叶子结点(左右孩子均为空或0)。
第4步:序列遍历与还原
- 准备:指针
q初始指向根结点(下标2n-1)。 - 动作:逐个读取二进制序列中的字符。
- 若读到'0',q移至HT[q].lchild;
- 若读到'1',q移至HT[q].rchild。 - 完成判断:每当
q移动到某个位置时,检查该位置是否为叶子结点(lchild == 0 && rchild == 0)。如果是,说明译出了一个完整字符,输出该字符(通过查找原字符数组获取对应字符内容),并将q重置回根结点,继续处理下一段编码,直到序列结束。
/***************************************
目的:1.根据输入的字符代码集及其权值集,
构造赫夫曼树,输出各字符的赫夫曼编码
2.输入赫夫曼码序列,输出原始字符代码
作者:Dmego  时间:2016-11-11
****************************************/
#include<iostream>
#define MAX_MA 1000
#define MAX_ZF 100
using namespace std;

//哈夫曼树的储存表示
typedef struct
{
 int weight; //结点的权值
 int parent, lchild, rchild;//双亲,左孩子,右孩子的下标
}HTNode,*HuffmanTree;

//哈夫曼编码表的储存表示
typedef char **HuffmanCode;

//返回两个双亲域为0且权值最小的点的下标
void Select(HuffmanTree HT, int n, int &s1, int &s2)
{
 // 寻找最小的点s1
 for (int i = 1; i <= n; i++)
 {
  if (HT[i].parent == 0)
  {
   s1 = i;
   break;
  }
 }
 for (int i = 1; i <= n; i++)
 {
  if (HT[i].weight < HT[s1].weight && HT[i].parent == 0)
   s1 = i;
 }

 // 寻找第二小的点s2
 for (int i = 1; i <= n; i++)
 {
  if (HT[i].parent == 0 && i != s1)
  {
   s2 = i;
   break;
  }
 }
 for (int i = 1; i <= n; i++)
 {
  if (HT[i].weight < HT[s2].weight && HT[i].parent == 0 && i!= s1)
   s2 = i;
 }
}

//构造哈夫曼树
void CreateHuffmanTree(HuffmanTree &HT, int n)
{
 if (n <= 1) return;
 int m = 2 * n - 1;
 HT = new HTNode[m + 1];
 for (int i = 1; i <= m; ++i)
 {
  HT[i].parent = 0; HT[i].lchild = 0; HT[i].rchild = 0;
 }
 for (int i = 1; i <= n; ++i)
 {
  cin >> HT[i].weight;
 }
 int s1,s2;
 for (int i = n + 1; i <= m; ++i)
 {
  Select(HT, i - 1, s1, s2);
  HT[s1].parent = i;
  HT[s2].parent = i;
  HT[i].lchild = s1;
  HT[i].rchild = s2;
  HT[i].weight = HT[s1].weight + HT[s2].weight;
 }
}

//从叶子到根逆向求每个字符的哈夫曼编码
void CreatHuffmanCode(HuffmanTree HT, HuffmanCode &HC, int n)
{
 HC = new char*[n + 1];
 char *cd = new char[n];
 cd[n - 1] = '\0';
 for (int i = 1; i <= n; i++)
 {
  int start = n - 1;
  int c = i;
  int f = HT[c].parent;
  while (f != 0)
  {
   --start;
   if (HT[f].lchild == c) cd[start] = '0';
   else cd[start] = '1';
   c = f;
   f = HT[f].parent;
  }
  HC[i] = new char[n - start];
  strcpy(HC[i], &cd[start]);
 }
 delete cd;
}

//哈夫曼译码
void TranCode(HuffmanTree HT,char a[],char zf[],char b[],int n)
{
 int q = 2*n-1;
 int k = 0;
 int i = 0;
 for (i = 0; a[i] != '\0';i++)
 {
  if (a[i] == '0')
  {
   q = HT[q].lchild;
  }
  else if (a[i] == '1')
  {
   q = HT[q].rchild;
  }

  if (HT[q].lchild == 0 && HT[q].rchild == 0)
  {
   b[k++] = zf[q];
   q = 2 * n - 1;
  }
 }
 b[k] = '\0';
}

void menu()
{
 cout << endl;
 cout << "  ┏〓〓〓〓〓〓〓〓〓〓〓〓〓〓〓〓〓〓〓〓〓〓〓〓〓〓〓〓〓┓" << endl;
 cout << "  ┃ ★★★★★★★哈夫曼编码与译码★★★★★★★  ┃" << endl;
 cout << "  ┃     1. 创建哈夫曼树      ┃" << endl;
 cout << "  ┃     2. 进行哈夫曼编码      ┃" << endl;
 cout << "  ┃     3. 进行哈夫曼译码      ┃" << endl;
 cout << "  ┃     4. 退出程序       ┃" << endl;
 cout << "  ┗〓〓〓〓〓〓〓〓〓〓〓〓〓〓〓〓〓〓〓〓〓〓〓〓〓〓〓〓〓┛" << endl;
 cout << "      <><注意:空格字符用'- '代替><>" << endl;
 cout << endl;
}

int main()
{
 int falg;
 char a[MAX_MA];
 char b[MAX_ZF];
 char zf[MAX_ZF];
 HuffmanTree HT = NULL;
 HuffmanCode HC = NULL;
 menu();
 while (true)
 {
  int num;
  cout << "<><请选择功能(1-创建 2-编码 3-译码 4-退出)><>: ";
  cin >> num;
  switch (num)
  {
  case 1 :
   cout << "请输入字符个数:";
   cin >> falg;
   cout << "请依次输入" << falg << "个字符:";
   for (int i = 1; i <= falg; i++)
    cin >> zf[i];
   cout << "请依次输入" << falg << "个字符的权值: ";
   CreateHuffmanTree(HT, falg);
   cout << "创建成功!参数如下:\n结点	字符	权值	双亲	左孩子	右孩子\n";
   for (int i = 1; i <= falg * 2 - 1; i++)
   {
    cout << i << "\t" << zf[i] << "\t" << HT[i].weight << "\t" << HT[i].parent << "\t" << HT[i].lchild << "\t" << HT[i].rchild << endl;
   }
   break;
  case 2:
   CreatHuffmanCode(HT, HC, falg);
   cout << "生成编码表:\n结点	字符	权值	编码\n";
   for (int i = 1; i <= falg; i++)
   {
    cout << i << "\t" << zf[i] << "\t" << HT[i].weight << "\t" << HC[i] << endl;
   }
   break;
  case 3:
   cout << "请输入想要翻译的一串二进制编码:";
   cin >> a;
   TranCode(HT, a, zf, b, falg);
   cout << "译码结果为:" << b << endl;
   break;
  case 4:
   exit(0);
  default:
   break;
  }
 }
}
代码运行效果验证
在实际应用中,可以通过标准测试用例(如常见的字母权重 A-Z)来验证算法的正确性。下图展示了完整的操作流程,从建立权重树模型,到生成对应的编码映射表,再到输入编码序列进行实时解密的过程。
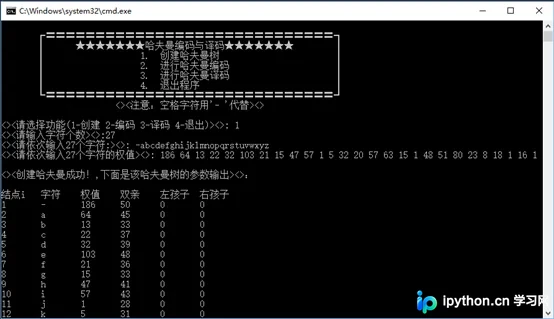 上图显示了程序的交互界面与基础配置选项,用户可在此阶段输入具体的字符及其对应的出现频率(权值),系统随后会在内部构建出结构化的哈夫曼树模型。
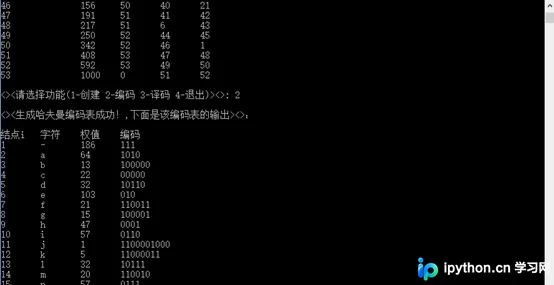 此处展示的是算法核心执行结果之一:生成的哈夫曼编码表。我们可以直观地观察到不同权重的字符被分配了长短不一的二进制串,确保高频字符拥有更短的编码路径,从而体现压缩效率。
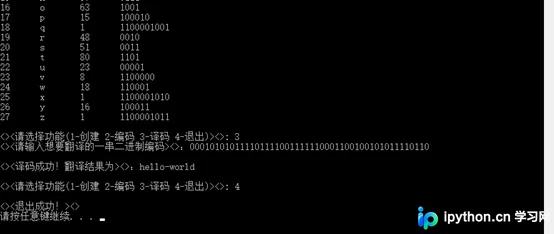 最后一张图演示了译码环节。将上一步生成的编码串作为输入,程序准确地逐层匹配并输出了原始字符序列,证明了从二叉树逆向检索逻辑实现的正确性与鲁棒性。
以上就是 C++ 哈夫曼树编码译码的详细内容,更多关于哈夫曼树应用与数据结构设计的资料请关注本站其它相关文章!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















