


Jupyter Notebook 导出 PDF 并完美支持中文的操作指南

直接通过 Jupyter 界面导出 PDF 时常出现中文乱码或丢失。本文介绍使用命令行结合 XeLaTeX 引擎的标准工作流:安装 LaTeX 环境后,通过 jupyter nbconvert 生成 .tex 文件,仅需修改文档类为 ctexart 或引入 ctex 宏包,再运行 xelatex 编译即可输出排版规范且完整保留中文的 PDF 文档。
直接导出的局限与核心解决思路
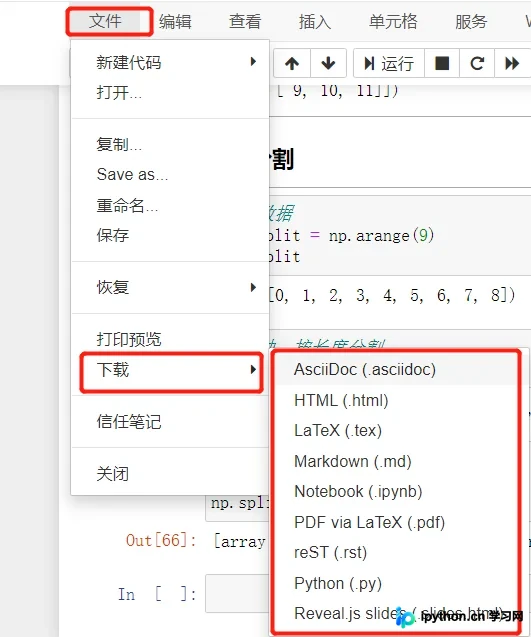
Jupyter Notebook 内置的 File → Download as → PDF via Latex (.pdf) 功能在底层依赖默认的 LaTeX 模板,该模板默认不支持中文字体映射,直接点击导出会导致中文字符全部空白或报错。要稳定生成包含中文的 PDF,需绕开前端一键下载,改为后台通过命令行调用完整的 LaTeX 编译链(XeLaTeX + ctex 宏包),以此实现完美的字符渲染与排版。
环境准备与注意事项
在执行转换前,需确保操作系统已安装轻量级 LaTeX 发行版(如 Windows 下的 MiKTeX 或跨平台的 TeX Live)。MiKTeX 安装包约 190MB,安装过程需联网下载基础组件,耗时较长,安装完成后请确认系统环境变量已自动配置。重要提醒: 生成过程中会覆盖临时生成的 .tex 中间文件,建议在操作前备份原始 .ipynb 数据,避免因意外中断导致笔记丢失。
第1步:定位文件路径并生成 Latex 源码
目的: 将 Jupyter 笔记本的结构、代码块及 Markdown 文本转换为原生 LaTeX 格式,便于后续注入中文渲染指令。
操作入口: 终端 / CMD / PowerShell
具体动作: 使用 cd 命令切换至待转换的 Jupyter 文件所在目录,随后输入编译指令。将 yourNotebookName.ipynb 替换为实际文件名:
jupyter nbconvert --to latex yourNotebookName.ipynb可观察的完成状态: 终端显示 [NbConvertApp] Writing X bytes to yourNotebookName.tex,表示同目录下已成功生成对应的 .tex 源文件。
第2步:手动配置 Tex 文件的中文渲染环境
目的: 告知 LaTeX 编译器使用 XeLaTeX 字体特性,并加载处理中文排版的 ctex 宏包,解决默认英文字体无法识别汉字的问题。
操作入口: 任意文本编辑器(推荐 VS Code、Sublime Text 或 Notepad++)
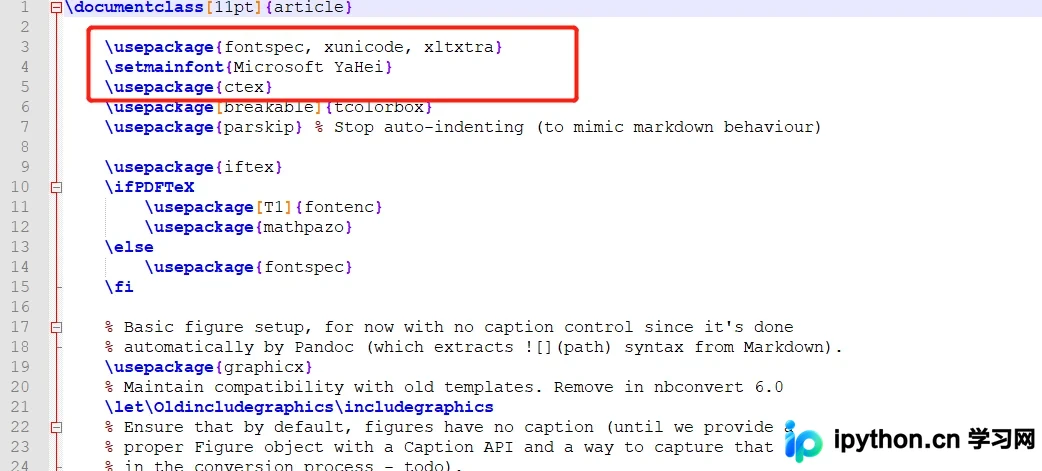
具体动作: 打开刚生成的 .tex 文件,找到第一行的文档类声明语句。此处提供两种等效配置方式,任选其一即可:
- 方案 A(推荐): 直接将第一行修改为:
\documentclass[UTF8]{ctexart} - 方案 B: 保持原有
\documentclass[11pt]{article}不变,在其正下方插入一行:\usepackage[UTF8]{ctex}
修改完成后保存文件。现代 LaTeX 环境会自动适配系统的微软雅黑或思源宋体等常用中文字库,无需手动指定字体路径。
第3步:调用 xelatex 引擎进行双次编译
目的: 启动支持 Unicode 字符集的 XeLaTeX 编译器,解析修正后的 LaTeX 源码并生成 PDF 页面布局。
操作入口: 终端 / CMD / PowerShell(需保持在与 .tex 文件相同的目录)
具体动作: 输入编译命令并回车执行。同样请将 yourNotebookName 替换为实际文件名:
xelatex yourNotebookName.tex重要参数说明: 首次运行结束后,控制台通常会提示需要重新编译以生成准确的目录索引或交叉引用。此时只需在同一终端再次键入并执行完全相同的 xelatex yourNotebookName.tex 命令,即可完成全部排版构建。
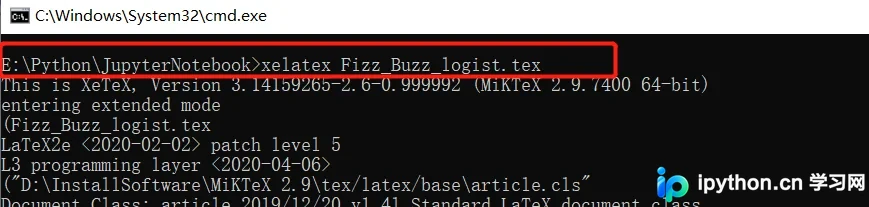
可观察的完成状态: 终端最后一行显示 Output written on yourNotebookName.pdf,即表示转换彻底完成。
完成状态判断与常见排错
编译全部完成后,当前文件夹内会生成同名 .pdf 文件。双击打开核对以下内容以验证转换成功:
- Markdown 段落、公式与代码注释中的汉字是否清晰显示且无缺字方块。
- 代码块语法高亮与数学公式(若启用 MathJax)是否保持原始样式。
- 若仍出现警告
Font shape 'OTF' undefined,通常意味着系统缺少对应字体文件或 LaTeX 版本过旧。此时可尝试将\documentclass[UTF8]{ctexart}中的UTF8参数去掉,仅保留\documentclass{ctexart}重试。
总结
借助 jupyter nbconvert 剥离前端限制,配合 XeLaTeX 引擎与 ctex 宏包的组合拳,能够彻底解决 Jupyter Notebook 导出 PDF 时中文丢失的痛点。该流程不依赖图形界面的不稳定按钮,参数明确、执行路径固定,适合需要批量生成规范报告或归档实验记录的数据分析与科学计算场景。以上就是 Jupyter Notebook 导出 PDF 并完美支持中文的详细内容,更多关于 Python 数据工具链自动化处理的资料请关注本站其它相关文章!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















