


Python使用sklearn实现Kmeans聚类与数据划分

面对缺乏明确类别标签的数据集,如何利用距离度量将样本划分为高内聚的子群?本文以Kmeans聚类为例,详解无监督学习的理论边界、K值选取策略、数据规范化要求及基于Python与sklearn的完整代码实现。通过惯性指标追踪与肘部法则,快速定位最优簇数,输出可直接复用的分组脚本与可视化结论。
利用Kmeans实现无监督数据划分目标
聚类分析属于典型的无监督学习方法,其核心目标是将数据集划分成若干子集(簇),使得簇内样本彼此相似,而簇间样本差异明显。该方法无需预先提供类别标注或指定簇的数量,广泛应用于数据探索、群组细分与离群点检测。
在主流分类体系中,划分方法依赖距离度量生成互斥簇,通常用均值或中心点代表簇中心,对中小规模球状分布数据表现优异。层次法侧重树状分解,密度法擅长处理任意形状簇,网格法则依赖多分辨率结构加速计算。Kmeans作为划分法的代表,凭借低时间复杂度与线性可分特性成为基础工具。
第1步:明确划分条件与距离计算准备
执行Kmeans前需确认两项关键前置条件:
- K值设定:表示预期生成的簇数量。实际业务多将其作为特征提取或预处理环节,K值不宜过大。通常采用枚举法结合业务经验确定。
- 量纲统一:算法默认使用欧氏距离衡量样本相似度。当特征维度跨越不同数量级时(如数值型与比例型混合),小数级特征会被高数量级特征主导。必须在计算前将所有维度缩放到相近区间(如[0,1]或标准正态分布),否则聚类结果会严重偏离预期。
算法代价函数采用误差平方和(SSE):J = Σ||X_i - μ_c||²。该函数呈非凸形态,只能保证收敛至局部最优。因此实践中常多次随机初始化运行,对比各次输出的惯性值(Inertia)并保留最小者。
第2步:编写环境配置与核心训练代码
以下脚本基于Python 3与scikit-learn封装逻辑,兼容现代运行环境。核心入口为from sklearn.cluster import KMeans,负责自动完成质心迭代与样本分配。
import numpy as np
import matplotlib.pyplot as plt
from sklearn.cluster import KMeans

def train_kmeans(filepath):
    # 读取数据并解析为二维数组
    raw_data = []
    with open(filepath, 'r', encoding='utf-8-sig') as f:
        for line in f.readlines():
            cols = line.strip().split('\t')
            # 仅作演示:将原始两列映射至统一量纲区间
            normalized = [
                float(cols[0]) / 1.99759326,
                (float(cols[1]) - 100) / 192230
            ]
            raw_data.append(normalized)

    dataSet = np.array(raw_data)
    sse_records = []
    mark_styles = ['or','ob','og','ok','^r','+r','sr','dr','<r','pr']
    center_styles = ['Dr','Db','Dg','Dk','^b','+b','sb','db','<b','pb']

    # 枚举K值范围并拟合模型
    for k in range(2, 10):
        clf = KMeans(n_clusters=k, random_state=42, n_init=10)
        clf.fit(dataSet)

        # 记录SSE并绘制样本散点
        sse_records.append(clf.inertia_)
        plt.figure()
        for i in range(len(dataSet)):
            plt.plot(dataSet[i][0], dataSet[i][1], mark_styles[clf.labels_[i]])
        for i in range(k):
            plt.plot(clf.cluster_centers_[i][0], clf.cluster_centers_[i][1],
                     center_styles[i], markersize=12)
        plt.title(f'Clusters = {k}')
        plt.show()

    # 单独绘制SSE随K值变化曲线
    xs = list(range(2, 10))
    plt.plot(xs, sse_records, 'bo-')
    plt.xlabel('Number of Clusters (K)')
    plt.ylabel('Inertia (SSE)')
    plt.title('Elbow Method for Optimal K')
    plt.grid(True)
    plt.show()

if __name__ == '__main__':
train_kmeans('your_dataset.tsv')代码已移除过时的编码重载语句。文件读取时注意根据实际分隔符调整split()参数。模型内部默认启用k-means++初始化策略,大幅降低陷入劣质局部解的概率。
第3步:执行迭代并输出可视化结果
运行脚本后,程序将按设定步长自动生成多组聚类散点图与全局SSE折线图。完成状态可通过以下现象核对:
- 控制台打印各K值对应的Inertia数值,且整体呈下降趋势。
- 散点图中同色标记点空间聚集,颜色块之间无明显交错重叠。
- 质心符号位置稳定落在高密度区域几何中心。
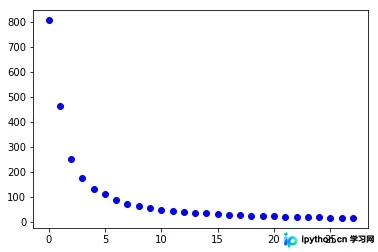
观察上图可见,曲线斜率在特定K值处出现明显拐点(肘部)。该点对应的簇数通常能在保留细节与信息压缩率之间取得较好平衡,可直接作为业务分层参考。
SSE曲线分析与异常排查
经典Kmeans对初始质心敏感且难以识别非凸形状簇。若执行后出现以下情况,可按依据调整:
- 结果分裂或粘连过度:检查原始数据是否未做标准化。跨数量级特征必须使用
sklearn.preprocessing.MinMaxScaler等预处理管道统一缩放过再输入模型。 - Inertia始终高位震荡:说明数据本身不存在自然聚集结构,或K值超出合理范围。可尝试缩小枚举区间,或切换至DBSCAN等基于密度的算法。
- 孤立噪点拉偏质心:少量极端值会显著改变均值。建议先截取分位数剔除极端离群点,或采用K-medoids类对噪声鲁棒性更强的变体。
若需进一步提升稳定性,可采用二分Kmeans策略:先全量合并为一簇,每次选择SSE降幅最大的子簇继续分割,直至达到目标K值,从而绕过单次随机初始化导致的次优陷阱。
核心要点总结
Kmeans凭借其明确的数学定义与高效的批量处理能力,仍是特征工程与人群分层的首选基线模型。掌握数据量纲对齐、惯性指标监控与肘部法则诊断,即可快速搭建可靠的无监督分组流水线。以上就是基于Python与scikit-learn实现Kmeans聚类及数据划分的详细内容,更多关于数据挖掘与算法应用资料的关注本站内容!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















