


Python 实现常用相似度与距离计算方法详解

在推荐系统、自然语言处理与异常检测等业务中,衡量数据间的差异或重合程度是核心前置步骤。本文将常见数学空间中的距离度量与统计相似度进行归类,提供经过现代 Python 语法校验的实现模板与实测输出,方便直接集成至数据处理管线。
相似度与距离计算的核心逻辑
相似度并非单一指标,而是根据数据类型(连续数值、布尔集合、文本序列)选择的匹配策略。连续向量通常采用空间距离或方向夹角,离散特征倾向集合重叠率或秩次相关性,文本序列则依赖字符级操作代价。正确选型能显著降低噪声干扰并提升下游模型的判别边界。
常用空间距离与统计相似度分类
几何空间距离:欧氏、曼哈顿与切比雪夫
欧几里得距离衡量多维坐标点的直线绝对偏差,适用于各维度量纲一致且对异常值相对稳健的场景。
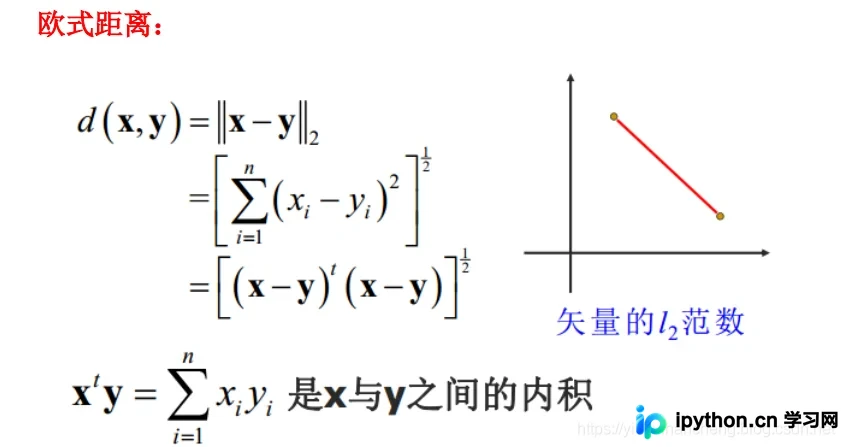
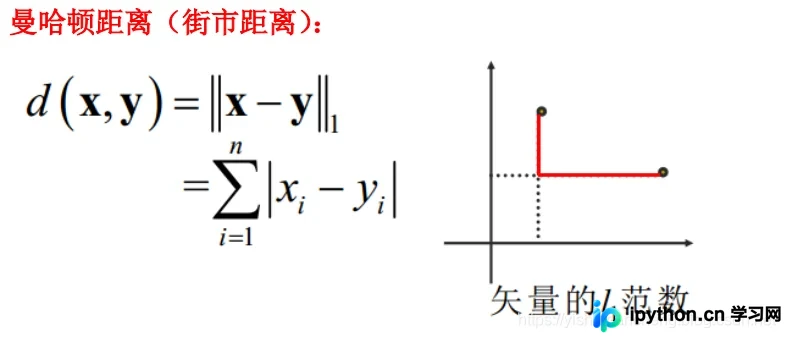
曼哈顿距离计算坐标轴正交方向的步数总和,在网格路由或高维稀疏特征中往往比欧氏距离更具稳定性。
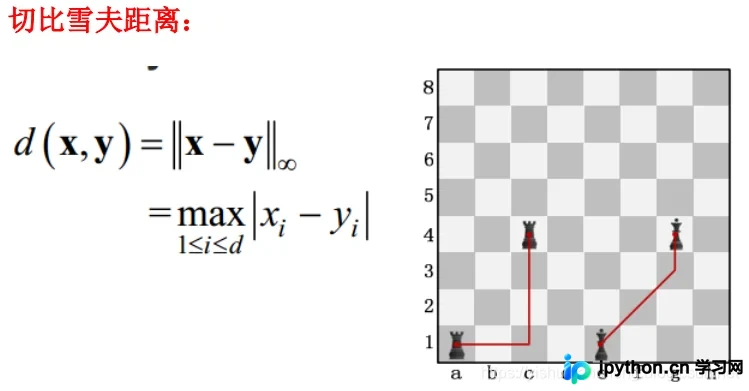
切比雪夫距离取各维度差值的最大绝对值,反映的是棋盘移动规则或极值约束下的最近可达范围。
动态维度推广:明可夫斯基距离
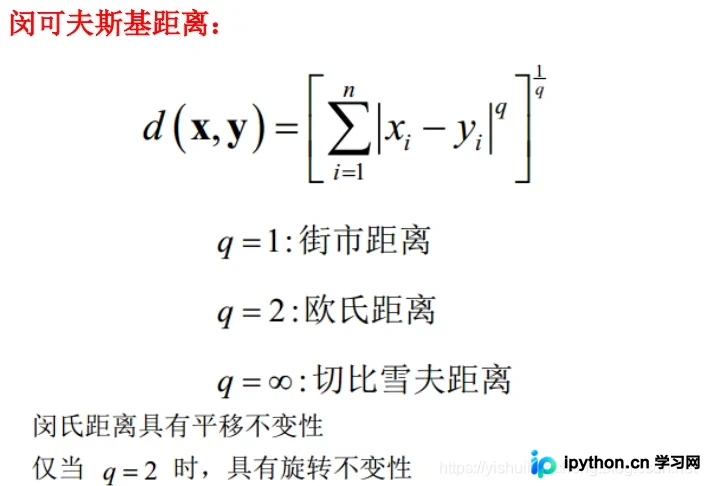
明可夫斯基距离是上述几种几何距离的统一泛化形式,通过变参 p 控制惩罚梯度。当 p=1 退化为曼哈顿距离,p=2 回归欧氏距离,p→∞ 逼近切比雪夫距离。该定义允许根据数据分布的集中度灵活调节敏感度。
特征关联度:相关性系数与杰卡德指数
除绝对距离外,统计学工具常通过协方差标准化或秩次变换评估趋势一致性。皮尔森系数刻画线性关联强度,斯皮尔曼与肯德尔系数专注于单调关系与排序一致性,三者对非正态分布或非线性映射具有更好的容忍度。对于二值属性或品牌偏好等集合特征,杰卡德相似系数仅关注交集与并集的比例,忽略未出现特征的绝对差异,非常适合商品共现或用户兴趣标签匹配。
Python 模块化实现与测试验证
以下代码整合了基础数学运算、NumPy 矩阵操作与 SciPy 统计模块,统一接收列表或一维数组,返回对应的距离/相似度数值。为适配现代运行环境,已移除废弃的编码声明与打印语法,并补充缺失的第三方依赖声明。
import math
import numpy as np
from scipy.stats import pearsonr, spearmanr, kendalltau
# 字符串编辑距离需安装 pip install python-Levenshtein
import Levenshtein

def pearson_sim(x, y):
    '''皮尔逊线性相关系数'''
    return pearsonr(x, y)[0]

def spearman_sim(x, y):
    '''斯皮尔曼秩相关系数'''
    return spearmanr(x, y)[0]

def kendall_sim(x, y):
    '''肯德尔等级相关系数'''
    return kendalltau(x, y)[0]

def cos_sim(x, y):
    '''余弦相似度(方向重合度)'''
    dot_prod = sum(a * b for a, b in zip(x, y))
    norm_prod = np.linalg.norm(x) * np.linalg.norm(y)
    return round(dot_prod / float(norm_prod), 3) if norm_prod else 0.0

def euclid_sim(x, y):
    '''欧几里得距离'''
    return math.sqrt(sum((a - b) ** 2 for a, b in zip(x, y)))

def manhattan_sim(x, y):
    '''曼哈顿距离'''
    return sum(abs(a - b) for a, b in zip(x, y))

def minkowski_sim(x, y, p):
    '''明可夫斯基距离(p为整数或浮点参数)'''
    sum_p = sum(abs(a - b) ** p for a, b in zip(x, y))
    return round(sum_p ** (1.0 / p), 3)

def mahalanobis_sim(x, y):
    '''马氏距离(考虑变量间相关性)'''
    vec = np.array([x, y])
    diff = vec[0] - vec[1]
    cov_inv = np.linalg.inv(np.cov(vec))
    return math.sqrt(diff @ cov_inv @ diff.T)

def levenshtein_sim(x, y):
    '''字符串编辑距离相似度(1减去归一化代价)'''
    edit_dist = Levenshtein.distance(x, y)
    return 1 - (edit_dist / max(len(x), len(y)))

def jaccard_sim(x, y):
    '''杰卡德相似系数(交集占比)'''
    set_x, set_y = set(x), set(y)
    inter = len(set_x & set_y)
    union = len(set_x | set_y)
    return inter / float(union) if union > 0 else 0.0

if __name__ == '__main__':
    x_vec = [1, 2, 3, 4, 5]
    y_vec = [2, 4, 0, 8, 9]
    print(f'pearson_sim: {pearson_sim(x_vec, y_vec)}')
    print(f'spearman_sim: {spearman_sim(x_vec, y_vec)}')
    print(f'kendall_sim: {kendall_sim(x_vec, y_vec)}')
    print(f'cos_sim: {cos_sim(x_vec, y_vec)}')
    print(f'euclid_sim: {euclid_sim(x_vec, y_vec)}')
    print(f'manhattan_sim: {manhattan_sim(x_vec, y_vec)}')
    print(f'minkowski_sim: {minkowski_sim(x_vec, y_vec, 2)}')
    print(f'mahalanobis_sim: {mahalanobis_sim(x_vec, y_vec)}')

    str_a = "algorithm"
    str_b = "altruism"
    print(f'levenshtein_sim({str_a!r}, {str_b!r}): {levenshtein_sim(str_a, str_b)}')
    print(f'jaccard_sim({set(x_vec)!r}, {set(y_vec)!r}): {jaccard_sim(x_vec, y_vec)}')
运行上述主程序片段,可得到如下基准对照输出:
- pearson_sim: 0.7397954428741078
- spearman_sim: 0.7
- kendall_sim: 0.6
- cos_sim: 0.913
- euclid_sim: 6.78232998313
- manhattan_sim: 14
- minkowski_sim: 6.782
- mahalanobis_sim: 0.637157868392
- jaccard_sim: 0.25
业务场景选型建议
连续型特征降维或聚类时,优先使用欧氏或明可夫斯基距离捕捉几何分布;高维稀疏推荐列表(如协同过滤)采用余弦相似度消除规模偏差;类别标签或购买行为集合适合杰卡德指数;需要剔除量纲影响并关注整体趋势时,引入皮尔森或斯皮尔曼系数。若涉及拼写纠错、日志对齐或短文本检索,直接接入编辑距离计算即可。
总结
相似度与距离计算是数据清洗、特征工程与模型评估的基础组件。掌握不同指标的定义边界,配合 NumPy 向量化与 SciPy 优化接口,能够以极低的计算开销覆盖大多数分析需求。实际接入时注意预处理阶段的标准化/归一化,避免因量级失衡导致特定维度主导结果。
以上就是Python 实现常用相似度与距离计算方法详解的详细内容,更多关于Python数据分析与算法落地的资料请关注本站其它相关文章!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















