


Python简易跳表数据结构实现与核心操作指南

本文通过Python完整示例演示简易跳表的构建流程。从节点结构定义与首尾边界处理开始,逐步讲解有序插入、固定步长的索引重建、跨层查询跳转及全量遍历方法。附带可运行的测试脚本与执行结果对照,帮助开发者直观理解跳跃查找机制及其在读多写少场景下的应用基础。
跳表核心原理与适用场景
跳表(Skip List)是一种基于有序链表的多层索引数据结构。其核心思想是通过在原始数据节点上建立高层索引,实现数据的跳跃式查找。类比图书馆书架,底层逐本排查效率较低,而多层分类索引能先在大致区域定位,再向下层逐级缩小范围,大幅减少比较次数。由于每次插入新数据后均需重新计算索引路径,该结构在读多写少的场景中性能表现最为稳定。为便于掌握核心逻辑,此处采用固定步长为2的简化版进行实现。
环境准备与节点定义
构建跳表前需明确节点属性。每个节点除存储实际数据值外,还需维护双向链表的前后指针以及指向同层下一索引节点的横向指针。为便于边界控制,初始化时需预设头尾哑节点作为跳表的起始与终止锚点。
class SkipNode:
    def __init__(self, value, before_node=None, next_node=None, index_node=None):
        self.value = value
        self.before_node = before_node
        self.next_node = next_node
        self.index_node = index_node

head = SkipNode(-1)
tail = SkipNode(-1)
第1步:实现有序数据插入
目的:确保跳表底层链表始终保持升序排列,为新元素找到正确位置并建立前后向关联。
入口:待插入的 node 对象
动作:若链表为空,直接将新节点挂载至头尾之间;若非空则从头节点后继开始遍历比对。当发现当前节点值大于目标值或抵达尾部锚点时,中断循环并在前置节点与当前节点之间完成四重指针交叉替换。最后触发索引重建流程。
重要参数:无额外参数,依赖全局 head 与 tail 边界
完成状态:链表顺序更新,re_index() 已调度
def insert_node(node):
    if head.next_node is None:
        head.next_node = node
        node.next_node = tail
        node.before_node = head
        tail.before_node = node
        return
    temp = head.next_node
    while temp.next_node is not None or temp == tail:
        if temp.value > node.value or temp == tail:
            before = temp.before_node
            before.next_node = node
            temp.before_node = node
            node.before_node = before
            node.next_node = temp
            break
        temp = temp.next_node
    re_index()
第2步:执行索引重建规则
目的:清除旧索引痕迹,按固定步长(间隔2个节点)建立上层跳跃指针。
入口:全局链表结构
动作:设置步长计数器为2,遍历所有节点。遍历过程中先将各节点原有索引置空;计数器归零时将当前节点链接至上一级索引锚点,随后重置步长。通过此循环完成单层索引链路的串联。
重要参数:内置 step = 2
完成状态:每隔一个节点产生一个上层索引指向
def re_index():
    step = 2
    index_temp = head.next_node
    temp = head.next_node
    while temp.next_node is not None:
        temp.index_node = None
        if step == 0:
            step = 2
            index_temp.index_node = temp
            index_temp = temp
        temp = temp.next_node
        step -= 1
第3步:编写范围查询与指针跳转逻辑
目的:利用索引层实现快速越界检索,降低线性扫描开销。
入口:目标查找值 value
动作:从头节点后继发起比对。若命中直接返回成功计数;若小于当前值说明目标不存在;若大于当前值但存在横向索引且索引值更小,则沿索引层向右跳跃一步;否则降级至底层链表继续顺序比对。未遍历完所有有效节点前持续此逻辑。
可观察结果:控制台输出命中提示、未找到状态及查询步进次数
def search_node(value):
    temp = head.next_node
    step = 0
    while temp.next_node is not None:
        step += 1
        if value == temp.value:
            print(f"该值已找到,经历了{step}次查询")
            return
        elif value < temp.value:
            print(f"该值在列表不存在,经历了{step}次查询")
            return
        if temp.index_node is not None and value > temp.index_node.value:
            temp = temp.index_node
        else:
            temp = temp.next_node
    print(f"该值在列表不存在,经历了{step}次查询")
第4步:验证数据输出与遍历展示
目的:将非线性存储结构转换为扁平字典列表打印,辅助人工核对索引映射关系。
入口:无需参数
动作:遍历底层节点,提取 current_value 与对应的 index_value(无索引时标记为None)。拼接为列表后逐行输出。
完成状态:终端呈现完整的节点值与索引跳转目标对照表
def print_node():
    my_list = []
    temp = head.next_node
    while temp.next_node is not None:
        if temp.index_node is not None:
            my_dict = {"current_value": temp.value, "index_value": temp.index_node.value}
        else:
            my_dict = {"current_value": temp.value, "index_value": None}
        my_list.append(my_dict)
        temp = temp.next_node
    for item in my_list:
        print(item)
完整测试脚本与结果核对
为快速验证上述功能,可通过外部脚本调用模块接口。使用 random.randint 生成1~100范围内的随机整数实例化节点,批量插入跳表后立即执行遍历打印,并指定特定数值进行查找测试。以下为标准运行输出的关键信息截取:
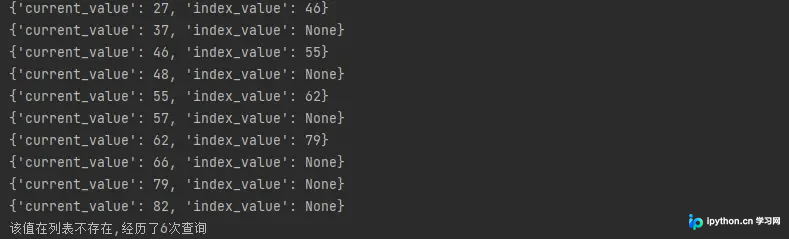
运行后可清晰观察到每行输出的 index_value 即为当前层级推荐跳转的目标节点值。结合查询提示可知,得益于索引层的提前拦截,系统在未达到末尾前即可完成匹配或判定缺失。
常见问题排错与维护提醒
本实现侧重于教学演示,在实际工程部署前需注意以下风险点:一是当前插入操作未做并发锁保护,多线程环境下可能引发指针覆盖异常,写入前务必使用线程同步机制或备份原始引用链;二是固定步长策略在数据量极大时可能导致索引层过浅,建议后续升级为随机高度法(Randomized Height)以提升整体树高平衡性;三是哑节点 -1 仅占位,若业务数据本身包含极小负数,需更换为 float('-inf') 防止值域冲突。
总结
通过上述Python代码的逐步拆解,已经完整跑通了跳表从节点封装、有序挂接、双端索引构建到跨层检索的全部核心链路。这种以空间换时间的索引设计思路,配合固定的步进规则,能够直观呈现跳跃查找如何跳过无关区间从而提升读写效率。以上就是Python简易跳表数据结构实现与核心操作的详细内容,更多关于Python算法实战与索引优化的资料请关注本站其它相关文章!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















