


Python内置map/filter/reduce函数详解与lambda进阶用法

本文详细解析 Python 中 map、filter 和 reduce 三大高阶函数的运行原理与实操写法。说明各函数的参数规则、惰性迭代器返回机制及多输入校验逻辑,并提供结合 lamda 表达式的批量映射、条件过滤与累积计算完整示例,附带版本差异提醒与防错要点。
第1步:使用map()进行批量元素映射
map() 将指定处理函数应用于一个或多个可迭代对象的对应元素,并返回包含结果的惰性迭代器。其底层构造需传入函数与至少一个数据源:
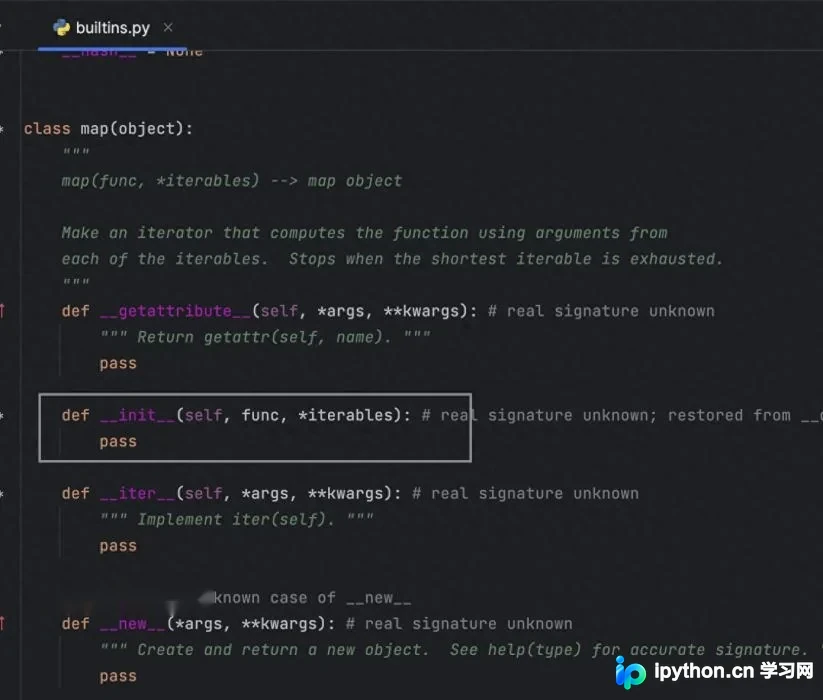
语法结构:map(function, iterable, ...)。核心参数说明如下:
function:接收一个或多个参数的处理逻辑。iterable:提供数据的序列类型,如列表、元组或字符串。
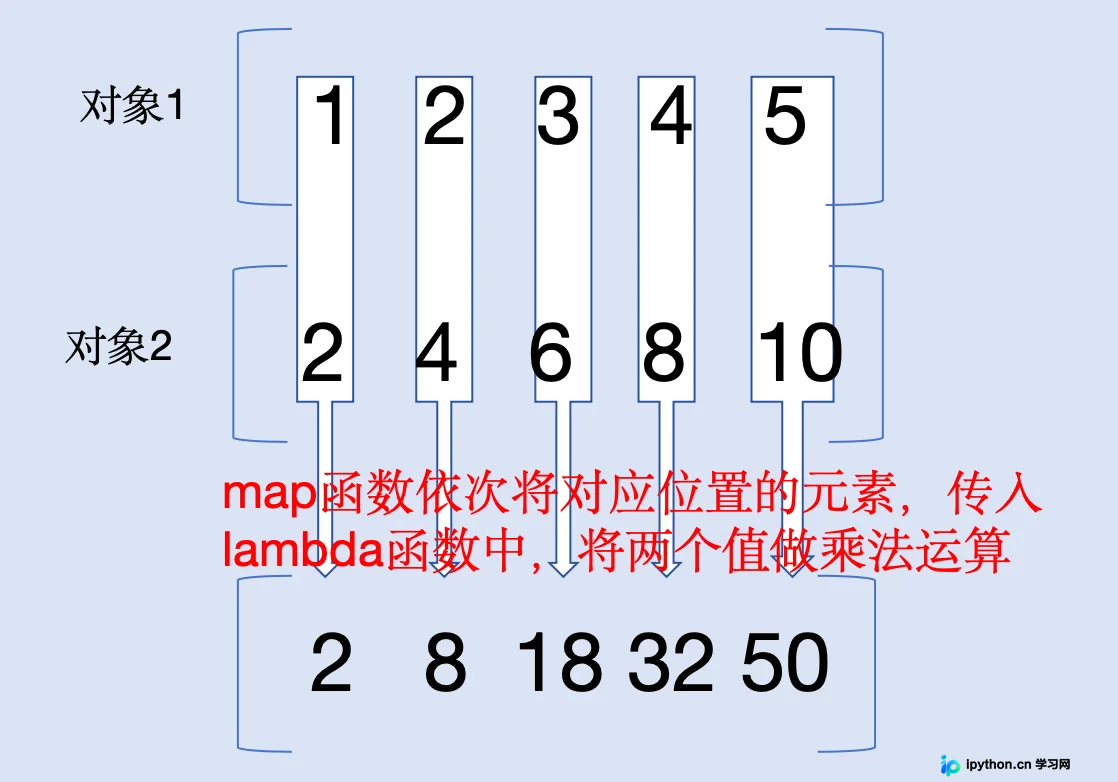
使用注意:map() 默认不立即执行计算,需通过 list() 强制求值。当传入多个可迭代对象时,函数的形参数量必须与数据列数严格对应,否则会中断迭代并抛出异常。典型用法如下:
# 单个可迭代对象:执行平方运算
value1 = map(lambda x: x ** 2, [1, 2, 3, 4, 5])
print(list(value1))
# 输出: [1, 4, 9, 16, 25]

# 多个可迭代对象:按位相乘
value2 = map(lambda x, y: x * y, [1, 2, 3], (4, 5, 6))
print(list(value2))
# 输出: [4, 10, 18]
若形参声明为双变量但仅传入单列表,运行时会触发 TypeError 错误,提示缺少必需的位置参数。
第2步:利用filter()执行条件筛选
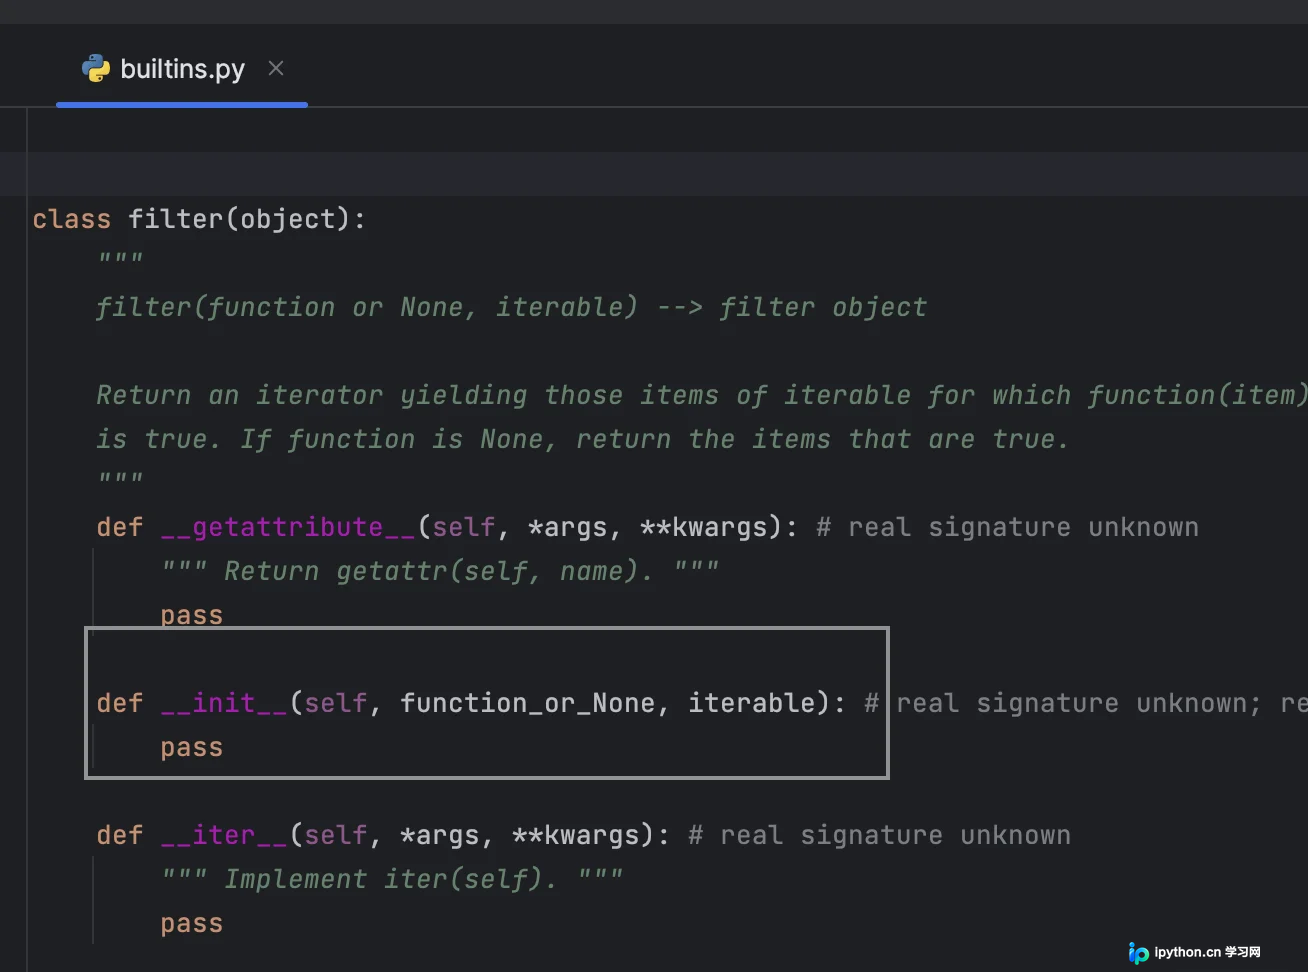
filter(function, iterable) 依据函数的布尔返回值保留满足条件的序列元素,同样返回迭代器对象。
numbers = [10, 3, 9, 8, 6]
filtered = filter(lambda x: x % 2 == 0, numbers)
print(list(filtered))
# 输出: [10, 8, 6]
第3步:借助reduce()实现序列累积计算
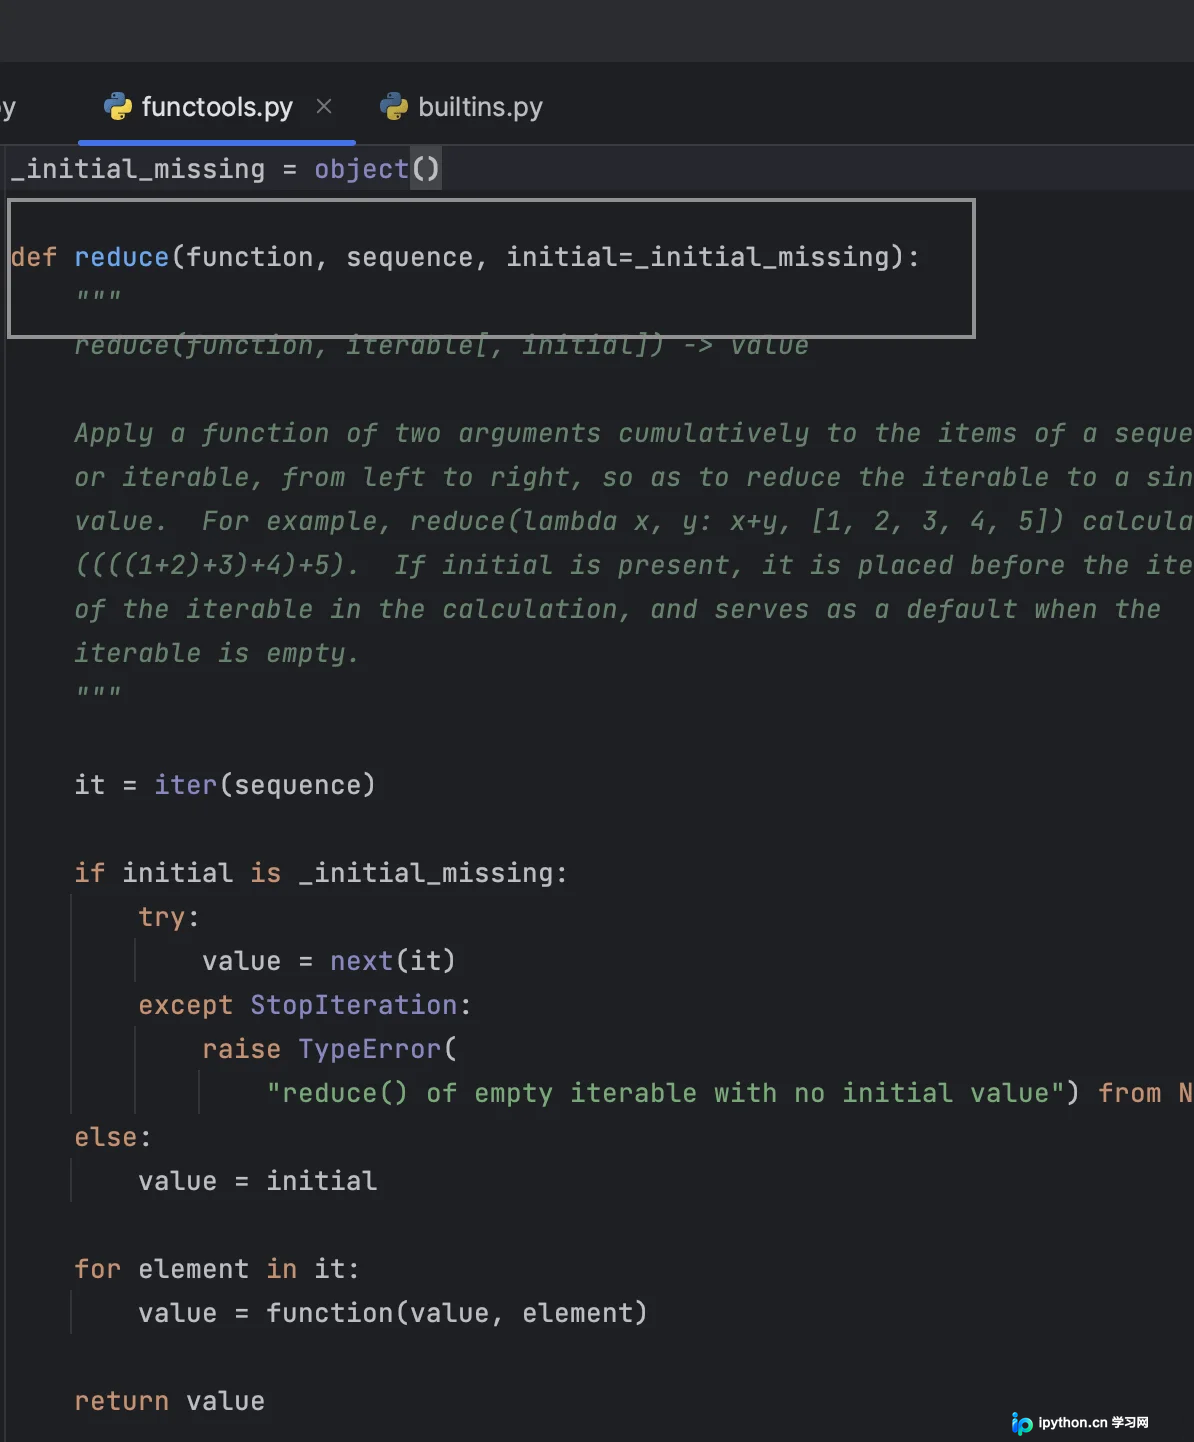
自 Python 3 起,reduce() 不再作为内置函数存在,需从标准库 functools 模块显式导入。该函数将二元操作连续作用于序列元素,最终折叠为单一聚合值。
语法:reduce(function, sequence, initial=_initial_missing)。新增的 initial 参数可直接设定累加起点,避免依赖首元素作初始态。
from functools import reduce

# 基础累加求和
nums = [1, 2, 3, 4, 5]
total = reduce(lambda x, y: x + y, nums)
print(total)
# 输出: 15

# 带初始值的累加(首次操作变为 initial + 首元素)
total_init = reduce(lambda x, y: x + y, nums, 6)
print(total_init)
# 输出: 21
完成判断与注意事项
终端无报错且打印出预期数值即表示配置成功。编写时需留意:map() 处理多列数据时必须对齐参数声明;reduce() 面对空序列且未提供 initial 时会直接崩溃,建议补充默认值防御。高效运用这三类函数可大幅精简循环嵌套逻辑,提升数据清洗效率。以上就是 Python 内置高阶函数 map、filter 和 reduce 的详细使用方法,更多关于 Python 函数式编程优化的资料请关注本站其它相关文章!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















