


JMeter如何实现随机请求参数?单次提取与脚本优化详解

在接口自动化测试中,下游接口常需依赖上游查询出的随机数据作为请求参数。本文对比JMeter中反复查询与单次提取配合前置脚本的两种实现路径,详细演示基于JSR223 PreProcessor动态生成随机下标的核心步骤与Groovy代码,提供运行校验方法与常见报错排查指南,助力测试场景稳定性与执行效率双提升。
场景需求与方案对比
在接口自动化测试场景中,下游提交或保存接口往往需要依赖上游查询返回的动态数据作为请求参数。例如,构建三级分类菜单时,新建二级目录的父级ID(一级目录)需从查询结果中随机选取,同理三级目录也需随机挂载到不同的二级目录下。针对该需求,JMeter主要提供两种实现路径:频繁发起查询请求并临时匹配,或仅查询一次提取全量结果后在运行时动态计算下标。两者在执行效率与资源消耗上差异显著。
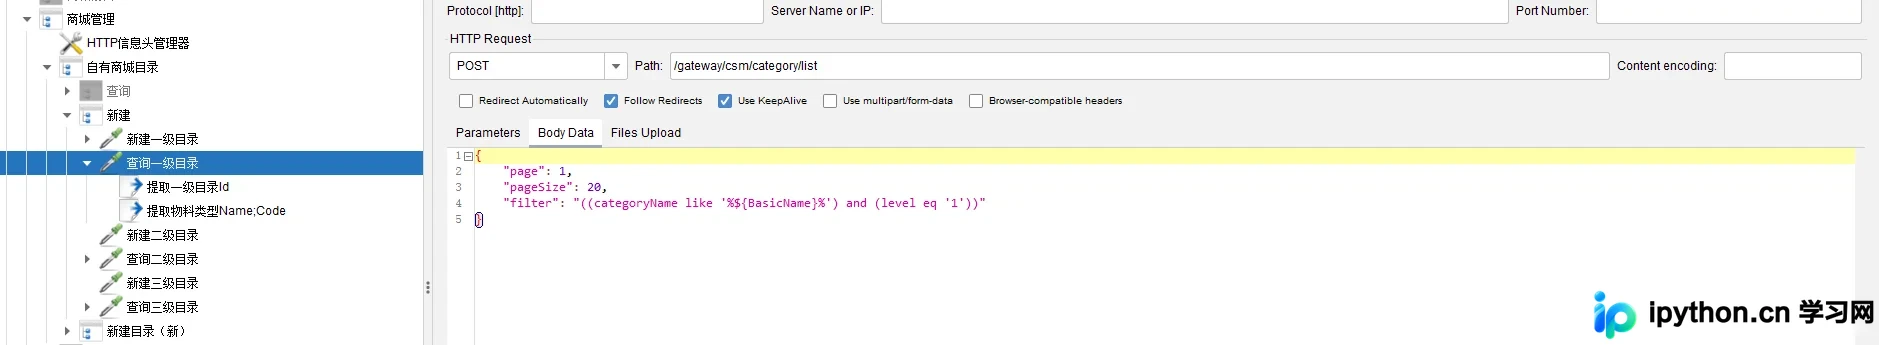
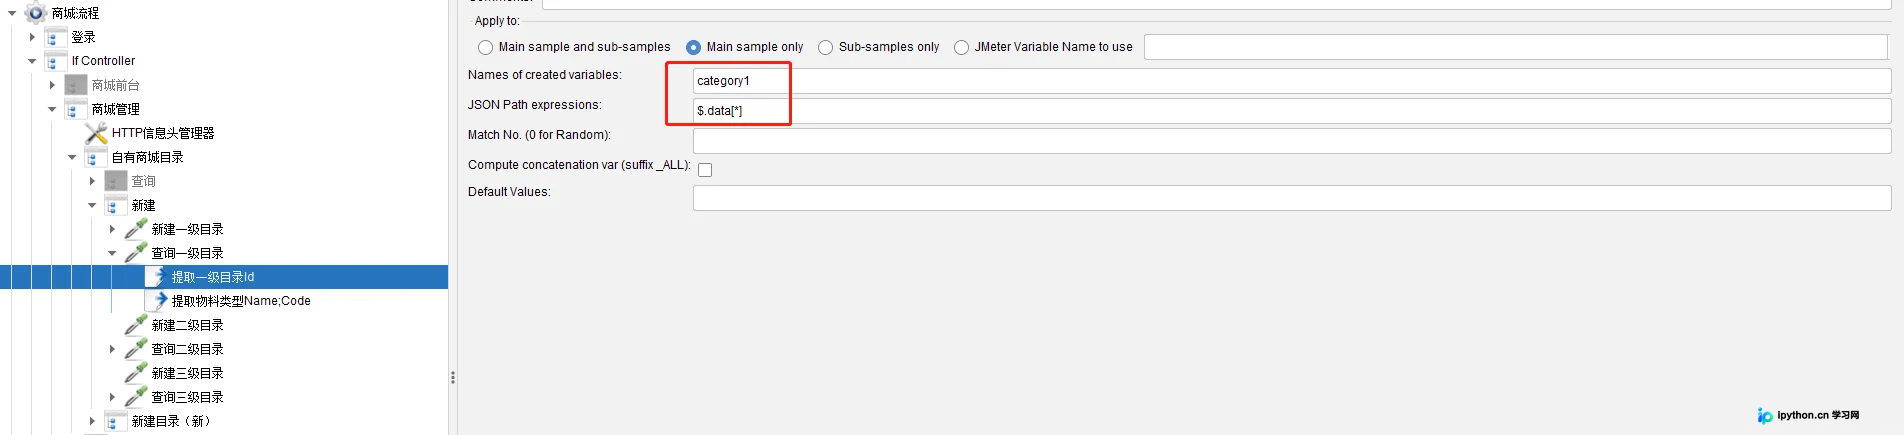
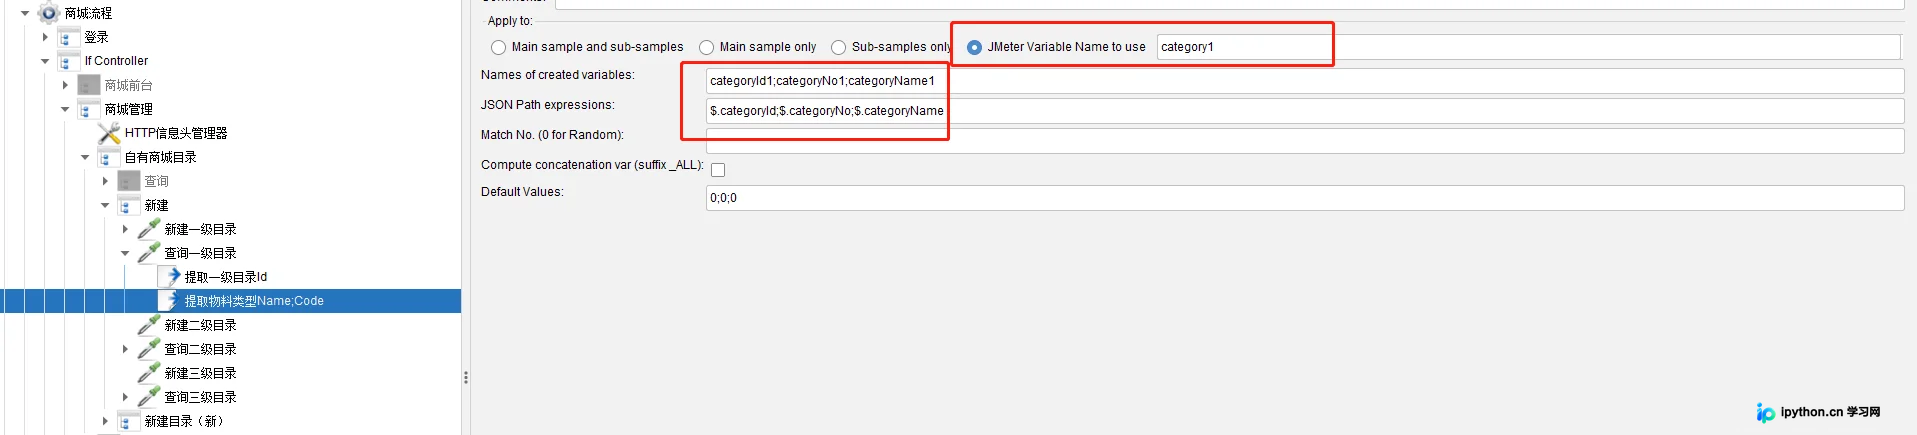
方案一:反复查询后随机匹配
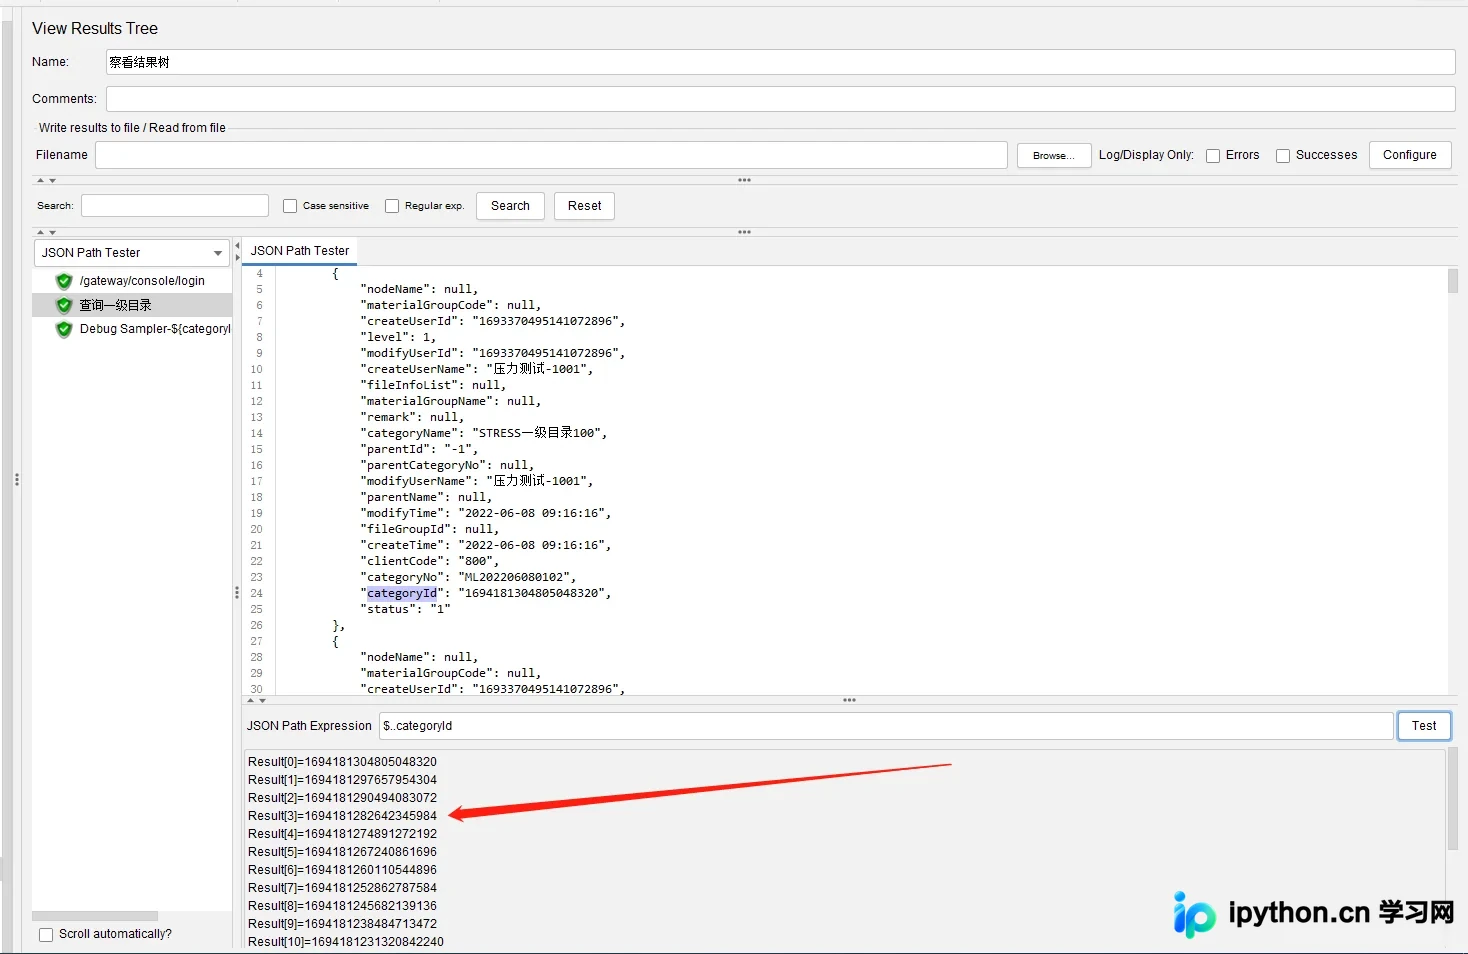
该方案直接在每次执行下游请求前,重新触发一次查询接口,利用正则表达式或JSON提取器解析响应体,随后通过内置函数或简单的随机逻辑从本次返回的结果中挑选父级ID。其优势在于无需维护复杂的中间状态,但缺点极为明显:随着用例执行次数增加,无效的网络往返与序列化开销会呈线性增长,极易成为压测或回归测试的性能瓶颈。如图所示,该方案依赖频繁的变量覆盖,实际业务中不建议作为首选。
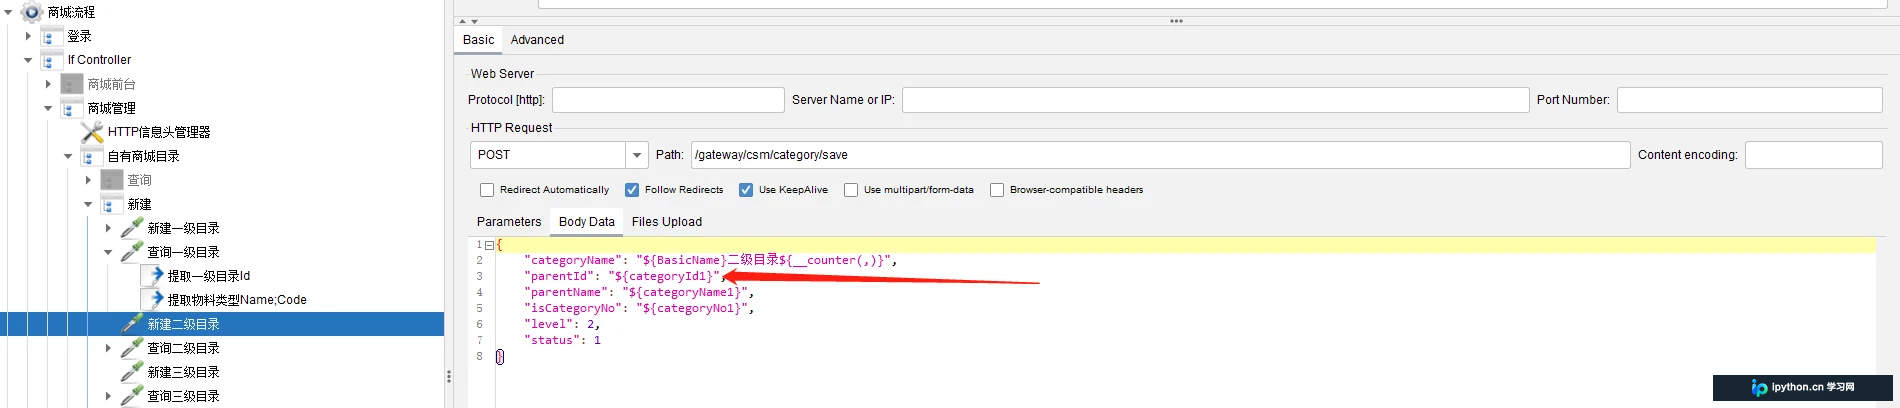
方案二:单次提取配合前置脚本(推荐)
将“查询”与“使用”解耦,仅在执行链起点拉取一次全量候选集,后续接口通过前置处理器实时运算随机索引。该方法大幅削减了网络I/O,实测吞吐量可提升数倍,是处理动态关联参数的标准做法。
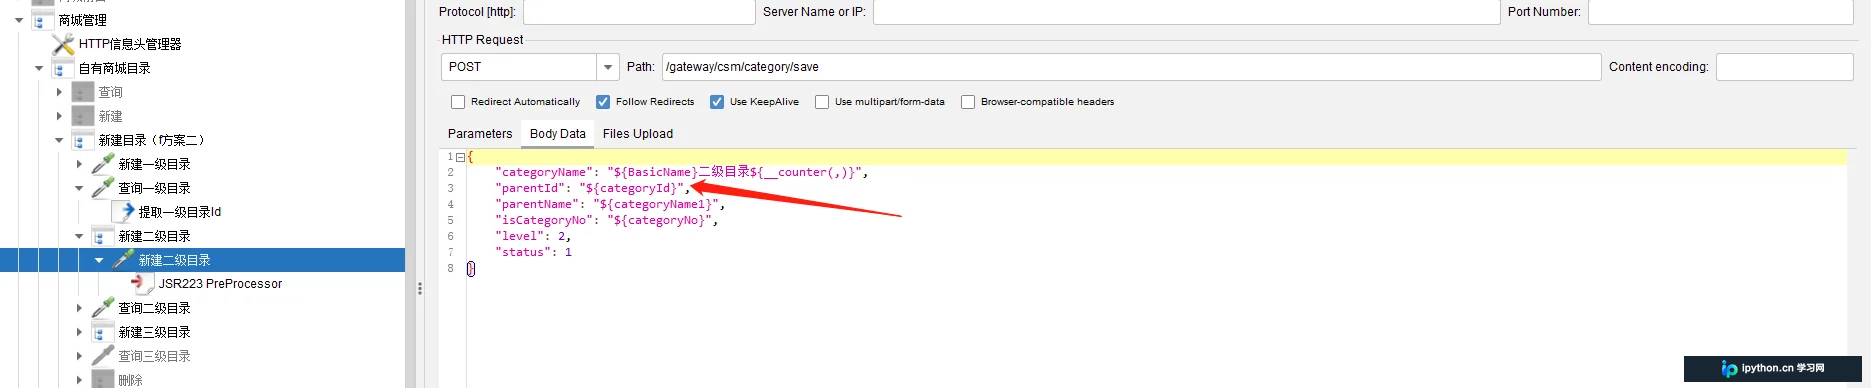
第1步:配置查询取样器并提取候选列表
目的:获取所有可用的上一级目录ID,并为后续脚本提供数据源。
操作入口:添加 → 后置处理器 → JSON提取器/正则表达式提取器
关键动作:在查询接口的后置处理器中配置变量引用名称(如 parentId)。提取器会自动创建带数字后缀的变量组(例如 parentId_1, parentId_2)以及记录总数的 parentId_count 变量。点击“应用”保存配置。
重要参数:Match No. 建议设为 -1(提取全部),Reference Name 需保持唯一且不含特殊符号。
完成状态:查看“察看结果树”,确保响应中提取的变量值正确显示,且存在代表列表长度的 _count 变量。
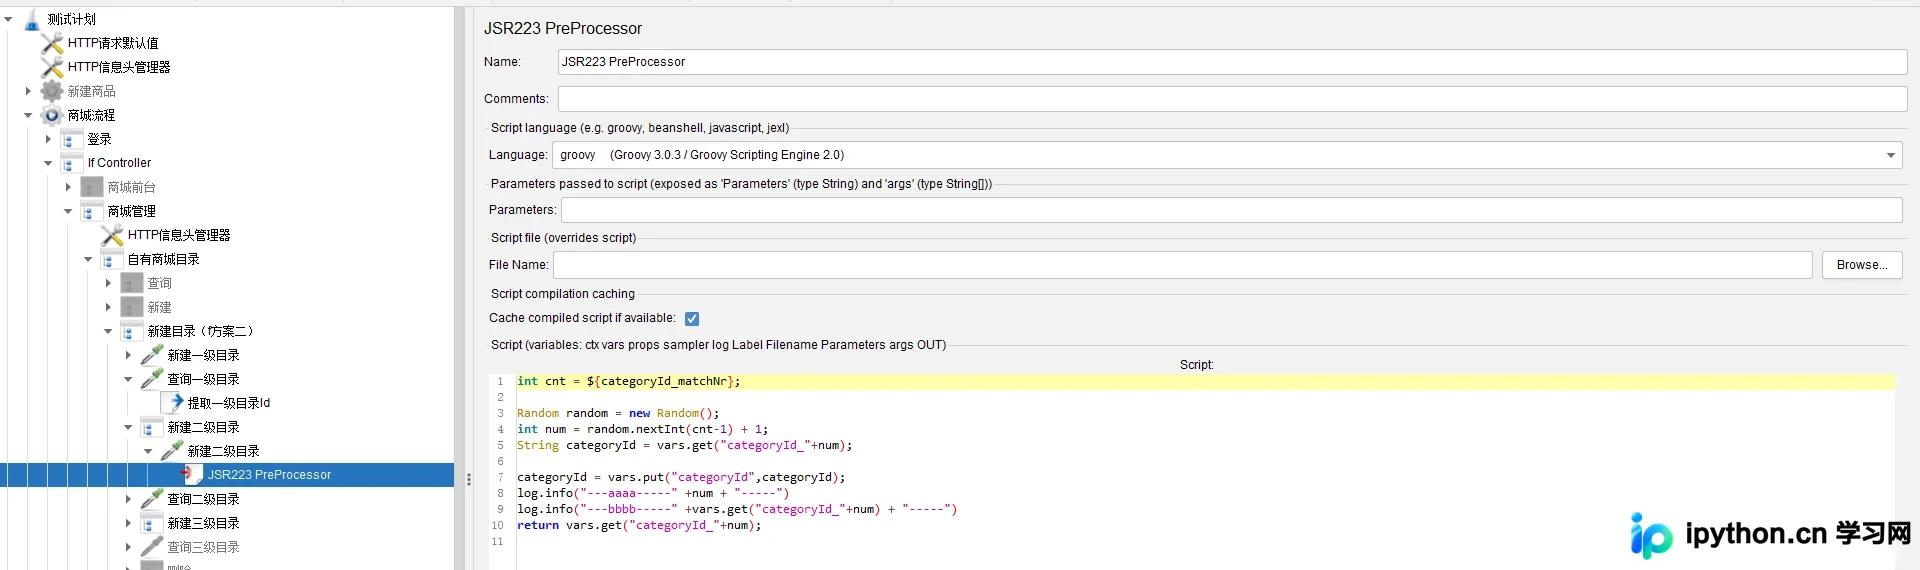
第2步:编写JSR223 PreProcessor动态计算随机下标
目的:利用Groovy脚本在每次发送请求前,自动生成指向候选列表的随机索引,并剥离为独立变量供参数使用。
操作入口:添加 → 前置处理器 → JSR223 PreProcessor
关键动作:勾选“缓存编译脚本”以提升性能。在脚本区域输入以下Groovy代码(请根据实际提取器的变量名前缀替换 parentId_):
def prefix = "parentId_";
def totalVarName = prefix + "count";
int totalCount = Integer.parseInt(vars.get(totalVarName));

if (totalCount <= 0) {
    throw new RuntimeException("未提取到任何有效ID,请检查前置查询接口响应");
}

// 生成 0 到 totalCount-1 之间的随机整数
int randomIdx = new java.util.Random().nextInt(totalCount);
String targetVar = prefix + (randomIdx + 1);
String selectedId = vars.get(targetVar);

vars.put("randomParentId", selectedId);
log.info("成功随机选取父级ID: " + selectedId + " (索引位置: " + (randomIdx + 1) + ")");重要参数:cache=true(勾选)、语言选择 groovy。
完成状态:脚本无红框报错,变量管理器中存在 randomParentId 且值为预期候选ID之一。
第3步:在下游接口请求中注入随机参数
目的:将预处理生成的变量映射至HTTP请求的具体参数位置。
操作入口:添加 → Sampler → HTTP请求
关键动作:在“参数”或“Body Data”对应字段输入 ${randomParentId}。若为JSON格式,直接写 {"parentId": "${randomParentId}"}。注意检查编码格式是否为UTF-8。
完成状态:发送请求后,监听器抓包显示该字段值随每次迭代发生变化,且均命中上游有效数据,状态码符合预期。
运行判断与排错建议
执行测试计划后,可通过“查看结果树”或聚合报告确认成功率。若遭遇 NullPointerException 或索引越界,通常源于前置查询被跳过、过滤条件过严导致 _count 为0,或提取器语法不匹配响应结构。建议在调试阶段开启日志级别为INFO,观察脚本输出的实际索引值。此外,若多个并发线程同时操作同一组全局变量,务必在测试计划中禁用“共享变量池”或改用线程独立的用户参数,避免值覆盖冲突。
总结
以上就是JMeter实现随机请求参数的详细内容,更多关于接口自动化测试参数化技巧的资料请关注本站其它相关文章!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















