


Python实现中文文本转语音的完整流程

本文介绍使用 Python 配合 pyttsx3 库将中文字符转换为本地语音文件的完整方法。通过初始化系统 TTS 引擎、自动匹配中文语音标识、保存音频并调用 pydub 调整采样率,可快速生成标准的 .wav 录音文件,并附带解决集成环境中文编码报错的实操技巧。
Python实现中文文本转语音的操作指南
利用 Python 调用操作系统自带的文本转语音(TTS)引擎,无需联网即可生成高质量语音。以下以 Visual Studio 2022 为例,演示从环境配置到音频输出的标准流程。
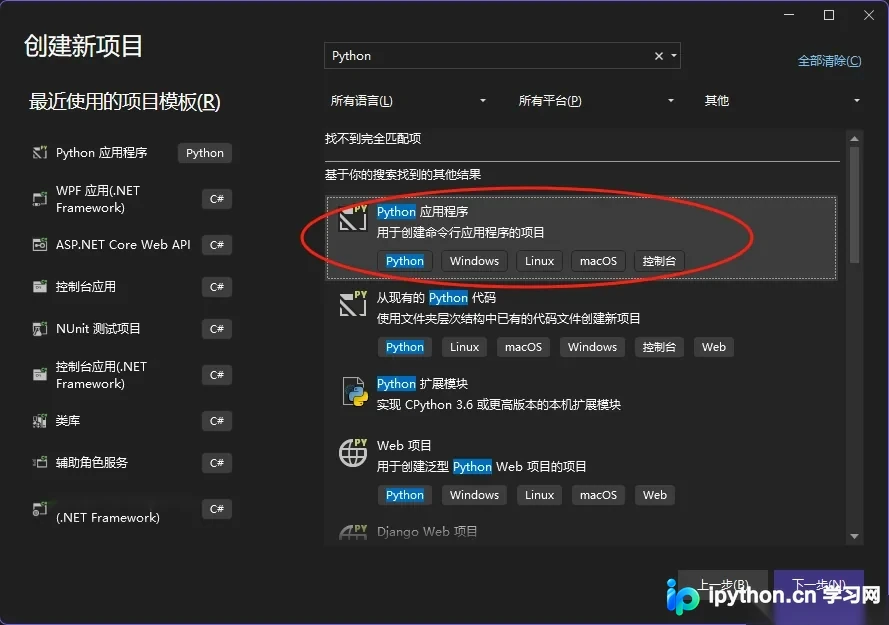
第1步:安装语音合成与音频处理依赖
打开包管理器,用于安装驱动合成引擎与处理音频采样的第三方库。
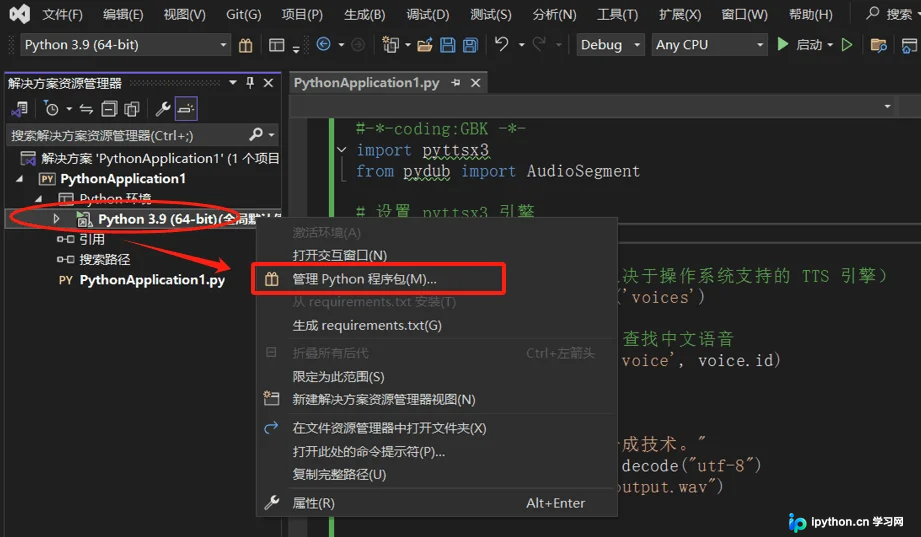
执行安装命令获取核心组件。若需调整音频采样率,请额外安装 pydub:
pip install pyttsx3 pydub
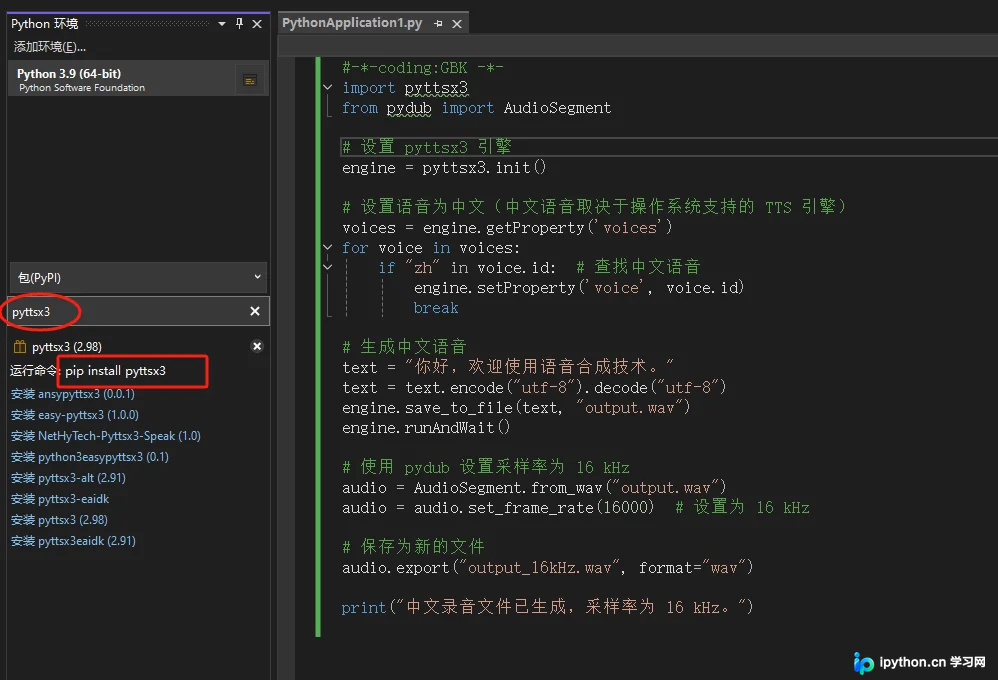
第2步:编写与调试转换脚本
新建 Python 源文件,按以下结构编写逻辑。代码包含初始化引擎、遍历查找中文语音标识、写入音频文件以及修正采样率四个核心环节。注意在文件顶部声明编码格式,防止 IDE 解析时报错。
#-*-coding:GBK -*-
import pyttsx3
from pydub import AudioSegment

# 初始化 pyttsx3 引擎
engine = pyttsx3.init()

# 遍历系统可用语音,匹配中文标识
voices = engine.getProperty('voices')
for voice in voices:
    if "zh" in voice.id:
        engine.setProperty('voice', voice.id)
        break

# 定义待转换文本并清理编码
text = "你好,欢迎使用语音合成技术。"
text = text.encode("utf-8").decode("utf-8")

# 排队写入音频文件
engine.save_to_file(text, "output.wav")
engine.runAndWait()

# 使用 pydub 重新设定采样率为 16 kHz 标准音轨
audio = AudioSegment.from_wav("output.wav")
audio = audio.set_frame_rate(16000)
audio.export("output_16kHz.wav", format="wav")

print("中文录音文件已生成,采样率为 16 kHz。")
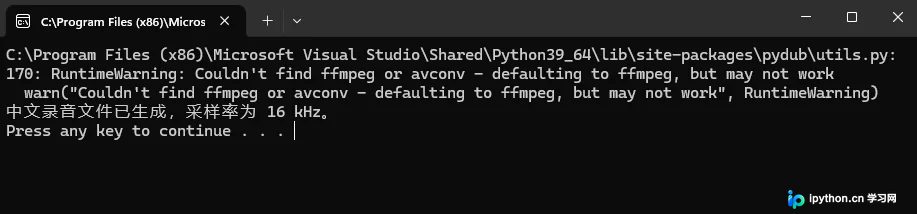
第3步:验证输出文件与完成判断
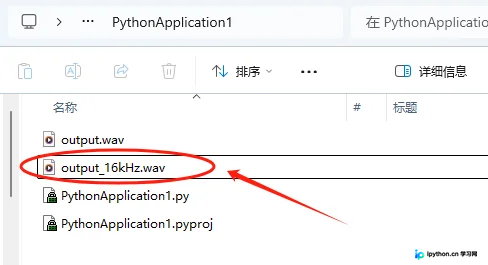
脚本正常结束后,会在同级目录生成两个文件:原始合成音频与重采样后的音频。检查 output_16kHz.wav 是否已完整创建且文件大小大于零,即表示转换流程全部跑通。可直接使用播放器试听中文播报效果。
常见编码异常排查
SyntaxError 与 Unicode 解码失败处理
在部分集成开发环境或系统终端中运行含中文字符的脚本时,常会出现以下报错:
SyntaxError: (unicode error) 'utf-8' codec can't decode byte 0xc4 in position...
该现象多因源文件保存编码与控制台默认编码不一致导致。尝试在首行添加 # -*- coding: utf-8 -*- 无效时,可将编码声明改为 # -*- coding: GBK -*-。此写法适配 Windows 旧版控制台或特定 IDE 的 ANSI 渲染机制,能强制绕过解码拦截。建议在代码稳定后,统一将工程文件另存为 UTF-8 with BOM 以获得最佳跨平台兼容性。
以上就是Python实现中文文本转语音的详细操作流程,更多关于Python音频处理与本地TTS引擎调用的技术资料请关注本站其它相关文章!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















