


Python可变默认参数陷阱解析与最佳实践

在Python开发中,函数参数的默认值是一个既方便又危险的特性。它允许我们为参数提供预设值,简化函数调用,但在使用可变对象(如列表、字典)作为默认参数时,却隐藏着令人困惑的陷阱。本文将通过深入解析Python函数参数的底层机制,揭示可变默认参数的陷阱本质,并提供多种解决方案和最佳实践,帮助读者彻底理解和避免这一常见但危险的错误。
理解Python可变默认参数的底层机制
要避开可变默认参数的陷阱,首先需要明确Python函数定义的执行时机。在Python中,def 不仅是一条语法关键字,更是一个可执行语句。当解释器遇到函数定义时,它会立即执行函数体内部的默认参数计算,创建一个函数对象并将其绑定到变量名上。
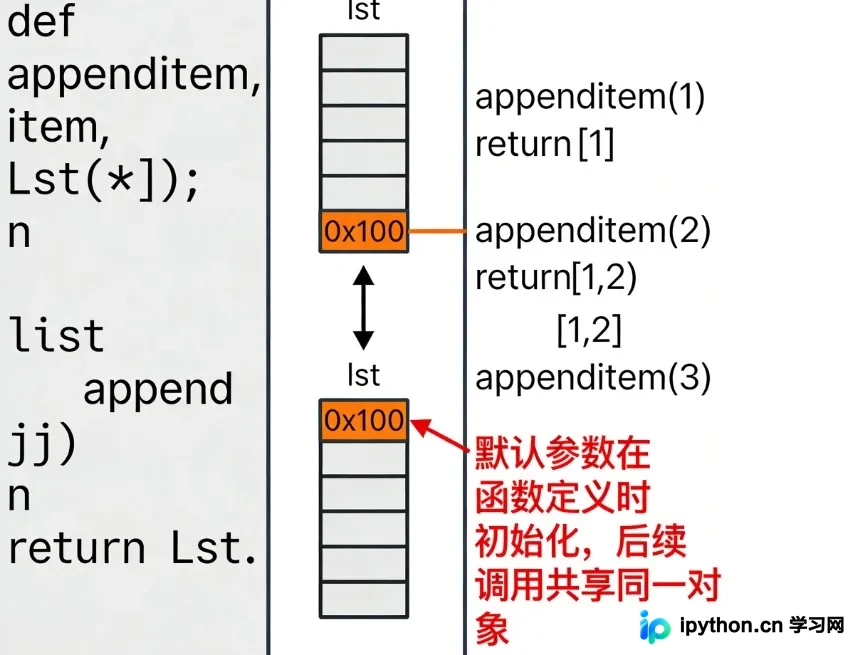
这意味着默认参数在函数定义时计算并持久化存储,而非每次调用时重新创建。对于不可变对象(整数、字符串、元组),这通常不会引发问题;但对于可变对象,所有后续的函数调用都会共享同一个初始化的对象实例。
第一步:观察函数的默认参数存储结构
我们可以利用内置属性 __defaults__ 直观查看默认参数在内存中的存储位置与标识。
def problematic_function(items=[]):
    """示例函数:使用可变默认参数"""
    items.append(len(items))
    return items

# 查看函数的默认参数存储
print("函数的 __defaults__ 属性:", problematic_function.__defaults__)
print("默认参数的 id:", id(problematic_function.__defaults__[0]))

# 多次调用函数
result1 = problematic_function()
result2 = problematic_function()
result3 = problematic_function()

print("\n三次调用结果:", result1, result2, result3)
print("对象一致性校验:", result1 is result2 is result3)运行上述代码会清晰观察到:__defaults__ 列表中始终指向同一个列表对象的内存地址。每次追加操作都在修改同一块堆内存,导致状态累积。
第二步:通过字节码验证参数绑定流程
借助标准库 dis 模块,可以进一步追踪函数创建时的常量池行为与参数加载指令。
import dis

def analyze_params(func):
    print(f"分析函数: {func.__name__}")
    print("=" * 40)
    dis.dis(func)
    print(f"常量池 (co_consts): {func.__code__.co_consts}")
    if func.__defaults__:
        print(f"默认参数值 (__defaults__): {func.__defaults__}")
        for i, val in enumerate(func.__defaults__):
            print(f"  参数 {i}: {val} (内存 ID: {id(val)})")

analyze_params(problematic_function)
字节码输出显示,参数默认值在函数对象构造阶段已被压入常量栈并固化。确认这一机制后,即可针对性地设计防御策略。
典型陷阱场景还原
场景一:缓存状态意外累积
在封装简易缓存或计数器时,直接使用空字典作为默认参数会导致不同调用者之间的数据串扰。
def get_cached_data(key, cache={}):
    """危险实现:所有调用共享同一个 cache 字典"""
    if key in cache:
        print(f"缓存命中: {key}")
        return cache[key]

    print(f"计算新值: {key}")
    result = f"result_for_{key}"
    cache[key] = result
    return result

print(get_cached_data('a'))  # 首次调用正常计算
print(get_cached_data('a'))  # 命中缓存
print(get_cached_data('b'))  # 命中缓存(实际应为新计算)
该现象表明,跨业务逻辑调用同一函数时,历史数据会持续堆积并干扰正常分支判定。
场景二:配置对象全局共享
在批量构建用户实体或配置项时,可变默认参数会造成属性覆盖或非法合并。
def create_user(name, permissions=[]):
    user = {
        'name': name,
        'permissions': permissions
    }
    return user

user1 = create_user('Alice')
user1['permissions'].append('read')

user2 = create_user('Bob')
user2['permissions'].append('write')

print(user1)  # {'name': 'Alice', 'permissions': ['read', 'write']}
print(user2)  # {'name': 'Bob', 'permissions': ['read', 'write']}
由于 permissions 引用同一列表,独立用户的权限配置发生严重交叉污染。
场景三:复杂数据结构的修改穿透
涉及多维矩阵或树形节点初始化时,若未严格隔离引用,前序调用的就地修改会直接映射到后续生成的结构中。
def create_matrix(rows=2, cols=2, default_value=0, matrix=None):
    if matrix is None:
        matrix = []

    for _ in range(rows):
        row = [default_value] * cols
        matrix.append(row)
    return matrix

matrix_a = create_matrix()
matrix_a[0][0] = 99
matrix_b = create_matrix()

print(matrix_a)
print(matrix_b)
此处代码展示了正确的防御写法。若将 matrix=None 替换为 matrix=[] 且省略判空逻辑,matrix_b 将继承 matrix_a 的修改痕迹。实际工程中需保持严格的引用隔离原则。
标准化解决方案与最佳实践
第三步:使用 None 替代空集合作为默认值
这是官方推荐的标准写法。将默认值设为不可变的 None,并在函数体内判断是否为空,按需创建新实例。
def safe_append(items=None):
    if items is None:
        items = []  # 每次调用创建全新的列表
    items.append(len(items))
    return items

r1 = safe_append()
r2 = safe_append()
print(r1 is r2) # False,证明对象完全独立注意:若在外部传入可变对象,函数内部仍会原地修改该对象。如需绝对保护,应在入口处调用 items.copy() 或 list(items)。
第四步:使用唯一哨兵对象处理边界情况
当业务需要区分「未传参」、「显式传入 None」和「传入空集合」三种状态时,可使用独立创建的哨兵对象进行拦截。
_UNDEFINED = object()

def advanced_handler(config=_UNDEFINED):
    if config is _UNDEFINED:
        config = {}  # 应用默认配置
    elif config is None:
        raise ValueError("禁止显式传入 None")

    config['processed'] = True
    return config

print(advanced_handler())          # 使用默认 {}
print(advanced_handler({'x': 1}))  # 使用传入值
该模式依赖于 is 身份比较,能精准捕获未传参状态,避免与合法空值混淆。
第五步:利用装饰器实现自动清理
对于遗留代码库或第三方接口,可通过运行时包装自动替换可变默认值,降低重构成本。
from functools import wraps
import inspect

def sanitize_mutable_defaults(func):
    sig = inspect.signature(func)

    @wraps(func)
    def wrapper(*args, **kwargs):
        bound = sig.bind(*args, **kwargs)
        bound.apply_defaults()

        for param_name, value in bound.arguments.items():
            param_obj = sig.parameters[param_name]
            if param_obj.default is inspect.Parameter.empty:
                continue
            if isinstance(param_obj.default, (list, dict, set)):
                bound.arguments[param_name] = None

        return func(*bound.args, **bound.kwargs)

    return wrapper

@sanitize_mutable_defaults
def legacy_cache(data={}, cache={}):
    cache.append(data)
    return cache

print(legacy_cache('a'))  # 输出 ['a']
print(legacy_cache('b'))  # 输出 ['b'],不再累积
该装饰器在调用前拦截签名绑定的参数,识别并替换掉列表、字典等可变默认值,从而在不修改原函数体的前提下恢复预期行为。涉及大规模替换时,建议先在测试环境验证类型兼容性与性能开销。
以上就是Python可变默认参数陷阱案例和解决方案的详细内容,更多关于Python函数参数设计与代码质量优化的资料请关注本站其它相关文章!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















