


Python JSON读写指南:loads、load、dumps、dump实战教程

本文详解Python标准库中json模块的四种核心操作:loads、load、dumps与dump。通过对比数据流向与转换方向,提供完整的参数设置、代码示例与执行结果对照,帮助开发者快速掌握JSON数据的读写与格式转换技巧。
Python JSON数据序列化与文件读写指南
在Python开发中,JSON是最常用的数据交换格式。Python内置的json模块提供了四个基础方法来实现数据序列化与反序列化。选择正确的方法取决于两个关键维度:操作对象是内存中的字符串还是磁盘文件,以及目标是解析数据还是导出数据。
这四个方法的命名遵循统一规律:
.load(s)表示将JSON数据转换为Python对象(反序列化/解析).dump(s)表示将Python对象转换为JSON格式(序列化/写入)- s结尾的方法针对字符串处理
- 无s结尾的方法针对文件对象处理
第1步:使用 loads 将JSON字符串转为Python字典
目的:接收内存中的JSON格式字符串,将其解析为对应的Python字典或列表类型,便于程序内部调用与修改。
入口与动作:调用json.loads()函数,传入目标字符串。
import json

# 模拟从接口返回的JSON字符串
json_str = '{"Content-Type":"application/json","Authorization":"wwtoken"}'
print("原始类型:", type(json_str))

# 解析为Python字典
parsed_data = json.loads(json_str)
print("解析后类型:", type(parsed_data))
print("解析结果:", parsed_data)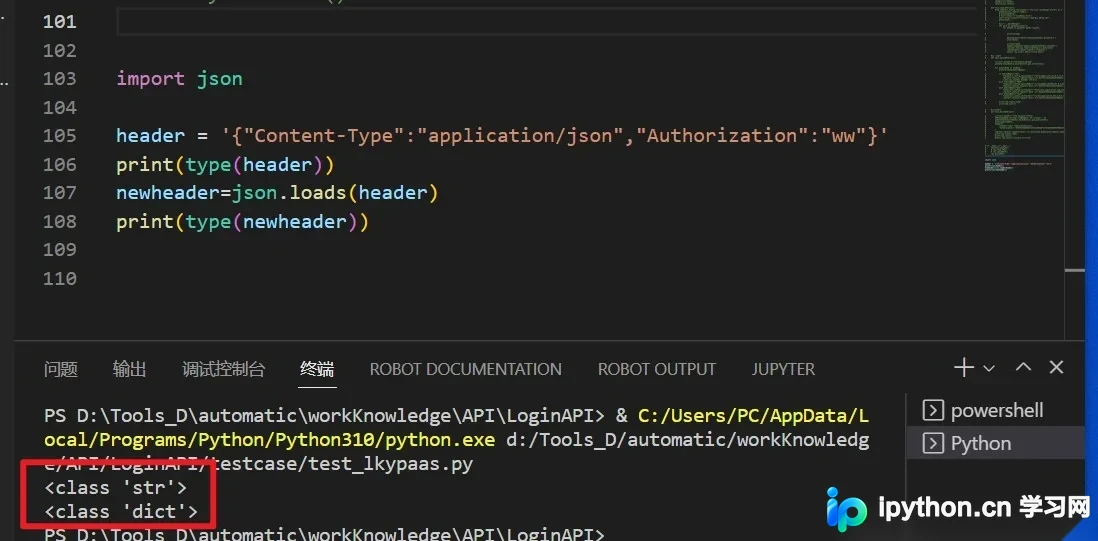
完成状态:控制台打印出<class 'dict'>,且可通过parsed_data["Key"]直接获取字段值。
第2步:使用 dumps 将Python字典转为JSON字符串
目的:将内存中的字典或列表等Python对象序列化为标准JSON字符串,用于网络传输、日志记录或前端展示。
入口与动作:调用json.dumps()函数,传入Python对象。
import json

python_dict = {"Content-Type": "application/json", "Authorization": "wwtoken"}
print("原始类型:", type(python_dict))

# 序列化为JSON字符串
serialized_str = json.dumps(python_dict)
print("序列化后类型:", type(serialized_str))
print("序列化结果:", serialized_str)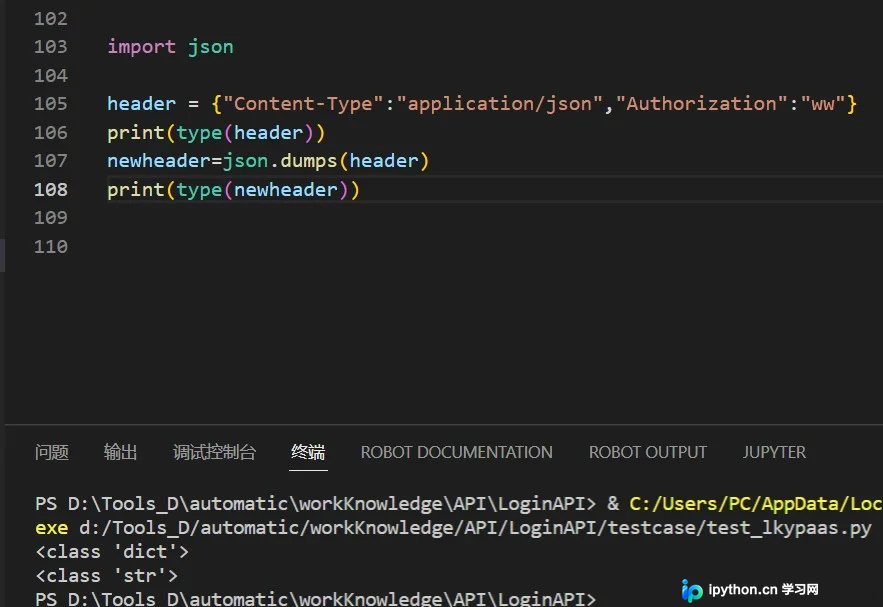
完成状态:输出结果为合法的JSON字符串文本,可直接存入文件或发送HTTP请求。
第3步:使用 load 读取本地JSON文件
目的:直接从磁盘打开已存在的JSON文件,将其内容加载并转换为Python对象。适用于配置文件读取、测试用例加载等场景。
入口与动作:使用Python原生open()以读取模式打开文件,并将文件句柄传递给json.load()。
# 假设存在 allVersion.json 文件
file_path = "config/allVersion.json"

with open(file_path, "r", encoding="utf-8") as f:
    # 自动解析文件内容并转换为Python对象
    config_data = json.load(f)
    print("加载类型:", type(config_data))
print("文件内容:", config_data)注意:若坚持使用json.loads读取文件,需先通过f.read()获取文本流再传入,但会额外增加内存开销,直接使用json.load更为高效且语义准确。
完成状态:上下文管理器自动关闭文件流,内存中获得可直接操作的字典/列表结构。
第4步:使用 dump 将数据写入JSON文件
目的:将Python对象持久化保存为JSON格式文件,常用于数据缓存、配置备份或结果导出。
入口与动作:同样配合open(),以写入模式创建或覆盖文件,将Python对象作为第一个参数传入json.dump()。
output_path = "config/output.json"
data_to_save = {"Content-Type": "application/json", "Authorization": "wwtoken"}

with open(output_path, "w", encoding="utf-8") as f:
    # 写入时建议添加 indent=2 保持排版美观
    json.dump(data_to_save, f, ensure_ascii=False, indent=2)
    print("写入完成,文件已生成。")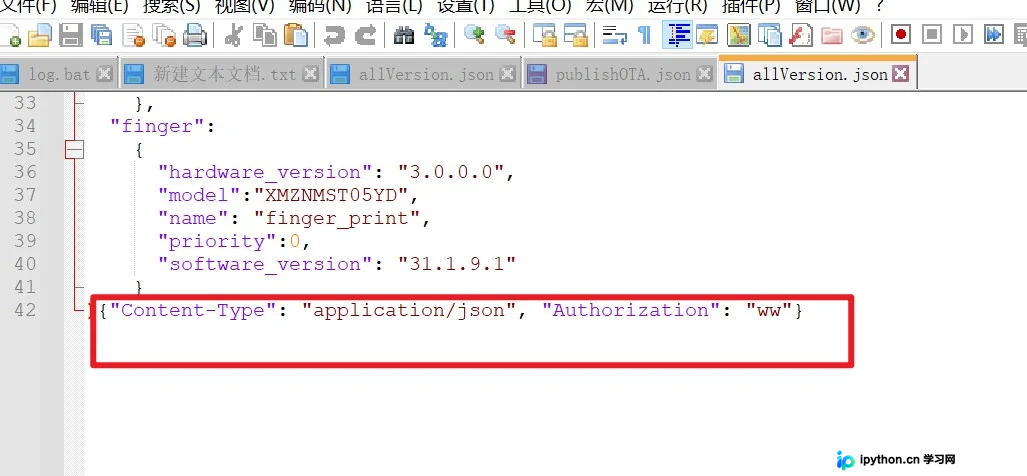
风险提醒:文件写入前请确认路径权限。模式默认为"w"(覆盖写入),若需保留原内容追加请使用"a",但需注意追加可能导致文件内出现多个独立的JSON块而非单一合法JSON数组。
完成状态:指定路径生成.json文件,且文件大小与内容符合预期。
验证与排错建议
完成上述操作后,可通过以下特征判断流程是否成功:
- 类型核对:解析后必为
dict或list;序列化后必为str。 - 格式检查:写入的文件可使用任何标准JSON校验工具或IDE插件检测是否包含非法字符。
- 编码问题:中文或特殊字符在导出时务必设置
ensure_ascii=False,否则会被强制转义为Unicode编码串。
以上就是Python JSON文件读写操作中loads、load、dumps、dump四种方法的核心原理与实践指南,更多关于Python数据处理与自动化脚本编写的资料请关注本站其它相关文章!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















