


使用Python调用OCR文字识别API的实现教程

本文详解如何使用Python调用第三方OCR文字识别API。通过获取密钥、安装依赖库、编写Base64编码与HTTP请求代码,快速实现通用及专项图文提取。附带参数配置说明、结果解析方法及识别效果优化建议,帮助开发者在身份核验、票据扫描等场景中稳定集成文字识别功能。
准备运行环境与测试素材
在开始代码编写前,需明确接口调用的核心链路:本地读取图片 → 转换为Base64字符串 → 拼接鉴权Header与JSON Body → 发送HTTP POST请求 → 解析结构化返回数据。以下是标准操作顺序。
第1步:安装Python依赖库
目的:构建网络通信与图像预处理的基础运行环境。
入口:系统终端或IDE内置Terminal。
动作:执行包管理命令:pip install requests pillow
重要参数:requests 负责HTTP通信;pillow 提供高级图像格式支持与裁剪功能(可选)。
完成状态:终端显示依赖安装成功提示且无冲突日志。
第2步:获取API访问凭证
目的:取得合法的接口调用授权标识。
入口:目标OCR服务商控制台或开发者中心页面。
动作:完成开发者注册后,在应用管理列表中创建新项目,复制生成的 AppCode。
重要参数:凭证具有有效期与配额限制,建议通过环境变量注入而非硬编码。
完成状态:获得完整的鉴权字符串备用。
第3步:编写图片读取与编码函数
目的:将本地物理文件转换为符合传输协议的编码格式。
入口:新建脚本文件(如 ocr_call.py)。
动作:利用Python内置 base64 模块与文件句柄读取二进制流并编码:
# 接口文档:https://market.shiliuai.com/doc/advanced-general-ocr
import requests
import base64
import json

# 请求接口
URL = "https://ocr-api.shiliuai.com/api/general_ocr/v1"

# 图片转base64
def get_base64(file_path):
    with open(file_path, 'rb') as f:
        data = f.read()
    b64 = base64.b64encode(data).decode('utf8')
    return b64
重要参数:文件路径需指向有效图像;编码后字符集必须声明为 utf8 以防乱码中断。
完成状态:函数接收合法图片路径并返回长度正常的字符串。
第4步:构造HTTP请求并调用接口
目的:建立客户端与服务端的鉴权连接并递交数据。
入口:主逻辑函数区。
动作:封装请求头与JSON载荷:
def call_ocr(appcode, file_path):
    headers = {
        'Authorization': f'APPCODE {appcode}',
        'Content-Type': 'application/json'
    }
    payload = {"image_base64": get_base64(file_path)}
    response = requests.post(url=URL, headers=headers, json=payload)
    print(response.json())

if __name__ == "__main__":
call_ocr("你的APPCODE", "本地测试图片路径.png")重要参数:请求体仅二选一传参:image_base64 或 image_url;单图大小需小于20MB且像素维度介于15~8192之间。如需强制单行识别,追加 {"is_line": true}。
完成状态:终端输出包含 code 与 data 字段的字典对象。
解析响应结构与验证识别效果
成功调用后,服务端返回标准JSON结构。关键字段对照如下:
| 字段名 | 类型 | 业务含义 |
|---|---|---|
code | int | 状态码,200或0通常代表成功 |
success | bool | 整体任务执行标志位 |
data.content[] | list | 识别到的文字块集合 |
text | string | 原始识别文本内容 |
prob | float | 置信度评分,范围[0.0, 1.0] |
keypoints | list | 文字区域四个角坐标(顺时针),单行模式不返回此项 |
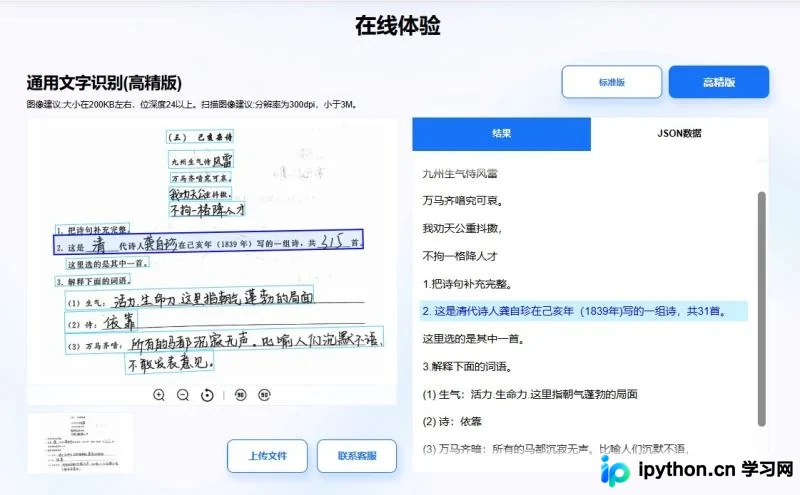
核对完成状态:当 success 为真且 data.content 列表非空时,表示图文提取流程闭环。
常见优化技巧与排错指南
清晰图片优先
模糊、严重倾斜或存在强反光的截图会直接拉低 prob 值。建议在传入前使用Pillow执行仿射变换校正或直方图均衡化处理。
裁剪或分区识别
针对发票、证照等固定版式材料,提前按ROI(感兴趣区域)裁剪可避开无关背景干扰,显著提升版面分析精度。
批量或异步处理
面对海量单据场景,避免阻塞式同步循环。可引入 concurrent.futures 多线程池并发下发请求,降低总耗时。
错误处理机制
生产环境必须包裹 try...except 捕获网络超时或协议变更异常。重点关注返回的 msg_cn 字段定位业务拦截原因(如频次超限或签名校验失败)。
总结
本文逐步演示了从环境准备、凭证申请、Base64编码转换、POST请求构造到响应字段解析的完整工作流。通过标准化代码模板与参数边界控制,开发者可在数分钟内将通用文字提取能力嵌入桌面端工具或后端微服务。结合前期图像预处理与并发策略,能有效满足高并发验真与自动录入需求。
以上就是使用Python调用OCR文字识别API的详细教程,更多关于Python自动化接口集成与视觉识别技术的资料请关注本站其它相关文章!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















