


Python列表排序报错TypeError怎么办?处理混合类型与None值

None 值的列表直接调用 list.sort() 或 sorted() 时,解释器会抛出 TypeError: '<' not supported between instances of ...。解决这一报错的根本方法,是明确排序的比较基准,通过 key 参数提供统一的映射规则,或者利用元组优先级对 None 值与异构元素进行安全分层。
1. 报错剖析:为什么 Python 3 会拒绝混合类型排序?
许多从 Python 2 迁移过来的开发者,或者刚开始处理爬虫抓取与数据库杂乱数据的读者,常会遇到如下典型报错:
# 场景 1:数字与字符串混合
numbers_and_words = [10, "apple", 5, "20"]
numbers_and_words.sort()
# 抛出:TypeError: '<' not supported between instances of 'str' and 'int'

# 场景 2:列表中包含 None 缺失值
scores = [92, 78, None, 85, None]
sorted(scores)
# 抛出:TypeError: '<' not supported between instances of 'NoneType' and 'int'
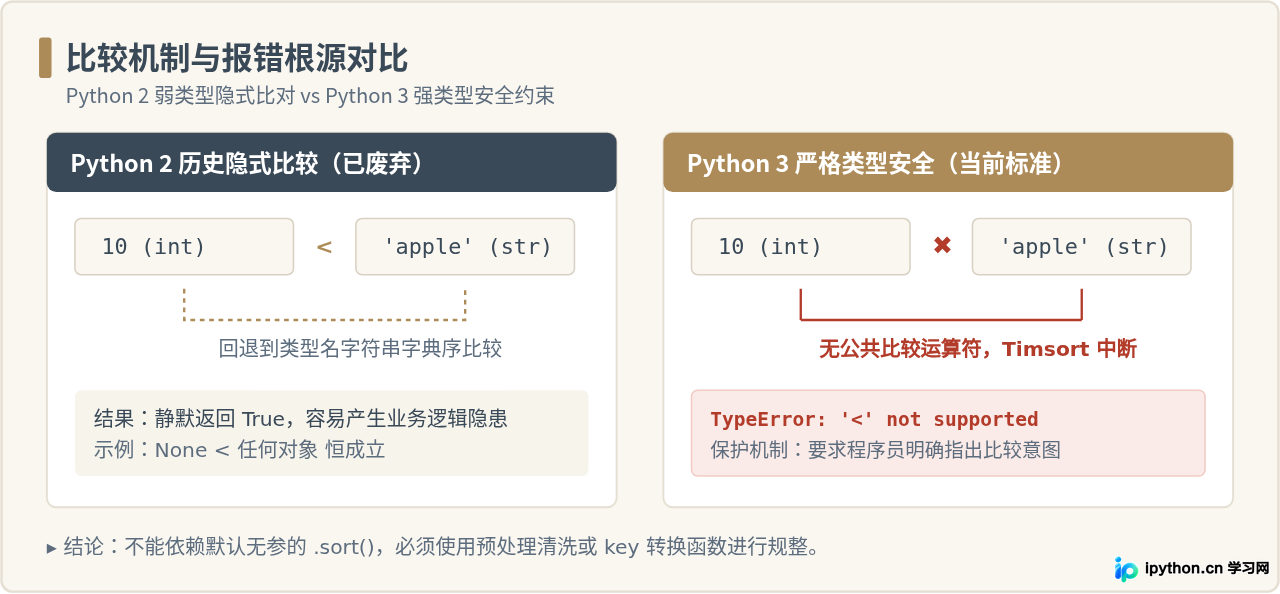
这一报错的根源在于 Python 3 弃用了旧版中不同对象类型之间的隐式大小比较规则。在 Python 2 中,如果两个对象类型不同,解释器会依据内部固定的类型名称字符串规则进行后备比较(例如数字总是小于字符串,None 总是最小),这种行为虽然“容错”,但往往掩盖了严重的数据清洗逻辑漏洞。
Python 3 遵循类型安全原则。内置的 Timsort 算法在执行比较时,依赖元素之间的 <(小于)运算。当它发现 "apple" < 10 或 None < 92 未实现比较方法时,就会立刻中断排序并抛出 TypeError。
2. 处理混合类型列表(数字与字符串并存)
面对既有数字又有字符串的列表,处理思路取决于业务场景中“排序的真正意图”。常见分为两类场景:
场景 A:内容全部代表数值,但部分元素带有引号
例如从 CSV 或请求参数中解析的数据 ["15", 3, "200", 42]。此时意图是按照数值大小排序。解决方案是将所有元素统一转为数值再做比对:
raw_data = ["15", 3, "200", 42, "1.5"]

# 使用 key=float 统一转换为浮点数比较
sorted_data = sorted(raw_data, key=float)
print(sorted_data)
# 输出示例:['1.5', 3, '15', 42, '200']
# 注意:原列表元素保持原有数据类型不变,仅在排序时映射为其浮点值
场景 B:包含真正的文字与数字,希望分组有序排列
如果列表中包含纯文本 ["apple", 42, "banana", 10],直接 key=int 会报 ValueError,直接 key=str 会将数字转为字符(导致 "10" 排在 "2" 前面,违反数值直觉)。
最优雅、稳健的解法是利用 元组优先级键(Tuple Key Technique):
items = ["banana", 10, "apple", 42, 2]

# 规则:数字排在前面,字符串排在后面;组内各自按自身规则排序
def mixed_sorter(val):
    if isinstance(val, (int, float)):
        return (0, val)       # 第0组:数字,比对数值大小
    return (1, str(val))      # 第1组:文本,比对字典序

result = sorted(items, key=mixed_sorter)
print(result)
# 输出结果:[2, 10, 42, 'apple', 'banana']
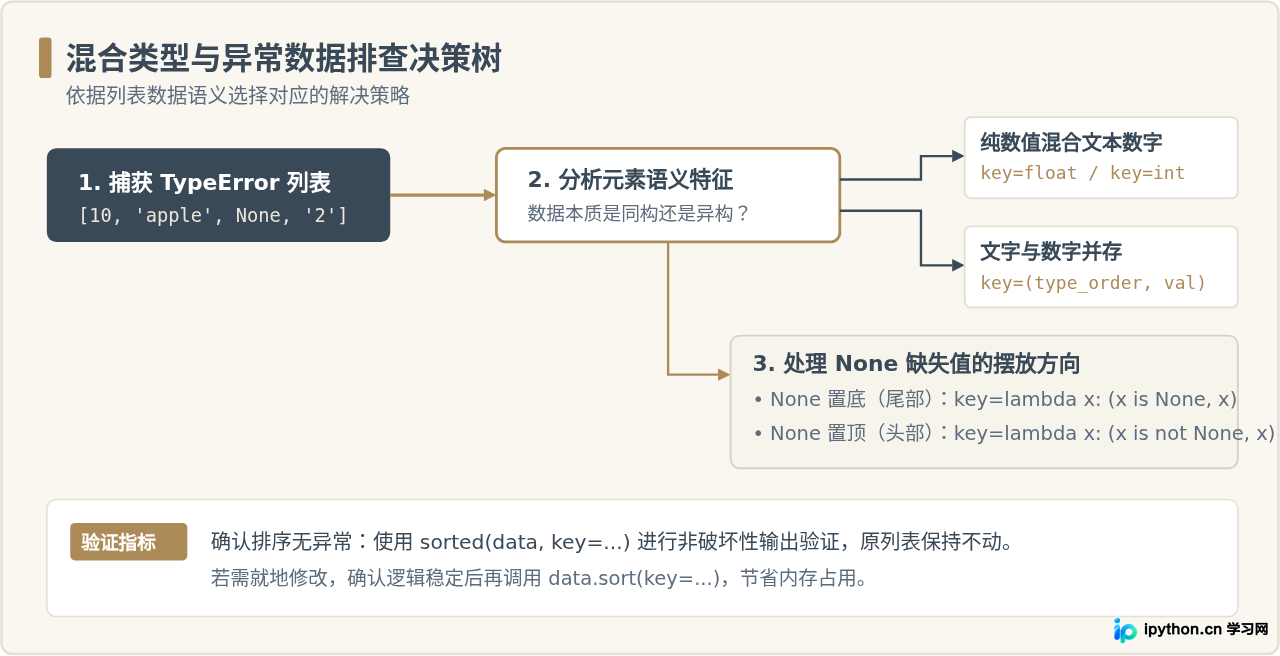
元组键工作原理:Python 比较元组 (a1, a2) 与 (b1, b2) 时,先比第一项。因为 0 < 1,所有数字必定排在所有文本之前;若第一项相同(如都是 0),则进一步比对第二项的值。不同类型被完全隔开,避免了直接交互。
3. 处理包含 None 值的列表:精确控制置顶与置底
在真实业务开发中,最常引起 TypeError 的并非字符串和数字混杂,而是数据源中出现了空值 None。例如接口返回的用户年龄、考试成绩等,未填写的往往是 None。
面对 None,业务通常有两种需求:将 None 视为缺失排在最末尾(置底),或者优先展示缺失项排在最前(置顶)。
方案一:None 置底(排在末尾)——元组布尔键
Python 中 False < True 是确定成立的(bool 是 int 的子类,对应 0 与 1)。利用这一点,我们可以构造如下一行代码:
scores = [85, None, 92, 60, None, 75]

# 核心代码:None 置底
sorted_scores = sorted(scores, key=lambda x: (x is None, x))
print(sorted_scores)
# 输出结果:[60, 75, 85, 92, None, None]
为什么不会再报 TypeError?
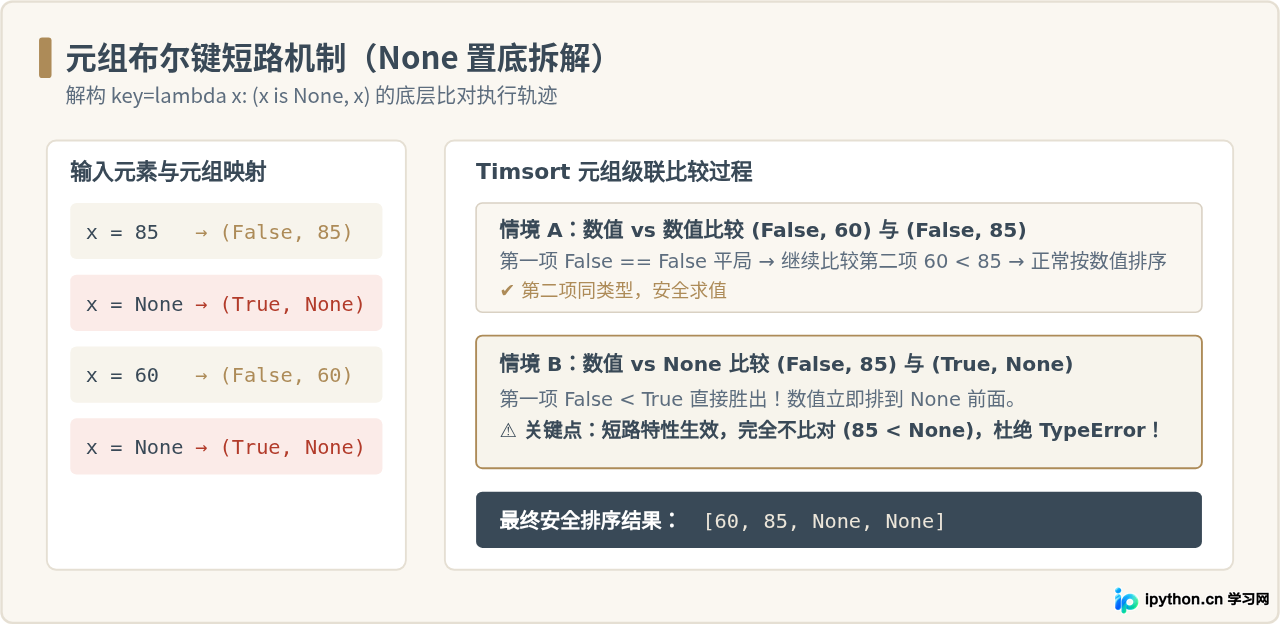
让我们观察每个元素对应的 key 返回值:
- 数值
85对应(False, 85) - 空值
None对应(True, None)
当正常数值与正常数值比较时:第一项都是 False,继续比较第二项 85 < 92,正常比大小;
当正常数值与 None 比较时:第一项是 False 与 True,由于 False < True 已经分出胜负,Python 根本不会去比对元组的第二项!因此 85 < None 的比较被完全短路跳过,彻底根治报错。
方案二:None 置顶(排在最前面)
反之,如果希望把 None 排在列表最前(例如待审核队列中未处理项置顶),只需颠倒布尔判断:
# 核心代码:None 置顶
sorted_first = sorted(scores, key=lambda x: (x is not None, x))
print(sorted_first)
# 输出结果:[None, None, 60, 75, 85, 92]
此时 None 产生 (False, None),正常数值产生 (True, val),None 自然排列在最前端。
方案三:使用无穷值或替补值(仅限纯数值列表)
如果确定列表中非 None 元素全为数字,还可以直接通过正负无穷大(float('inf') 或 float('-inf'))进行替代比对:
# None 当作正无穷大,置底
sorted(scores, key=lambda x: float('inf') if x is None else x)

# None 当作负无穷小,置顶
sorted(scores, key=lambda x: float('-inf') if x is None else x)
注意:该方案不适用于字符串列表,因为字符串与 float('inf') 同样不支持比较。因此元组键是更普适的工程解法。
4. 进阶综合场景:数字、字符串与 None 同时存在
最棘手的真实数据往往是三者混合:列表里同时有整型、浮点数、文本字符串以及 None,比如爬取商品信息时的数据:
complex_list = [100, "99", None, "折扣款", 25.5, None, "包邮", 0]此时单个简单的 lambda 表达式已难以承载清晰的逻辑,编写一个专用的排序辅助函数是最佳实践:
def advanced_sort_key(item):
    """
    通用分层排序键:
    - 组 0:有效数字,按数值升序
    - 组 1:文本字符串,按字典序升序
    - 组 2:None 缺失值,统一置底
    """
    if item is None:
        return (2, 0)

    # 尝试将能转成数字的字符串或纯数字统一归为数值组
    try:
        num = float(item)
        return (0, num)
    except (ValueError, TypeError):
        pass

    # 其余纯文本归为字符串组
    return (1, str(item))

sorted_result = sorted(complex_list, key=advanced_sort_key)
print(sorted_result)
# 输出结果:[0, 25.5, '99', 100, '包邮', '折扣款', None, None]
在这个例子中,"99" 成功被识别为数值组与 100 比较,"包邮" 归入文本组,而两个 None 则平稳沉底。代码结构层次分明,团队协作时可读性极强。
5. 核心方案速查与易错点避坑
在实际运用中,还需要警惕以下三个容易被忽视的细节问题:
如果数据中含有浮点缺失值
float('nan'),它不会报 TypeError,但因为 IEEE 754 标准规定 nan == nan 为 False 且任何与 nan 的比对均为 False,会导致 Timsort 比较传递性破损,从而产生不可预测的随机乱序。处理前务必使用 math.isnan() 将其视同 None 规整。
list.sort() 与产生新列表 sorted()如果数据量较大(例如数十万条),
sorted() 会完整复制一份列表,增加一倍内存开销。若原列表不再需要保留原始顺序,优先使用 raw_list.sort(key=...) 原地排序。
| 场景需求 | 推荐解决方案 | 优点与限制 |
|---|---|---|
| 纯数字混有字符串数字 | key=float |
简单高效;但如果存在非数字文本会抛出 ValueError |
| 正常值中混有 None(置底) | key=lambda x: (x is None, x) |
普适性强,短路保护,支持数字与字符串列表 |
| 正常值中混有 None(置顶) | key=lambda x: (x is not None, x) |
代码精简,稳定将 None 优先排在最前 |
| 异构混合(数字+文本+None) | 自定义独立辅助函数,分层返回元组 | 逻辑清晰、扩展性极佳,适合复杂业务逻辑处理 |
总结
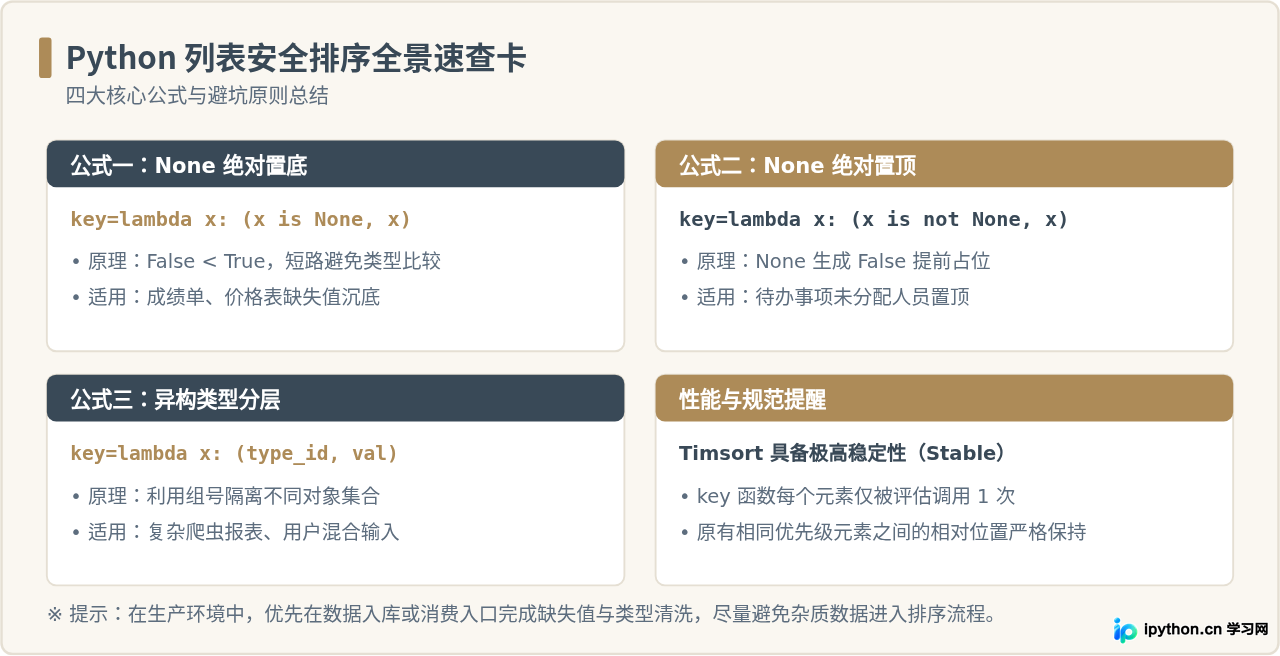
Python 列表排序报错 TypeError 是强类型语言环境下的保护机制,而非系统缺陷。面对混合类型和 None 值时:
- 若数据本质均为同类数值,使用
key=float统一映射维度; - 若希望对
None进行有序安置,使用key=lambda x: (x is None, x)(置底)或key=lambda x: (x is not None, x)(置顶),利用元组比较的短路特性完美规避类型冲突; - 对于高度复杂的异构列表,编写清晰的元组分层排序函数,不仅能精准控制每种类型在全局的先后顺序,还能保证组内元素的稳定排序。
通过合理配置 key 参数,开发者无需繁琐地过滤、拆分再合并列表,一行代码即可优雅高效地完成带异常值的排序任务。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















