


Python有哪些内置数据类型

Python作为动态类型语言,在标准解释器中直接内置了涵盖数值、文本、集合结构以及底层二进制缓冲等完备的数据类型体系。这些内置类型无需额外引入模块即可直接使用,是构建程序逻辑和组织内存数据的基石。从逻辑范畴上划分,Python内置数据类型主要由六大核心大类构成:数值类型、序列类型、映射类型、集合类型、布尔与空值类型,以及专门用于底层I/O处理的二进制类型。
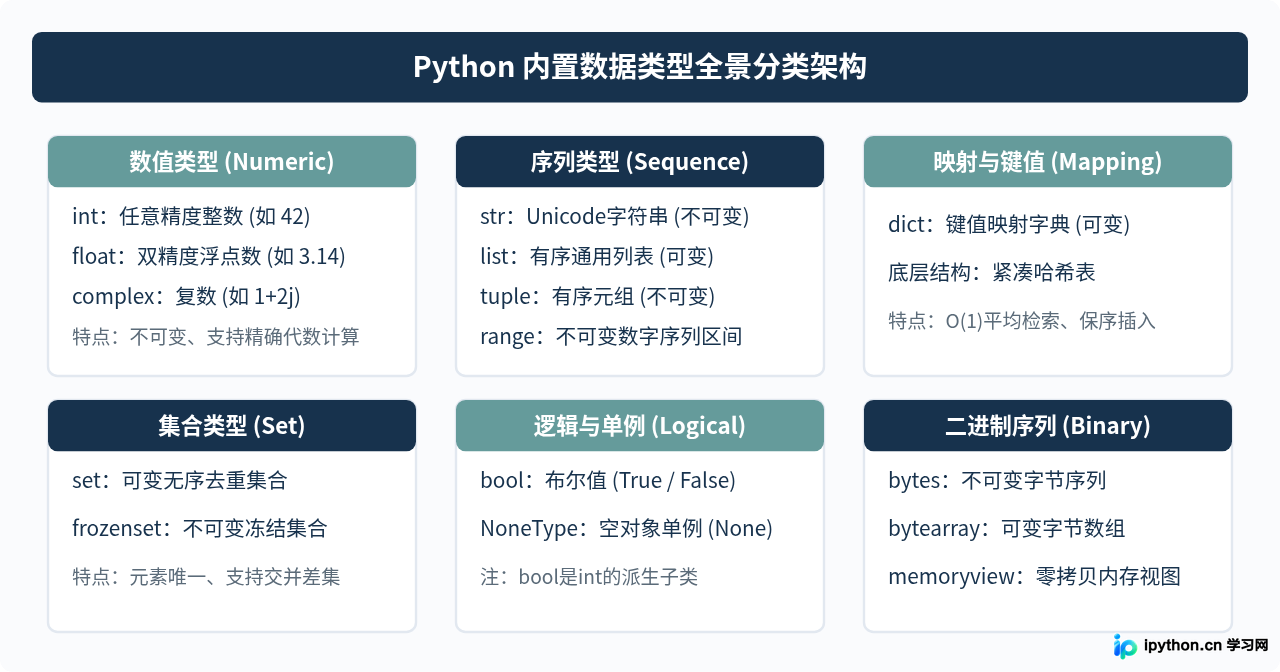
一、各内置类型的核心定义与语法特征
深入掌握Python类型的关键在于理解各类型的内在机制、值表现方式以及它们各自解决的问题。
1. 数值类型与布尔型
Python提供了高精度的数学计算原生支持:
- int(整型):在Python 3中,整型不再区分普通整数与长整数,具备动态任意精度,不会出现C语言风格的整型溢出。
- float(浮点型):底层采用C语言的double实现(IEEE 754双精度64位浮点),能够表达约15-17位有效十进制数字。
- complex(复数):由实部和虚部构成,虚部使用字母
j或J表示,如z = 3 + 4j。 - bool(布尔型):仅有两个实例
True和False。在Python底层,bool继承自int,True对应的数值即为 1,False对应的数值即为 0。
# 数值类型示例
count = 100_000_000            # 允许使用下划线作为数值分隔符提高可读性
ratio = 0.85                   # float
c_num = 2 + 5j                 # complex
is_active = True               # bool

# bool是int的子类证明
print(isinstance(True, int))   # 输出: True
print(True + 1)                # 输出: 2
2. 序列类型:文本与有序集合
序列类型支持通过非负整数进行索引、切片访问以及按顺序迭代遍历:
- str(字符串):表示文本数据,本质是不可变的Unicode字符序列。Python 3严格区分Unicode文本与原始字节。
- list(列表):动态大小、异构可变序列,使用方括号
[]声明。元素可以随时增删改查。 - tuple(元组):固定大小、异构不可变序列,使用圆括号
()声明。常用于记录结构体式数据或作为字典的合法键。 - range(区间):表示不可变的等差数字序列,通常用于控制
for循环次数,占用固定且极小的内存空间。
3. 映射与集合类型
- dict(字典):键值对(Key-Value)映射,键必须是可哈希(不可变)的对象。自Python 3.7起,标准规范已正式保证字典保留元素的插入顺序。
- set(集合):无序且不重复的元素集合,具备高效率的成员检测能力,并支持交集
&、并集|、差集-计算。 - frozenset(冻结集合):
set的不可变版本,因其不可变而具备哈希值,可以作为字典的键或另一个集合的元素。
4. 二进制序列与特殊单例
针对文件IO、网络通信和底层协议封装,Python内置了专门的二进制处理类型:
- bytes:由原始8位单字节(0-255)构成的不可变序列,如
b"hello"。 - bytearray:支持原地修改的字节缓冲区,适用于高频数据包拼接修改。
- memoryview:基于Python缓冲区协议(Buffer Protocol)构建,可以在不进行内存复制的情况下对字节数据进行切片。
- NoneType:其唯一实例为
None,用于表达“无值”、“空”或函数的默认缺省返回。
二、核心容器类型的关键特性与矩阵对比
在日常开发中,容器类型的选择直接决定了程序的时间复杂度与内存表现。理解可变性(Mutability)与哈希机制是做出正确架构决策的核心前提。
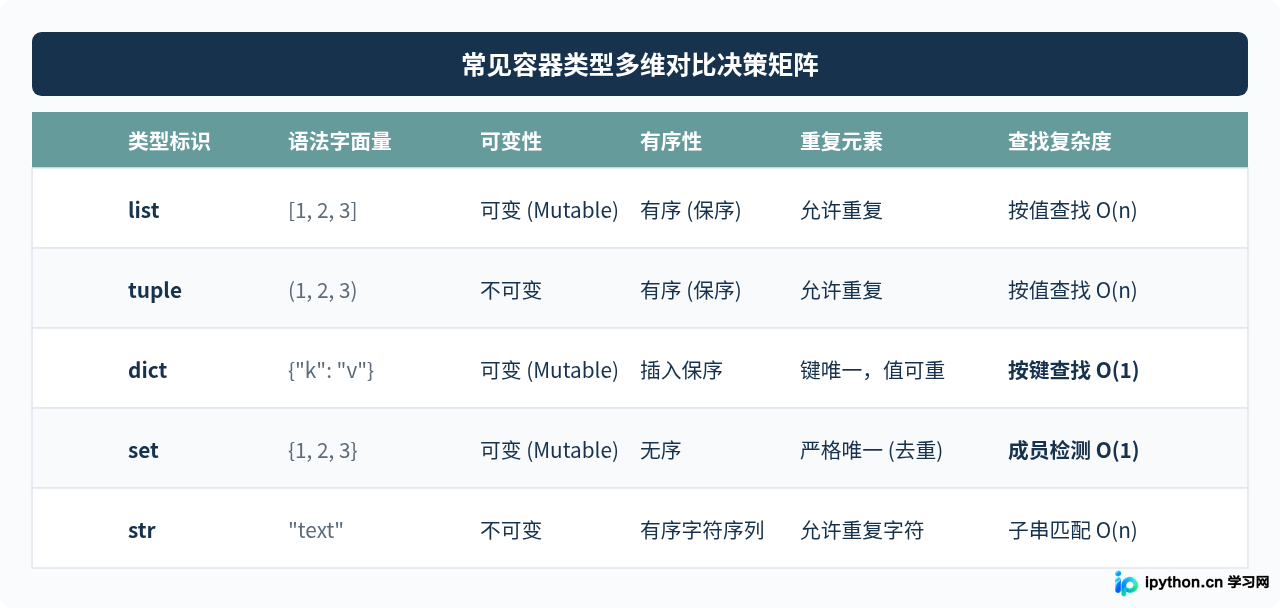
可变性边界提醒:当不可变容器包含可变对象时,容器本身的引用序列不可变更,但内部对象仍然可以被修改。例如元组 t = (1, [2, 3]) 中,元组长度和指向列表的内存指针不可变,但可通过 t[1].append(4) 原地修改内部列表内容。因此,包含可变对象的元组不能被哈希,无法作为字典键。
三、类型推导、检查与安全转换操作步骤
在实际编码与数据清洗过程中,正确识别数据类型并实施防错转换是一项基础工程规范。以下展示类型判断与安全转换的标准操作路径。
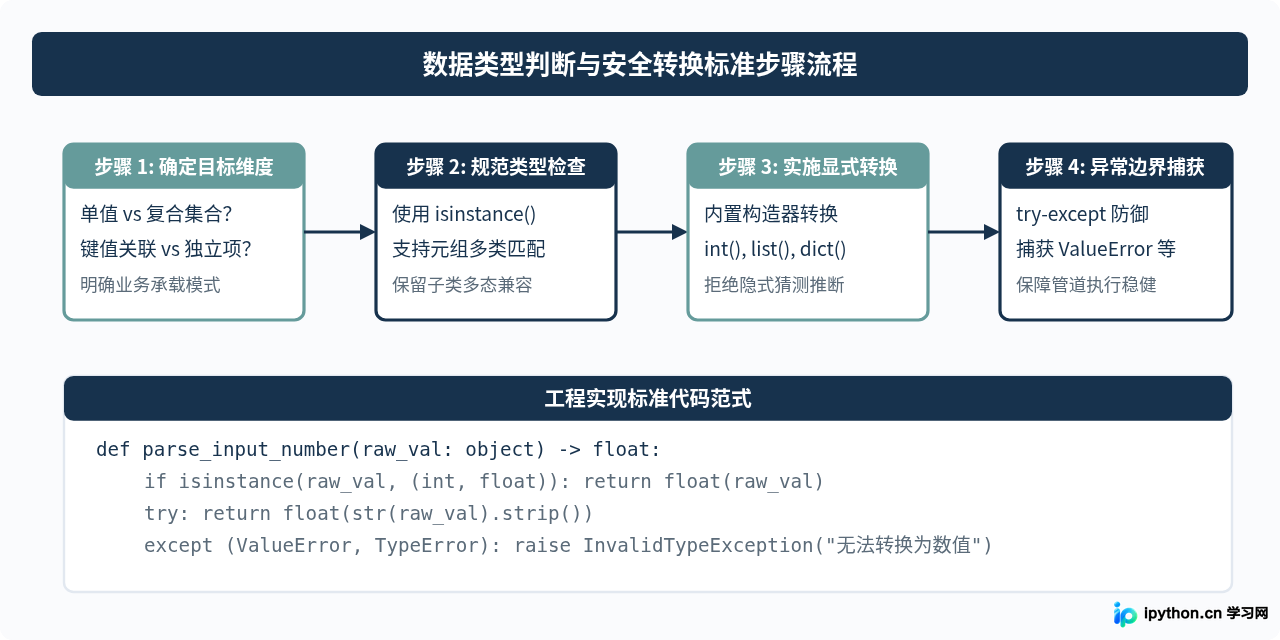
1. 为什么优先使用 isinstance() 而非 type()
在判断变量类型时,初学者常使用 type(obj) == target_type。这种做法破坏了面向对象的继承与多态机制。例如布尔值 True 在底层是整型的子类:
# type() 与 isinstance() 比较
x = True

print(type(x) == int)         # 输出: False,未能识别继承关系
print(isinstance(x, int))     # 输出: True,能正确识别继承与派生

# isinstance 支持元组传入,进行多类型联合校验
def process_data(item):
    if not isinstance(item, (list, tuple, set)):
        raise TypeError("必须提供可迭代的集合容器")
    return len(item)
2. 常见类型构造与转换陷阱
- 字符串与不可变字节:文本
str与二进制bytes之间不能隐式混用,必须显式调用.encode("utf-8")和.decode("utf-8")。 - 字典视图对象的转换:
dict.keys()、dict.values()和dict.items()返回的是动态视图对象,若需通过下标索引,需显式包装为list(my_dict.keys())。 - 单一元素元组的语法陷阱:
t = (1)的类型是int而非tuple,必须添加尾随逗号t = (1,)才能被识别为元组。
四、常见开发误区与规避准则
内置类型虽简单直观,但其底层对象引用模型若理解不当,极易引发难以排查的边界缺陷:
1. 可变对象作为函数默认参数
函数的默认参数在模块加载定义时仅求值一次。如果将 list 或 dict 作为默认参数,所有未传入该参数的函数调用将共享同一内存对象:
# 错误示例:默认列表会被多次调用累积共享
def append_item(val, container=[]):
    container.append(val)
    return container

# 正确做法:使用不可变的 None 作为哨兵值
def append_item_safe(val, container=None):
    if container is None:
        container = []
    container.append(val)
    return container
2. 浅拷贝(Shallow Copy)与深拷贝(Deep Copy)
使用 list.copy() 或切片 lst[:] 创建的是浅拷贝,仅复制外层容器本身。当列表中包含嵌套列表或字典时,嵌套对象仍然指向同一内存地址。如果需要完全独立的副本,应使用标准库的 copy.deepcopy()。
五、全景总结与选型速查
Python的内置数据类型设计高度精炼,兼顾了易用性与底层运行效率。在构建系统时,可以依据以下规则进行速查与决策:
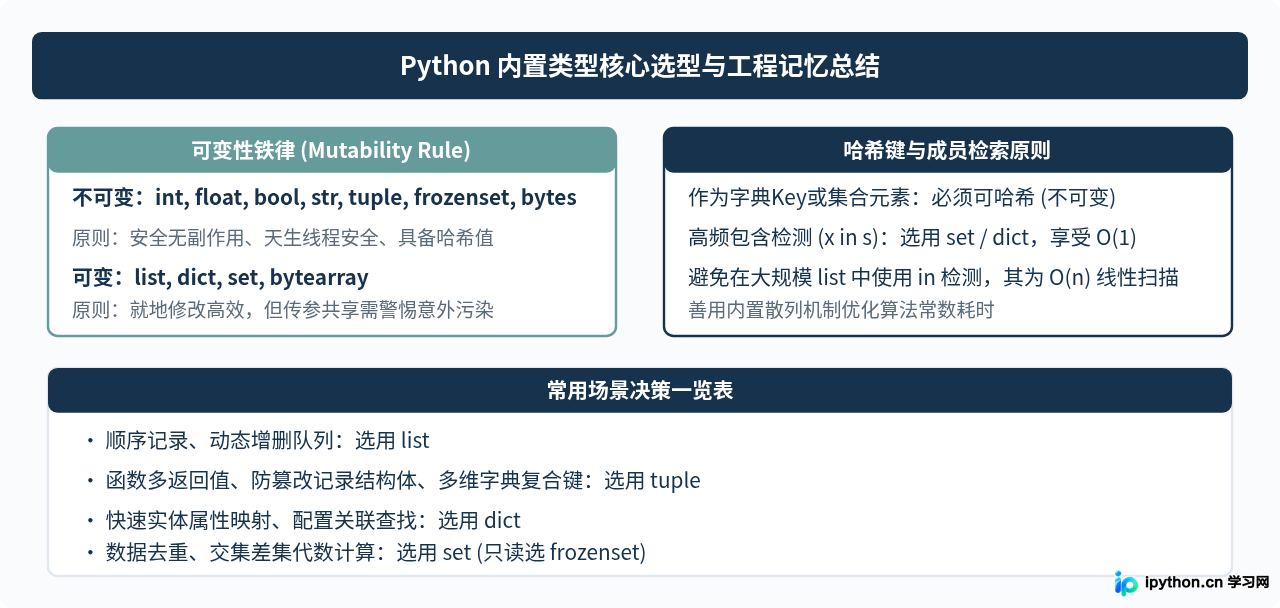
掌握内置数据类型不仅是记住其语法形式,更在于洞悉其可变性差异、时间复杂度特征与内存表现。合理选择并组合这些内置基础组件,才能写出健壮、高效且具备Python特性的高质量代码。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















