


Python能做什么:从数据分析到自动化办公的实际应用

在企业日常运转和业务协作中,Python最直接的实用价值并非开发底层软件或大型架构,而是作为连接异构业务数据与人工操作链条的高效胶水。它能够接管重复耗时的表格汇算、跨格式文件流转以及常规周期性报告整理,将长达数小时的人工点击压缩至数秒完成的程序化流程;同时依托健全的数据科学函数库,为实际商业决策提供数据清洗、多维汇总与可视化呈现的扎实支撑。
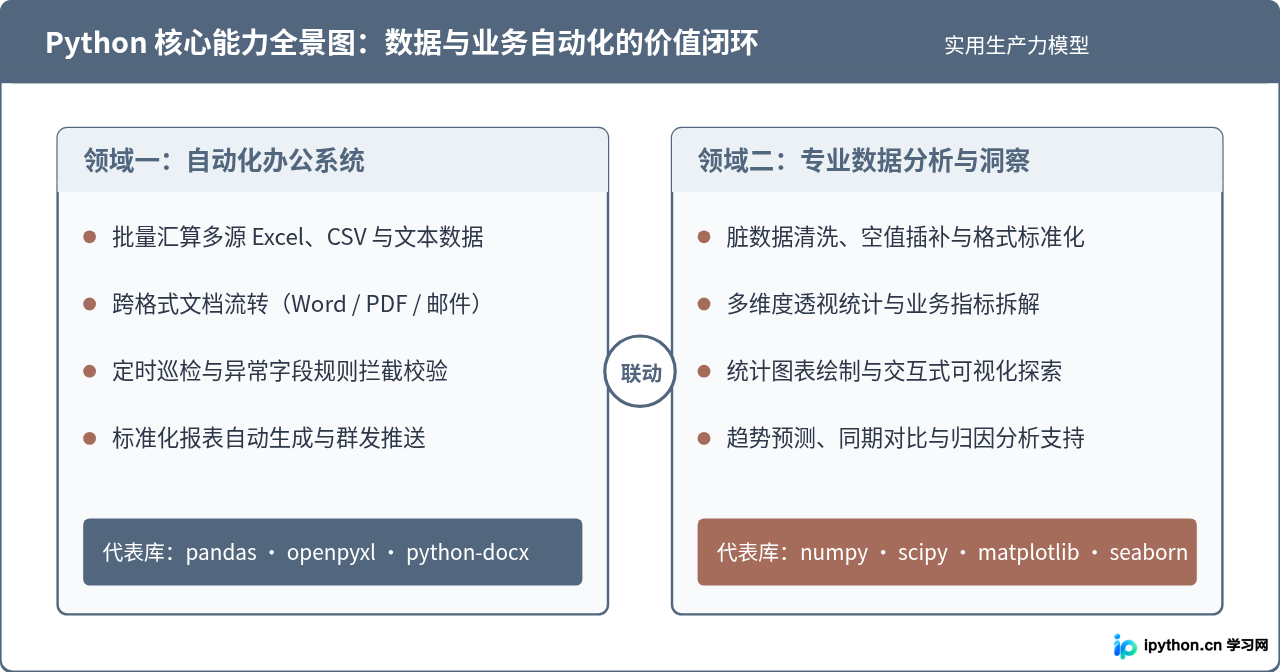
一、自动化办公:解决重复劳动的工程化路径
在未引入程序化工具之前,许多岗位的日常工作充斥着大量的机械复制与粘贴。例如跨部门收集的上百张周报表格、定期将系统导出的明细制作成特定样式的汇报PPT、或者针对不同供应商分别导出PDF对账单。这类操作不仅侵占了业务人员的思考时间,而且极易由于手工疲劳导致关键数值录入偏差。
Python解决此类问题的核心在于“将隐性经验固化为明确规则”。通过脚本直接与文件系统交互,能够实现全自动的批量提取、校验、计算与分发。
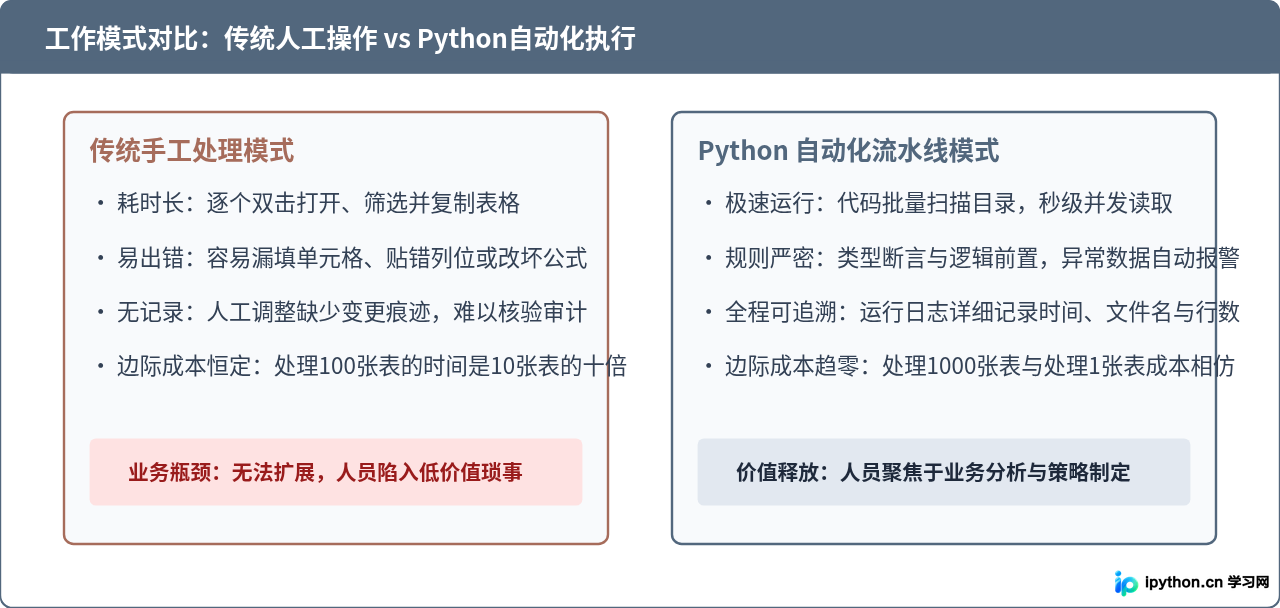
1.1 批量合并Excel表格示例
在实际运营中,最频繁的需求之一就是将分散在文件夹中的多个分公司周报或销售记录,合并为一张总表并剔除异常记录。以下脚本展示了如何使用 pandas 和标准库 pathlib 完成该任务:
import os
from pathlib import Path
import pandas as pd

def merge_weekly_reports(input_dir: str, output_file: str):
    folder = Path(input_dir)
    excel_files = list(folder.glob("*.xlsx"))

    if not excel_files:
        print("未在目标路径检测到任何 .xlsx 格式文件。")
        return

    collected_frames = []

    for file_path in excel_files:
        # 跳过临时缓存文件
        if file_path.name.startswith("~$"):
            continue

        try:
            # 读取目标工作表并追加来源标记
            df = pd.read_excel(file_path, sheet_name=0)
            df["来源文件"] = file_path.name

            # 基础数据校验:过滤关键编号为空的无效行
            if "订单编号" in df.columns:
                df = df.dropna(subset=["订单编号"])
                collected_frames.append(df)
            else:
                print(f"文件 {file_path.name} 缺少必要列'订单编号',已跳过。")
        except Exception as err:
            print(f"读取文件 {file_path.name} 失败:{err}")

    if collected_frames:
        final_df = pd.concat(collected_frames, ignore_index=True)
        # 将结果输出到目标文件
        final_df.to_excel(output_file, index=False)
        print(f"合并完成!共汇总 {len(collected_frames)} 个文件,累计 {len(final_df)} 行有效数据。")
    else:
        print("未提取到任何有效数据帧,终止写入。")

# 执行合并调用(示例路径)
# merge_weekly_reports("./周报汇总", "./销售总账汇总.xlsx")~$ 开头)。如果不进行判断直接交由 pd.read_excel 解析,会导致程序崩溃。在自动化脚本中应始终包含文件名防御检查。
二、数据分析:从混乱表单到业务洞察
数据分析不是单纯画几张柱状图,而是一套严密的问题解决流。很多初学者以为拿到数据就能直接统计,但实际工程中至少有70%的时间消耗在数据清洗(Data Cleaning)上。真实世界的业务表格往往包含格式不一的时间文本、多余的空格、混杂的货币符号、甚至人为手填的错别字。
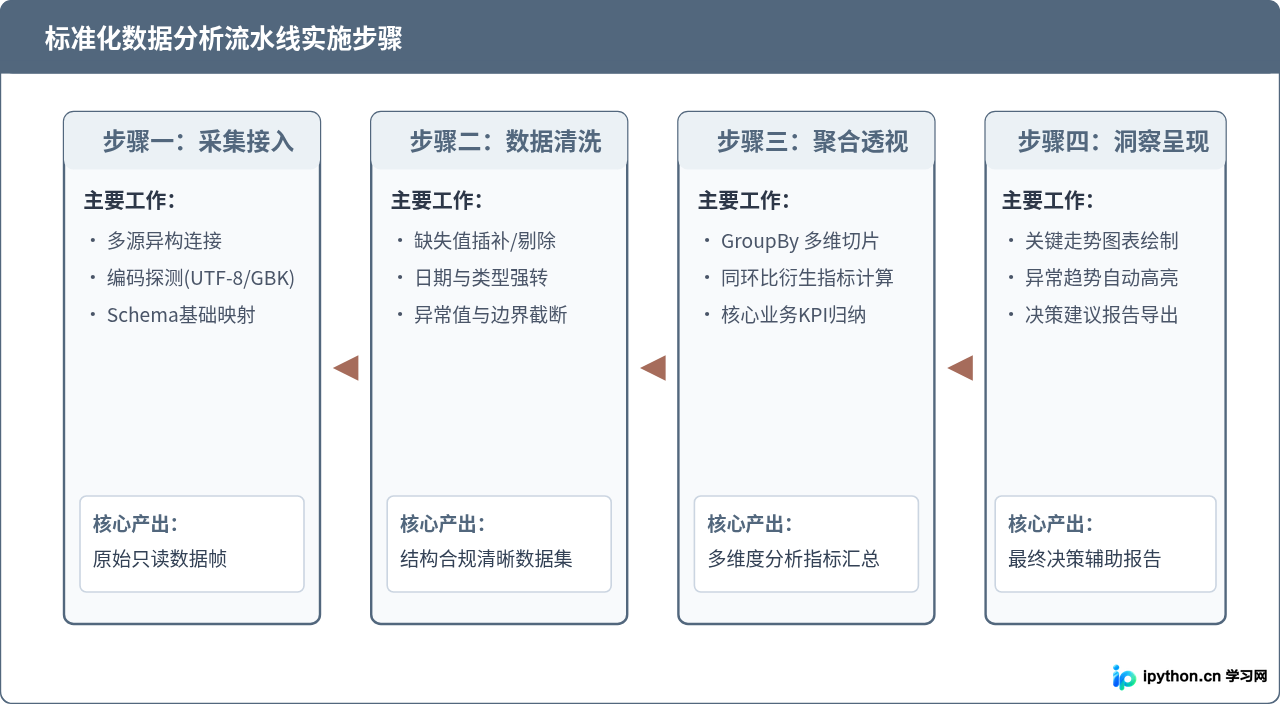
2.1 数据清洗与聚合计算实例
假设我们有一张记录销售流水的数据表,其中存在混合字符串格式的金额、杂乱的时间格式以及空值。以下示例演示如何用链式操作完成标准化清洗与区域汇总:
import pandas as pd
import numpy as np

# 构造模拟原始数据
raw_records = {
    "交易日期": ["2026-03-01", "2026/03/02", "2026-03-02", "2026-03-03", None],
    "销售大区": ["华东", "华北 ", " 华东", "华南", "华北"],
    "交易金额": ["¥1,250.00", "3,400", "¥890.50", "暂无", "2,100.00"],
    "退货标记": [0, 0, 1, 0, 0]
}

df = pd.DataFrame(raw_records)

# 1. 规范日期格式
df["交易日期"] = pd.to_datetime(df["交易日期"], errors="coerce")
# 剔除日期完全缺失的脏数据
df = df.dropna(subset=["交易日期"])

# 2. 清理文本空格
df["销售大区"] = df["销售大区"].astype(str).str.strip()

# 3. 清理金额字段中的符号并转为浮点数值
def parse_currency(val):
    if pd.isna(val):
        return 0.0
    # 移除非数字字符(保留小数点)
    clean_val = str(val).replace("¥", "").replace(",", "").strip()
    try:
        return float(clean_val)
    except ValueError:
        return 0.0

df["有效金额"] = df["交易金额"].apply(parse_currency)

# 4. 剔除已退货记录
valid_sales = df[df["退货标记"] == 0]

# 5. 按大区进行多指标透视统计
summary = valid_sales.groupby("销售大区").agg(
    总成交单数=("交易日期", "count"),
    总销售额=("有效金额", "sum"),
    客单均价=("有效金额", "mean")
).reset_index()

# 格式化均价结果
summary["客单均价"] = summary["客单均价"].round(2)

print("=== 区域销售汇总结果 ===")
print(summary.to_string(index=False))在上面的代码中,errors="coerce" 能够在遇到非法日期格式时不至于使脚本报错中断,而是统一填充为空值(NaT),便于后续阶段统一清理。这种宽容解析配合严格过滤的策略,是保证日常批量处理健壮性的标准范式。
三、方案选型:什么时候该用Python?
理解Python“能做什么”的同时,更要清楚它“什么时候不该用”。盲目把所有表格操作都迁往Python脚本,往往会带来额外的维护成本。一个成熟的自动化实施策略,应当根据任务的执行频次与业务规则的复杂度进行分级。
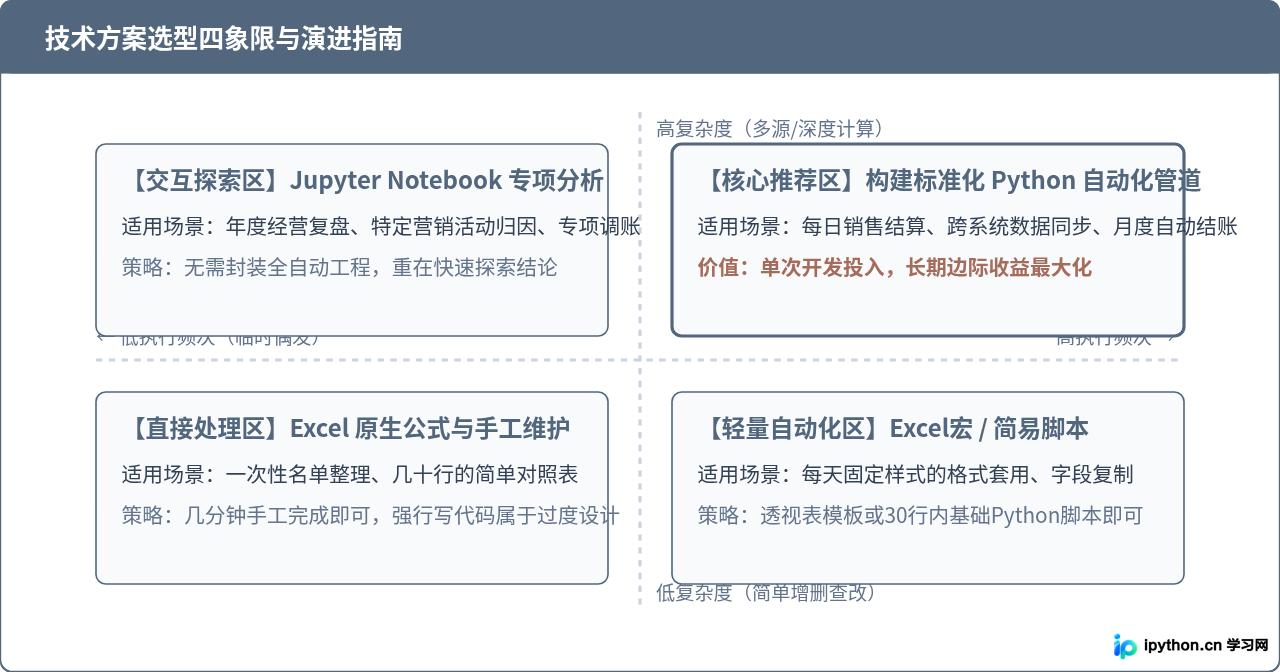
3.1 实际落地的三个核心建议
- 先固化人工规范,再编写自动化脚本:如果上游提供的表格每次列名都在随意变更、日期格式随意填写,单纯用代码写死索引会频繁引发异常。自动化的前提是建立基本的数据契约。
- 做好边界防御与备份隔离:写自动化脚本切忌直接在原文件上进行覆盖保存(In-place Overwrite)。每次执行合并或转换,都应保持源文件只读,将处理产物写入带有时间戳的独立目标文件夹。
- 小步快跑,渐进替代:不必一开始就追求搭建全流程无人工干预的黑盒服务。先从“帮自己节省半小时合并表格”的小函数写起,逐步向“自动核验”、“报表渲染”扩展,能够最快看到业务投入产出比。
四、总结
从本质上看,Python为现代知识工作者提供了一种全新的作业介质:它打破了传统桌面办公软件之间互不连通的信息孤岛,将原本依赖鼠标点击、易受情绪和疲劳影响的手工作业,重构为可复现、可审计、秒级响应的代码流水线。无论是面对数万行杂乱流水的数据清洗,还是日常高频的跨部门文档汇总,掌握这套方法都能切实提高工作效率与数据质量。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















