


Python实现中文与Unicode转义序列的双向转换示例

在网络爬虫数据抓取、跨系统数据交互、日志分析以及解析旧版系统导出的JSON或文本文件时,经常会遇到形如 \u4e2d\u6587 的字符串。这类字符串由反斜杠、字母 u 以及4位十六进制数字组成,被称为 Unicode 转义序列(Unicode Escape Sequence)。本文将通过规范的Python代码示例,讲解中文汉字与Unicode转义序列之间正向转换(编码)与逆向转换(解码还原)的具体实现方案、核心原理与注意事项。
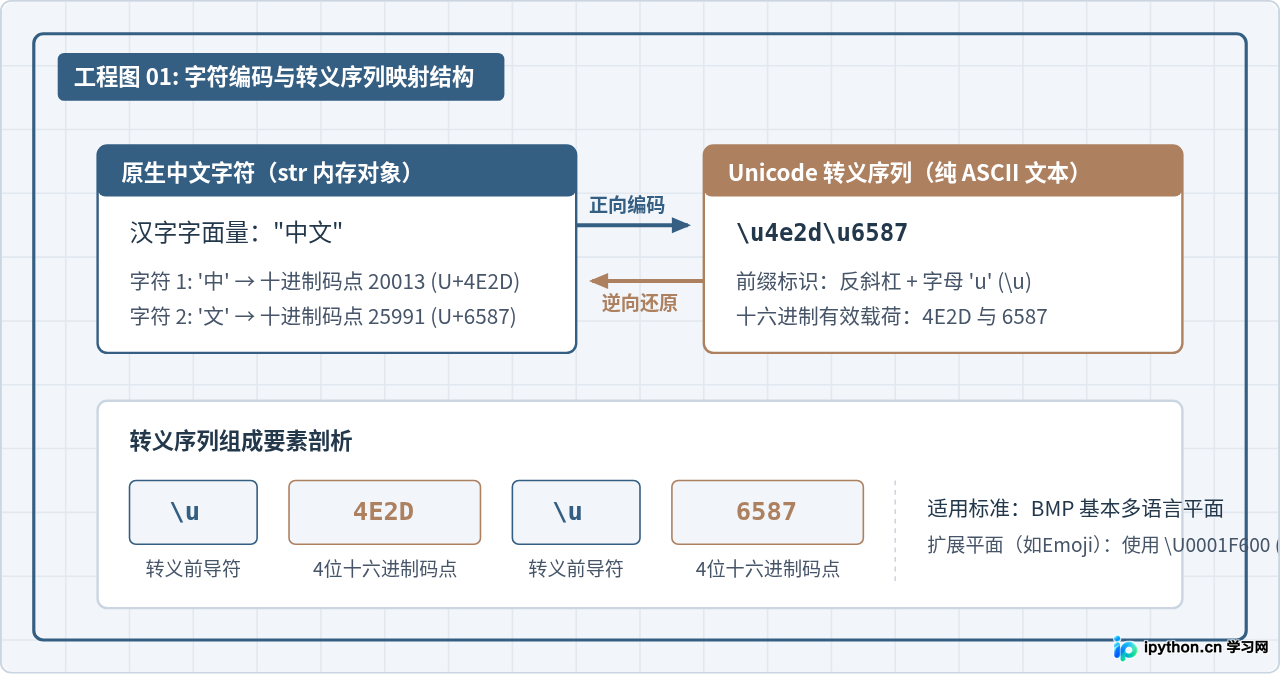
一、核心概念与编码结构解析
Unicode 为世界上每一种语言中的每一个字符都分配了唯一的码点(Code Point),例如汉字“中”的码点为 U+4E2D,“文”的码点为 U+6587。在Python 3中,内存中的普通字符串(str)默认使用 Unicode 编码,每个字符直接对应真实的字形;而当字符以字面文本形式传输且目标环境仅支持纯 ASCII 字符集时,就会使用 \uXXXX 形式进行转义表示。
二、中文转换为 Unicode 转义序列(正向操作)
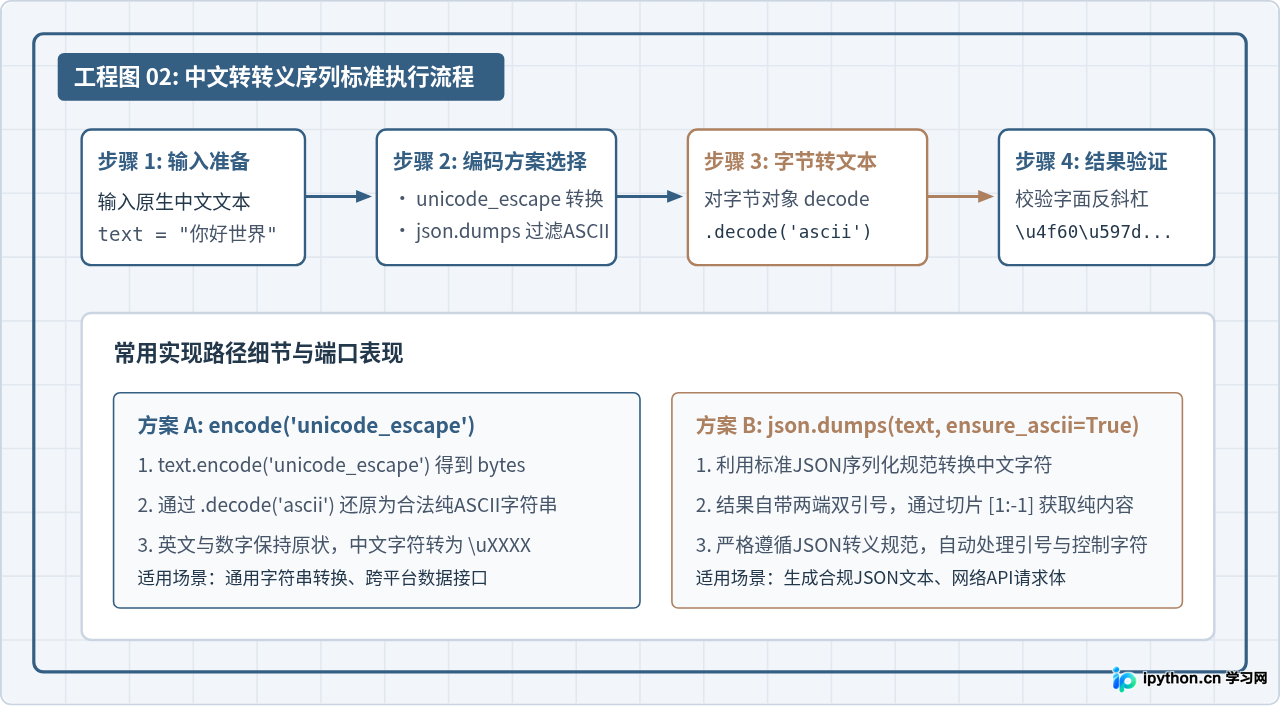
将中文转换为转义序列主要有三种高效途径:利用 Python 字符串内置的 unicode_escape 编解码器、使用标准库 json 模块序列化,或通过遍历字符结合 ord() 手动构建。以下为具体实现步骤与示例代码。
1. 使用内置的 unicode_escape 编解码器
这是最常用且执行效率最高的方法。通过将原字符串进行 unicode_escape 编码得到 bytes,再将其以 ascii 或 utf-8 解码为普通文本:
# 示例 1: 使用 unicode_escape 进行编码
text = "你好,世界!Python编程"

# 第一步:编码为包含转义序列的 bytes
raw_bytes = text.encode('unicode_escape')

# 第二步:将 bytes 还原为纯 ASCII 字符串
escaped_text = raw_bytes.decode('ascii')

print("原始文本:", text)
print("转换结果:", escaped_text)
# 示例输出:
# 原始文本: 你好,世界!Python编程
# 转换结果: \u4f60\u597d\uff0c\u4e16\u754c\uff01Python\u7f16\u7a0b
2. 使用 json.dumps 配合 ensure_ascii=True
json.dumps() 默认参数 ensure_ascii=True 会将所有非 ASCII 字符全部转换为 Unicode 转义序列:
# 示例 2: 使用 json 模块进行转换
import json

text = "数据采集与解析"
# 转换后结果包含首尾双引号,可使用切片截取内容
escaped_with_quotes = json.dumps(text, ensure_ascii=True)
escaped_text = escaped_with_quotes[1:-1]

print("JSON序列化结果:", escaped_with_quotes)
print("去引号结果:", escaped_text)
# 示例输出:
# JSON序列化结果: "\u6570\u636e\u91c7\u96c6\u4e0e\u89e3\u6790"
# 去引号结果: \u6570\u636e\u91c7\u96c6\u4e0e\u89e3\u6790
3. 手动推导与格式化输出
当需要大写的十六进制(如 \u4E2D)或需要对字符范围进行精确过滤时,可以通过 ord() 逐字格式化:
# 示例 3: 自定义字符转换逻辑
def chinese_to_unicode_custom(content: str, uppercase: bool = False) -> str:
    result = []
    fmt = "\\u{:04X}" if uppercase else "\\u{:04x}"
    for char in content:
        if '\u4e00' <= char <= '\u9fff':  # 针对常用汉字范围转义
            result.append(fmt.format(ord(char)))
        else:
            result.append(char)
    return "".join(result)

text = "状态: 成功"
print(chinese_to_unicode_custom(text, uppercase=True))
# 示例输出: 状态: \u6210\u529F
三、Unicode 转义序列还原为中文(逆向操作)
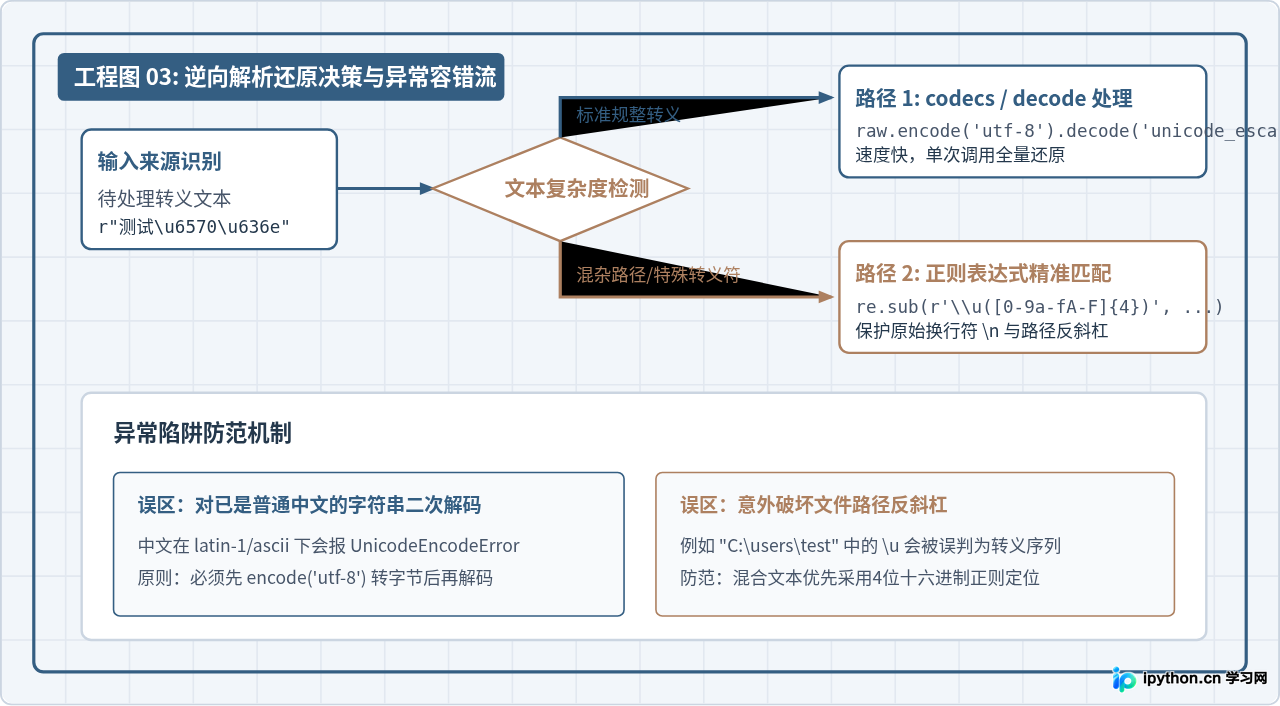
在实际业务中,逆向操作更为常见:从API或日志中读取到了形如 \u4f60\u597d 的字面字符串,需要还原为人类可读的汉字。处理时需注意区分“原生已解析字符”与“字面反斜杠字符串”。
1. 使用 encode('utf-8').decode('unicode_escape')
这是标准且直接的还原方法。对于包含字面转义字符的文本,先编码为 UTF-8 字节序列,再使用 unicode_escape 进行解码还原:
# 示例 4: 使用 encode + decode 还原中文
raw_str = r"\u4f60\u597d\uff0c\u4e16\u754c\uff01"

# 先转为字节流,再通过 unicode_escape 解码
chinese_text = raw_str.encode('utf-8').decode('unicode_escape')

print("原始转义文本:", raw_str)
print("还原后中文:", chinese_text)
# 示例输出:
# 原始转义文本: \u4f60\u597d\uff0c\u4e16\u754c\uff01
# 还原后中文: 你好,世界!
2. 使用 codecs.decode() 模块方法
Python 标准库的 codecs 模块提供了统一的字符串编解码接口,可以直接调用底层解码器:
# 示例 5: 使用 codecs 模块进行解码
import codecs

raw_str = r"\u6b22\u8fce\u4f7f\u7528Python"
chinese_text = codecs.decode(raw_str, 'unicode_escape')

print("还原结果:", chinese_text)
# 示例输出: 欢迎使用Python
3. 使用正则表达式针对性还原(高安全性)
在复杂的工业级数据处理中,一段文本可能同时包含合法的 Unicode 转义序列、换行符(\n)以及Windows路径反斜杠。直接进行全量 unicode_escape 解码会导致非转义反斜杠解析报错或换行符失效。使用正则表达式可以精准锁定4位十六进制格式:
# 示例 6: 使用正则安全还原指定的转义序列
import re

def safe_unicode_unescape(text: str) -> str:
    # 匹配标准的 \u 后面跟随4位十六进制数
    pattern = re.compile(r'\\u([0-9a-fA-F]{4})')

    def replace_match(match):
        hex_val = match.group(1)
        code_point = int(hex_val, 16)
        return chr(code_point)

    return pattern.sub(replace_match, text)

# 测试场景:包含真实换行符和转义序列的复合文本
mixed_text = "路径: C:\\update\\report\n标题: \\u6d4b\\u8bd5\\u62a5\\u544a"
clean_text = safe_unicode_unescape(mixed_text)

print("精准还原结果:")
print(clean_text)
# 示例输出:
# 路径: C:\update\report
# 标题: 测试报告\u4e2 少了一位),全量解码会直接抛出 UnicodeDecodeError。使用基于 re.compile(r'\\u([0-9a-fA-F]{4})') 的正则方案能自动跳过不合规片段,避免程序异常中断。
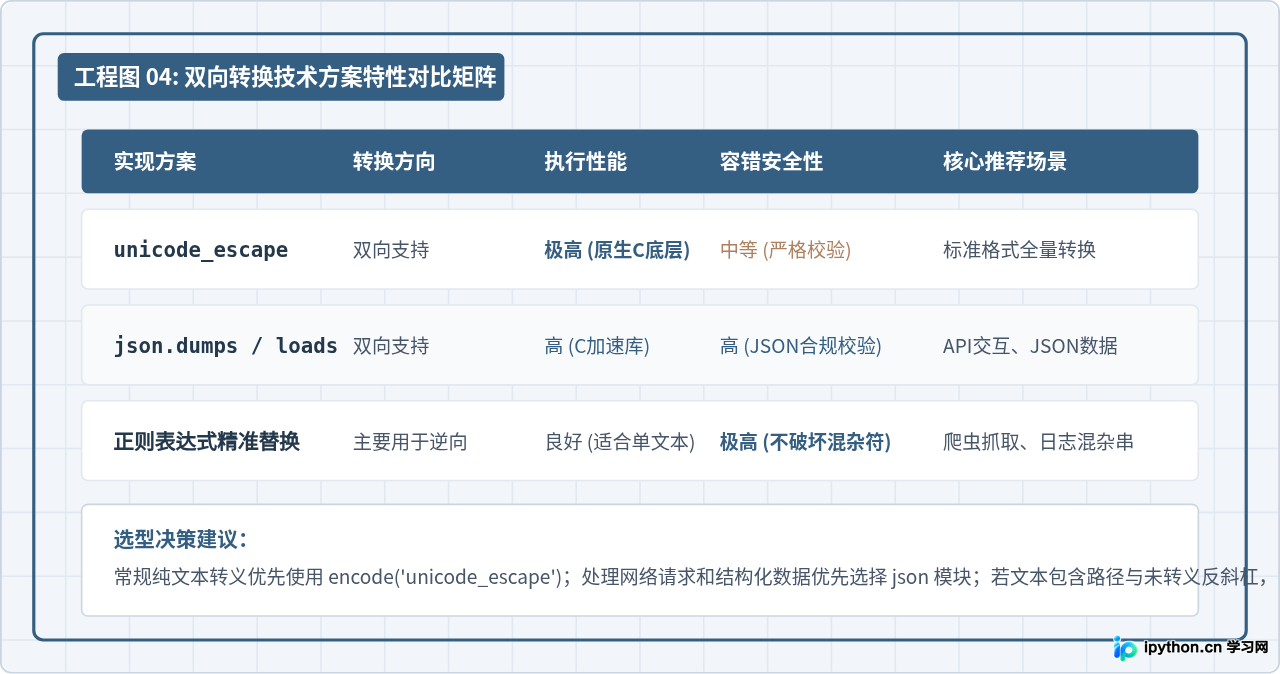
四、方案对比与选型总结
针对不同的开发环境和数据处理需求,各种双向转换方法在处理速度、容错能力和适用场景上各有侧重。以下总结图表与选型对比提供了直观的参考依据:
五、总结
在 Python 中实现中文与 Unicode 转义序列的双向转换非常清晰:
- 正向编码(中文 → \uXXXX):推荐使用
text.encode('unicode_escape').decode('ascii'),或者使用json.dumps(text, ensure_ascii=True)。 - 逆向还原(\uXXXX → 中文):对于纯净的转义串,使用
raw_text.encode('utf-8').decode('unicode_escape')最为便捷;对于混合格式和复杂文本,使用正则捕获re.sub()能够最大程度保证数据的健壮性。
掌握这几种双向转换方案,可以在应对不同数据源格式时保持代码的高效稳定与精确解析。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















