


Python嵌套循环执行逻辑详解:从打印图形到矩阵处理

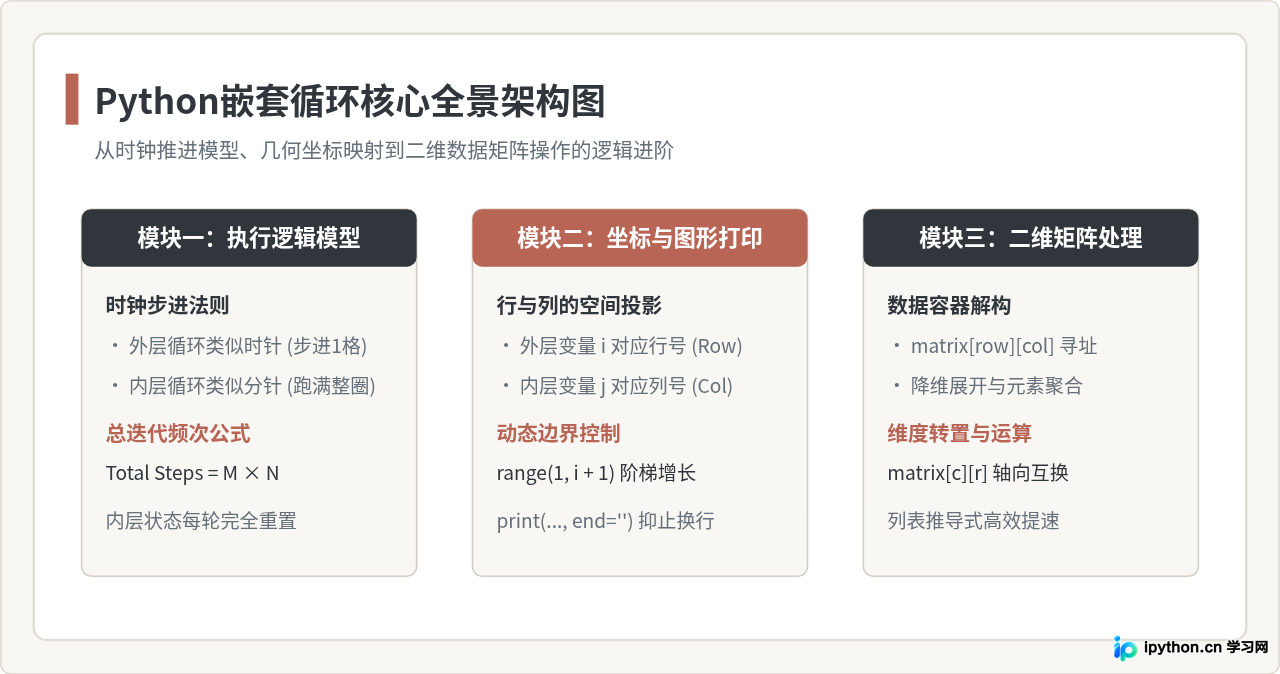
嵌套循环的本质可以用八个字概括:“外层定轮次,内层穷细节”。外层循环每推进单步,内层循环就会完整走完其生命周期。理解嵌套循环的关键,在于建立清晰的步进时序认知,并掌握行、列两个维度在空间与内存中的对应关系。本文将从执行机制剖析入手,通过控制台图形打印的动态边界推导,最终深入二维矩阵的遍历、转换与算法优化。
一、嵌套循环的底层执行机制:时钟步进模型
在 Python 中,当一个 for 或 while 循环位于另一个循环体内部时,便构成了嵌套循环。初学者最容易产生的误解是认为“内外两个循环在同时运行”。在单线程的 Python 解释器中,指令是严格串行执行的。
我们可以将嵌套循环直观地比作“时钟的指针”:
- 外层循环是“时针”:动作缓慢,只有当内层彻底走完一整圈,外层才会向前步进一次。
- 内层循环是“分针”:动作敏捷,在外层保持不动的时间窗口内,独立完成从起点到终点的全部迭代。
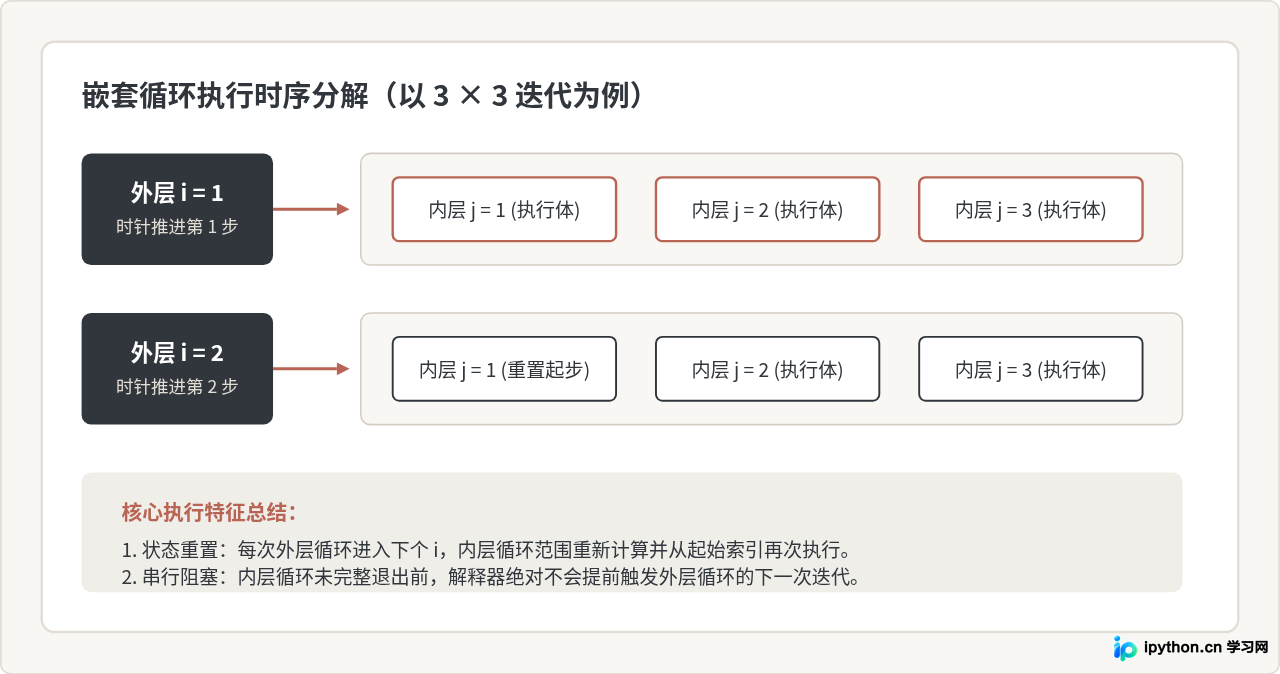
假设外层循环执行 M 次,内层循环执行 N 次,那么内层循环体中的核心代码将被执行 M × N 次。每一次外层循环进入下一轮,内层循环的迭代器都会被重新初始化,变量完全重新经历赋值序列。
# 嵌套循环的基本步进追踪代码
for i in range(1, 4):
    print(f"[外层时针] i = {i} 开始")
    for j in range(1, 4):
        print(f"    [内层分针] i={i}, j={j}")
    print(f"[外层时针] i = {i} 结束\n")
上述代码的执行结果清晰展示了步进的次序:当 i=1 时,j 依次取值 1、2、3;直到 j 迭代结束,外层的第一次循环才告落幕,进入 i=2,此时 j 再次从 1 重新起步。
二、从字符图形打印掌握行列坐标映射
控制台打印字符图形是掌握嵌套循环最经典的切入点。在二维屏幕上,字符输出必须遵循“先由上至下(按行输出),再由左至右(按列填充)”的规则。这一物理规则与嵌套循环的运行特点高度契合:
- 外层循环变量
i控制行(Row):决定当前正在绘制第几行,并在内层结束后负责输出换行符。 - 内层循环变量
j控制列(Column):决定当前行内横向连续打印几个符号,通过设置print(..., end='')阻止默认的自动换行。
1. 动态边界:直角三角形打印
如果每行的符号个数固定,内层循环的 range() 参数就是常数。但当我们需要打印随行数递增的直角三角形时,内层的结束边界就必须动态依赖外层变量 i。
# 打印 5 行直角星号三角形
n = 5
for i in range(1, n + 1):
    # 内层循环根据当前行号 i 决定打印星号的个数
    for j in range(1, i + 1):
        print("* ", end="")
    # 内层一整行打印完毕,外层负责执行换行
    print()
在这一结构中,range(1, i + 1) 是关键。当 i=1 时,内层只执行 1 次;当 i=5 时,内层执行 5 次。内层范围与外层变量绑定,是实现各类几何图案(如菱形、金字塔、倒三角)的基础核心。
2. 经典九九乘法表
九九乘法表进一步结合了数值计算与格式化控制。外层 i 遍历被乘数 1 到 9,内层 j 遍历乘数 1 到 i:
for i in range(1, 10):
    for j in range(1, i + 1):
        # 格式化对齐,防止一位数与两位数错位
        print(f"{j}×{i}={i*j:<2}", end="  ")
    print()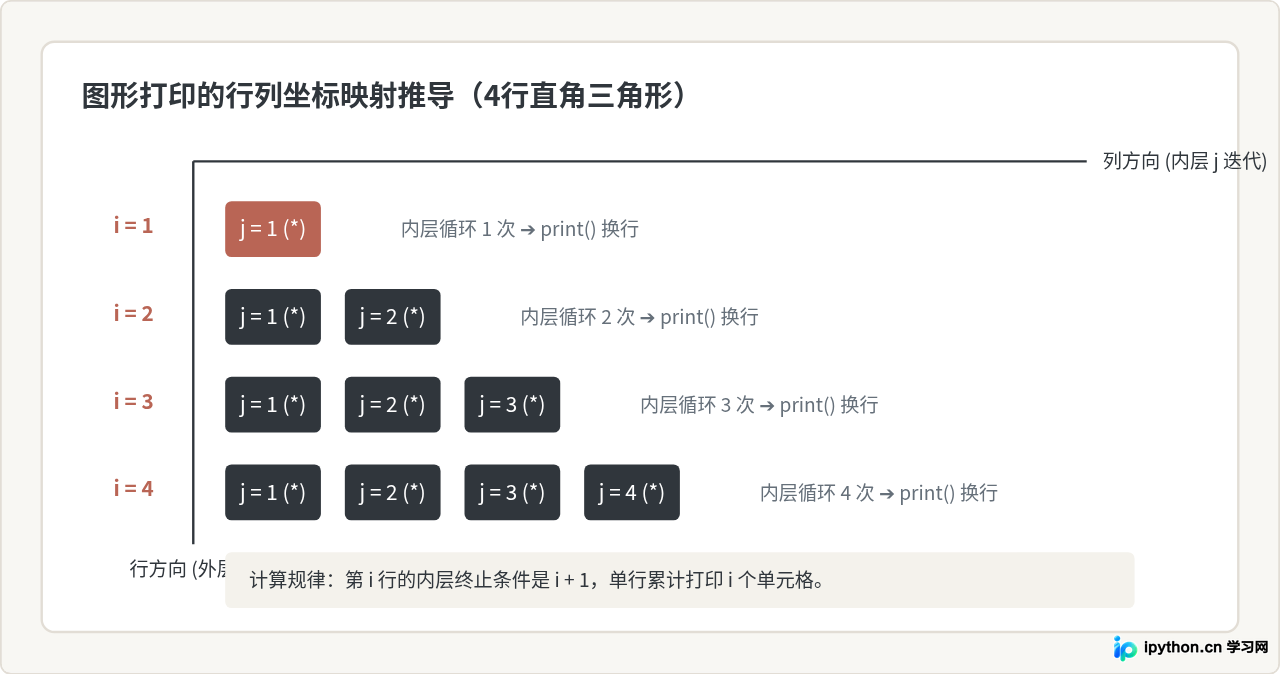
三、核心实战:二维矩阵的遍历、变换与算法处理
当从纯显示过渡到数据处理时,嵌套循环便成为了管理二维数据结构(如图像像素、表格数据、游戏网格)的标配工具。在 Python 中,二维矩阵通常以“嵌套列表”(List of Lists)形式存储。
1. 矩阵的标准索引与逐项访问
访问矩阵中某个元素需要两个下标:matrix[row_idx][col_idx]。外层循环遍历所有子列表(行),内层循环遍历子列表中的具体元素(列)。
# 3行4列的矩阵
matrix = [
    [10, 20, 30, 40],
    [50, 60, 70, 80],
    [90, 100, 110, 120]
]

# 方式一:直接迭代元素(只读需求)
total_sum = 0
for row in matrix:
    for val in row:
        total_sum += val
print("矩阵元素总和:", total_sum)

# 方式二:通过下标遍历(需修改元素或关联坐标)
rows = len(matrix)
cols = len(matrix[0])
for r in range(rows):
    for c in range(cols):
        # 将大于 60 的元素标记或翻倍
        if matrix[r][c] > 60:
            matrix[r][c] *= 2
2. 矩阵转置(Transpose):维度的轴向置换
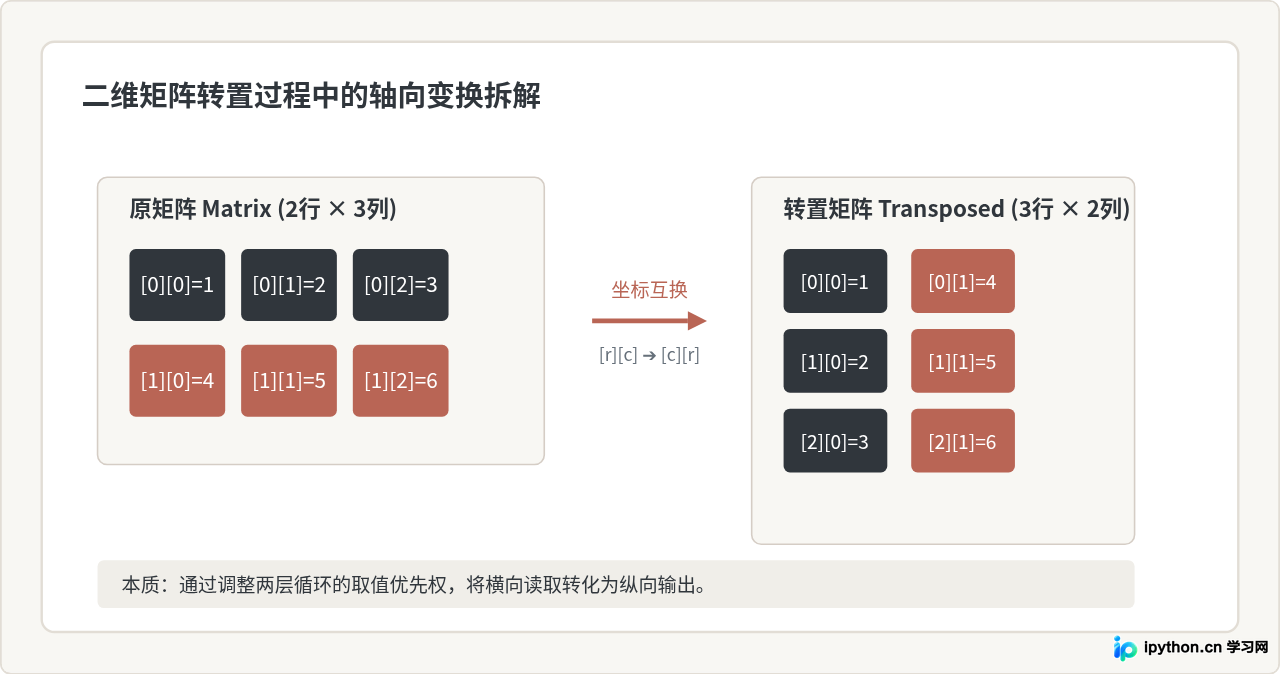
矩阵转置是指将原矩阵的行变成列、列变成行。若原矩阵大小为 M × N,转置后的新矩阵大小为 N × M。转置的数学定义是 transposed[c][r] = matrix[r][c]。
# 手写嵌套循环实现矩阵转置
rows = len(matrix)
cols = len(matrix[0])

# 初始化一个 cols × rows 的空矩阵
transposed = []
for c in range(cols):
    new_row = []
    for r in range(rows):
        new_row.append(matrix[r][c])
    transposed.append(new_row)

print("转置结果:", transposed)
在转置操作中,外层循环控制的是新矩阵的行(即原矩阵的列 c),内层循环控制的是新矩阵的列(即原矩阵的行 r)。这种通过改变循环遍历顺序来重新组织多维数据的思想,是算法设计中的常用手法。
四、控制流边界与常见陷阱:break、continue 与复杂度
在实际使用嵌套循环时,最常见的两个痛点是:控制跳转关键字(break、continue)的作用域混淆,以及由于复杂度激增带来的性能瓶颈。
1. break 与 continue 的单层作用域限制
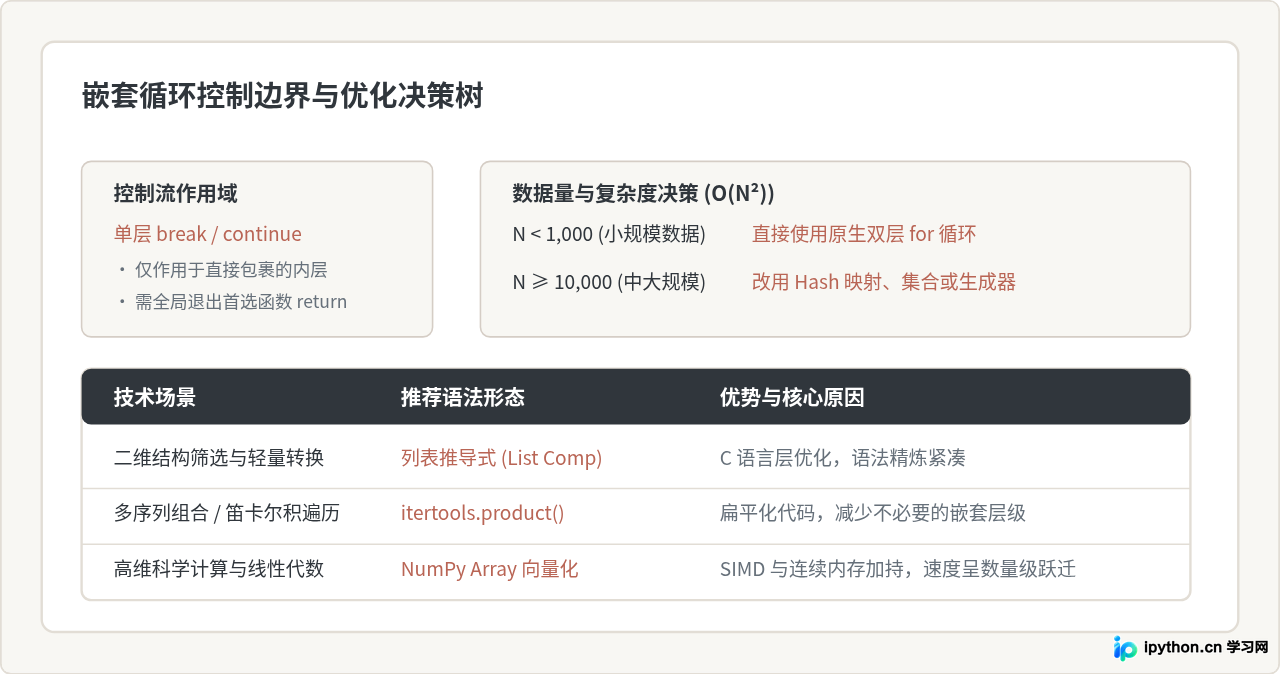
Python 中的 break 和 continue 只对直接包裹它的最内层循环生效,绝不会穿透多层。
- 如果在内层循环执行
break,只有当前的内层循环立即中断;外层循环会继续执行下一轮。 - 如果在内层循环执行
continue,仅跳过当前内层循环当次迭代剩余的代码,直接进入内层的下一次迭代。
若需要在满足某种条件时彻底退出所有嵌套循环,常见的优雅解决方案包括:将嵌套循环封装成独立函数并使用
return 退出;或者在外层判断标志位(flag),亦或利用 for...else 语法结构联动。
# 利用封装函数彻底退出两层循环
def find_target(matrix, target):
    for r_idx, row in enumerate(matrix):
        for c_idx, val in enumerate(row):
            if val == target:
                return (r_idx, c_idx) # 直接跳出全部循环
    return None
2. 时间复杂度陷阱与优化替代方案
两层嵌套循环的时间复杂度通常为 O(M × N);如果是三层嵌套则是 O(N³)。当数据量从千级攀升到万级时,耗时会呈现指数级激增。
- 列表推导式替代:对于简单的矩阵变换,使用
[[row[i] for row in matrix] for i in range(len(matrix[0]))]在语法层面更紧凑,底层字节码执行速度也快于多次append()。 - 内置工具库(itertools):若需要求两个序列的笛卡尔积,使用
itertools.product(A, B)比编写显式双层循环更清晰,且避免了多层缩进。 - 数值计算使用 NumPy:在纯数值矩阵运算中,Python 原生嵌套循环耗时巨大,使用 NumPy 的向量化运算(如
matrix.T转置、矩阵点乘)可将性能提升数十至上百倍。
五、总结
掌握 Python 嵌套循环并非单纯记住语法格式,而是要深刻理解其串行步进的时间维度与行列映射的空间维度:
- 时钟指针思维:牢记“外层一次、内层整套”,内层循环的终止与重置是驱动逻辑推进的齿轮。
- 坐标绑定规律:在图形打印和矩阵访问中,始终将外层变量与“行号/纵向坐标”绑定,内层变量与“列号/横向坐标”绑定。
- 警惕复杂度陷阱:在遇到大规模数据或复杂控制流时,善用函数
return退出全局,并及时评估是否需转向列表推导式、itertools或 NumPy 向量化计算。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















