


怎么在Python遍历列表时安全删除元素而不跳过数据

data[:] = [x for x in data if ...]),既能保持原有引用又具备高执行效率;若必须在原列表上原地操作且内存受限,应使用反向索引遍历(for i in range(len(data)-1, -1, -1): del data[i]),利用高位索引变动不影响低位未访问元素的特性彻底避免数据漏删。
一、问题复现与跳过数据的底层机制
很多初学者在编写代码时,习惯直接写出类似下面的循环逻辑:
# 错误示例:直接正向遍历并删除偶数
numbers = [1, 2, 2, 3, 4]
for item in numbers:
    if item % 2 == 0:
        numbers.remove(item)

print(numbers)  # 输出结果为 [1, 2, 3]
观察上述结果可以发现,列表原本包含两个连续的数字 2,但删除后依然残留了一个 2。不仅是 remove() 方法,若使用 for i in range(len(numbers)): del numbers[i] 还会直接抛出 IndexError 索引越界异常。
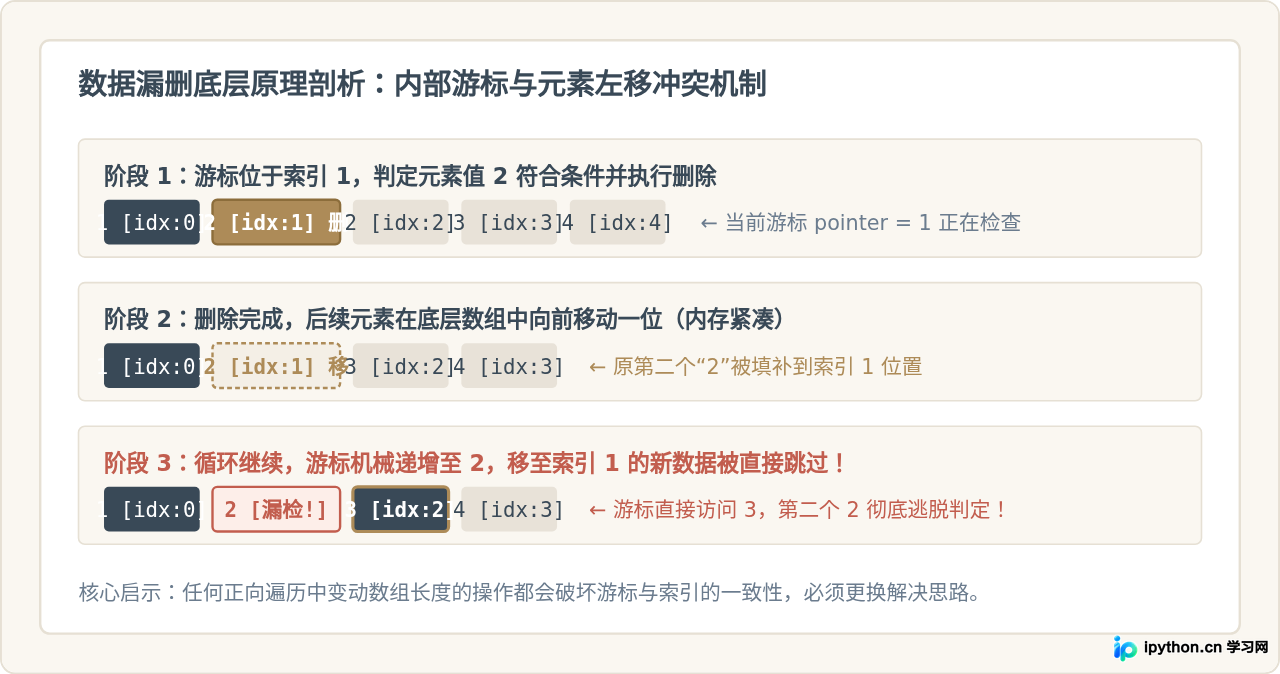
造成这种数据漏删现象的根本原因在于 Python 迭代器的内部游标机制与列表底层存储结构之间的错位:
- 游标单向递增:Python 的
for...in循环本质上通过内置迭代器按递增索引(0, 1, 2, 3...)依次访问列表元素。 - 底层数组连续与左移:Python 列表是基于连续内存动态数组实现的。当位于索引
i的元素被删除后,位于i+1及之后的所有元素在内存中会立即整体向左移动一位,原来的第i+1个元素移到了索引i的位置。 - 游标跳过位移数据:在下一次循环迭代时,内部游标机械地前进到索引
i+1,直接略过了刚刚左移填补至索引i的新元素,导致紧邻的元素根本没有机会参与条件判定。
二、方案一:列表推导式与切片原地重赋值(推荐首选)
在 Python 哲学中,“保留不需要删除的元素”远比“在原列表里挨个删除”更加清晰高效。列表推导式是官方和社区最推荐的标准做法。
1. 基础用法:生成新的列表对象
# 做法 A:列表推导式生成全新列表
numbers = [1, 2, 2, 3, 4]
# 仅保留不满足删除条件的元素(即保留奇数)
filtered_numbers = [x for x in numbers if x % 2 != 0]

print(filtered_numbers)  # 输出 [1, 3]
2. 保持对象引用不变:切片原地重赋值
在很多实际工程项目中,列表对象可能已被传递给多个模块、类实例或函数形参。如果直接用 numbers = [x for x in numbers if ...],实际上是将变量名绑定到了一个全新的列表对象,其他引用该列表的地方无法感知变化。此时只需使用切片赋值语法 numbers[:]:
# 做法 B:切片赋值保留原列表内存引用
def clean_cache(data_list):
    # 使用切片覆盖原有内存块,不创建新对象引用
    data_list[:] = [x for x in data_list if x % 2 != 0]

my_data = [1, 2, 2, 3, 4]
original_id = id(my_data)

clean_cache(my_data)
print(my_data)           # 输出 [1, 3]
print(id(my_data) == original_id) # 输出 True,内存地址未改变O(N),底层通过 C 语言级别的内存批量拷贝实现,比在 Python 循环中频繁调用 remove()(时间复杂度高达 O(N²))快上数十倍甚至数百倍。
三、方案二:反向索引遍历(原地修改的高效解法)
如果业务受限于极度严苛的内存环境,无法容纳列表推导式创建的临时辅助列表,或者必须在单次循环中伴随复杂的上下文副作用处理,反向索引遍历是真正绝对安全的就地删除方案。
# 反向遍历删除元素
numbers = [1, 2, 2, 3, 4]

# 从最后一个索引递减遍历到 0
for i in range(len(numbers) - 1, -1, -1):
    if numbers[i] % 2 == 0:
        del numbers[i]

print(numbers)  # 严格输出 [1, 3]
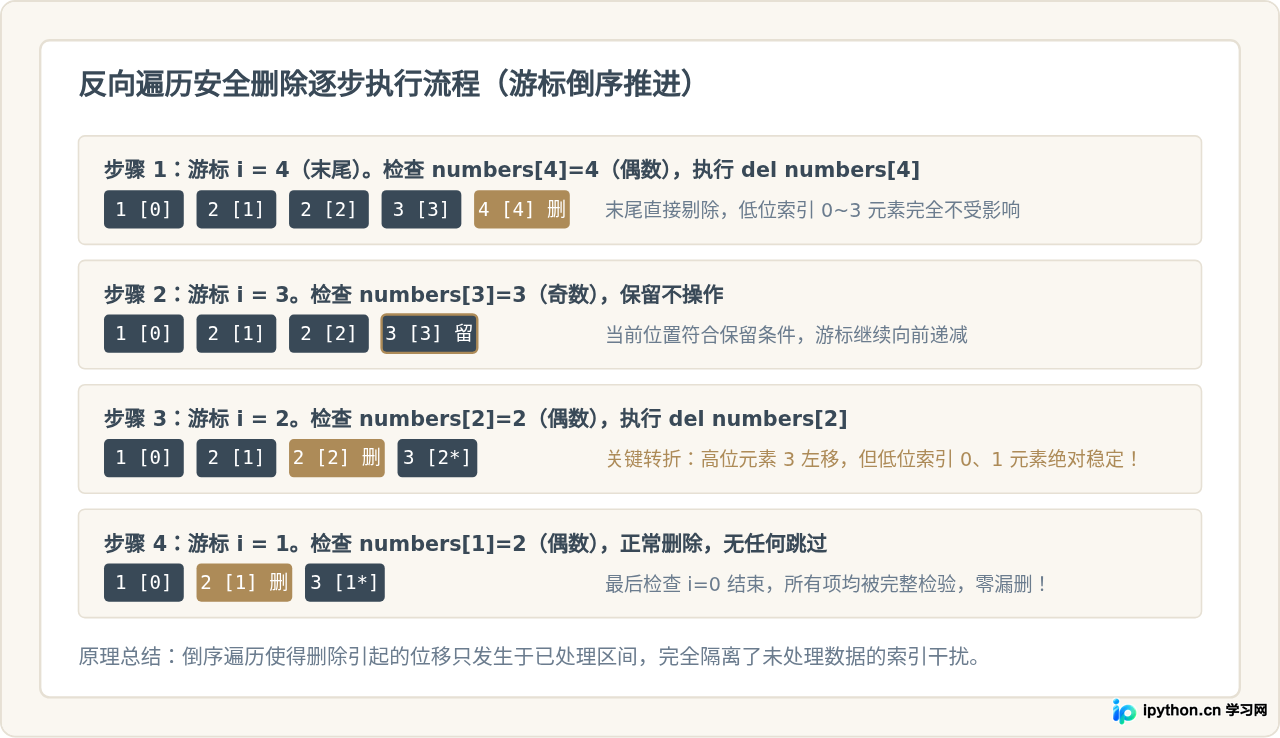
为什么反向遍历不会漏删数据?其几何原理十分直观:
- 当游标从尾部向前(如从索引 4 向 0)移动时,如果我们在高位索引
i执行del numbers[i],受影响发生左移的元素全部在索引i之后。 - 而索引
i之后的元素已经在之前的迭代中被访问并检查完毕; - 位于索引
i-1、i-2等尚未访问的低位元素,其在内存中的相对位置与绝对索引完全保持不变。 - 因此,下一次循环游标递减到
i-1时,指向的正是原本应该被检查的元素,绝对不会发生任何数据跳过。
四、方案三:浅拷贝迭代与 while 显式游标控制
除了推导式和倒序遍历,还有另外两种在特定场景下可行的方案。
1. 遍历列表的浅拷贝(副本)
如果我们遍历的是原列表的一份独立浅拷贝,而在循环体内操作原列表,那么迭代器的游标只在副本上移动,原列表长度变化完全不影响副本的迭代序列:
# 遍历浅拷贝
numbers = [1, 2, 2, 3, 4]

# numbers[:] 或 numbers.copy() 生成浅拷贝
for item in numbers[:]:
    if item % 2 == 0:
        numbers.remove(item)

print(numbers) # 输出 [1, 3]numbers.remove(item) 每次被调用时都需要在原列表中从头扫描该元素(时间复杂度 O(N))。当列表中包含大量重复元素或列表长度较大时,整体时间复杂度为 O(N²),性能消耗明显大于切片推导式。
2. while 循环配合条件游标递增
如果使用 while 循环,我们可以手动掌控索引的递增时机:只有当当前元素不需要删除时,游标才前进;发生删除时,游标保持不动,等待下一轮继续检查左移过来的新元素。
# 显式游标控制
numbers = [1, 2, 2, 3, 4]
i = 0

while i < len(numbers):
    if numbers[i] % 2 == 0:
        del numbers[i]  # 删除后当前位置被后序元素填补,i 不递增
    else:
        i += 1          # 只有保留当前元素时,游标才前进

print(numbers)  # 输出 [1, 3]
五、各方案综合特性与性能对比
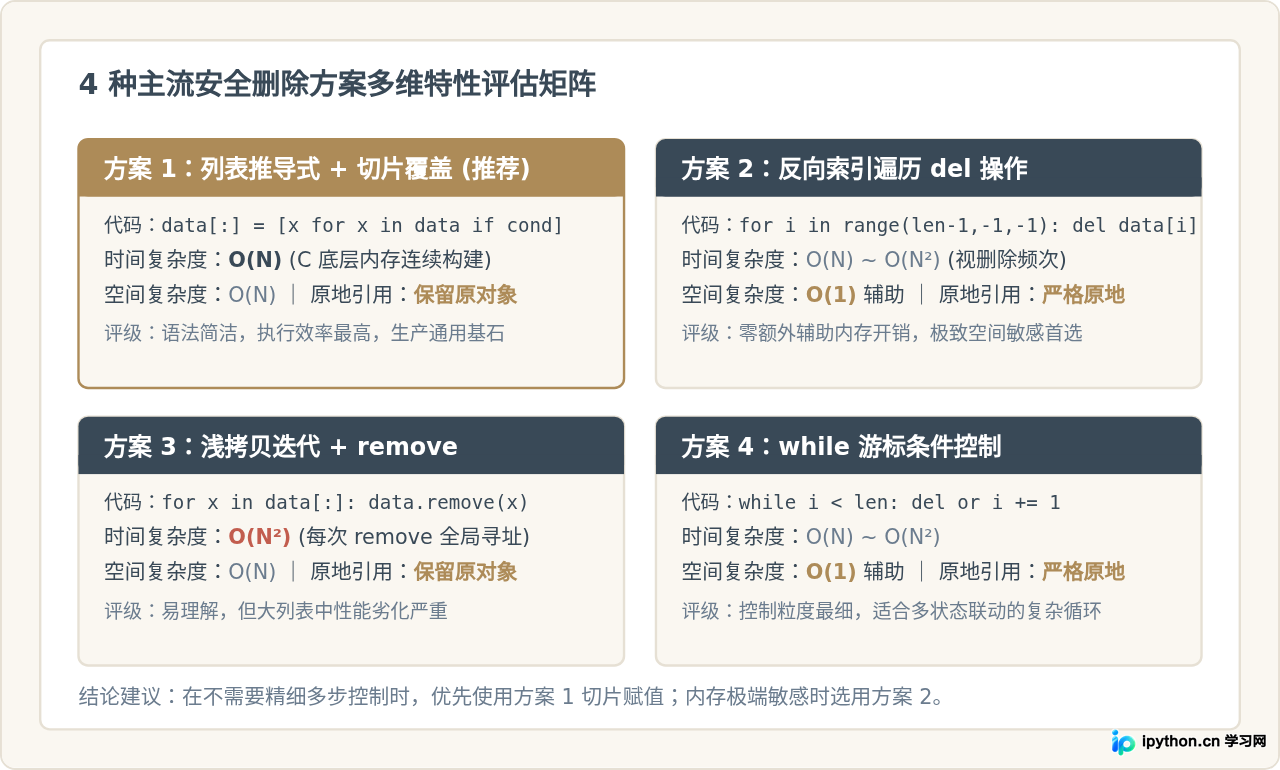
为了帮助大家在实际工程开发中根据具体条件做出合理选型,下表从时间复杂度、空间消耗、是否原地保留引用以及代码可读性四个维度对常见方案进行综合对比:
| 解决方案 | 时间复杂度 | 额外空间 | 保持原内存引用 | 适用典型场景 |
|---|---|---|---|---|
列表推导式切片赋值data[:] = [x for x ...] |
O(N) | O(N) | 是 | 绝大多数工程开发、代码规范的首选方案 |
新列表推导式data = [x for x ...] |
O(N) | O(N) | 否(重绑定) | 无需保留原对象引用、纯函数数据转换 |
反向索引遍历range(len-1, -1, -1) |
O(N²) 最坏 | O(1) | 是 | 内存受限、超大列表无法承担辅助内存时 |
遍历切片副本 + removefor x in data[:]: remove |
O(N²) | O(N) | 是 | 元素数量少(百级以内)、脚本临时编写 |
while 显式游标控制while i < len(data) |
O(N²) 最坏 | O(1) | 是 | 删除逻辑涉及多步前瞻判定、状态机联动 |
六、工程实践中的选型路径与避坑总结
面对具体业务开发时,如何快速决定采取哪一种方案?可以通过以下决策逻辑快速定位最佳实践:
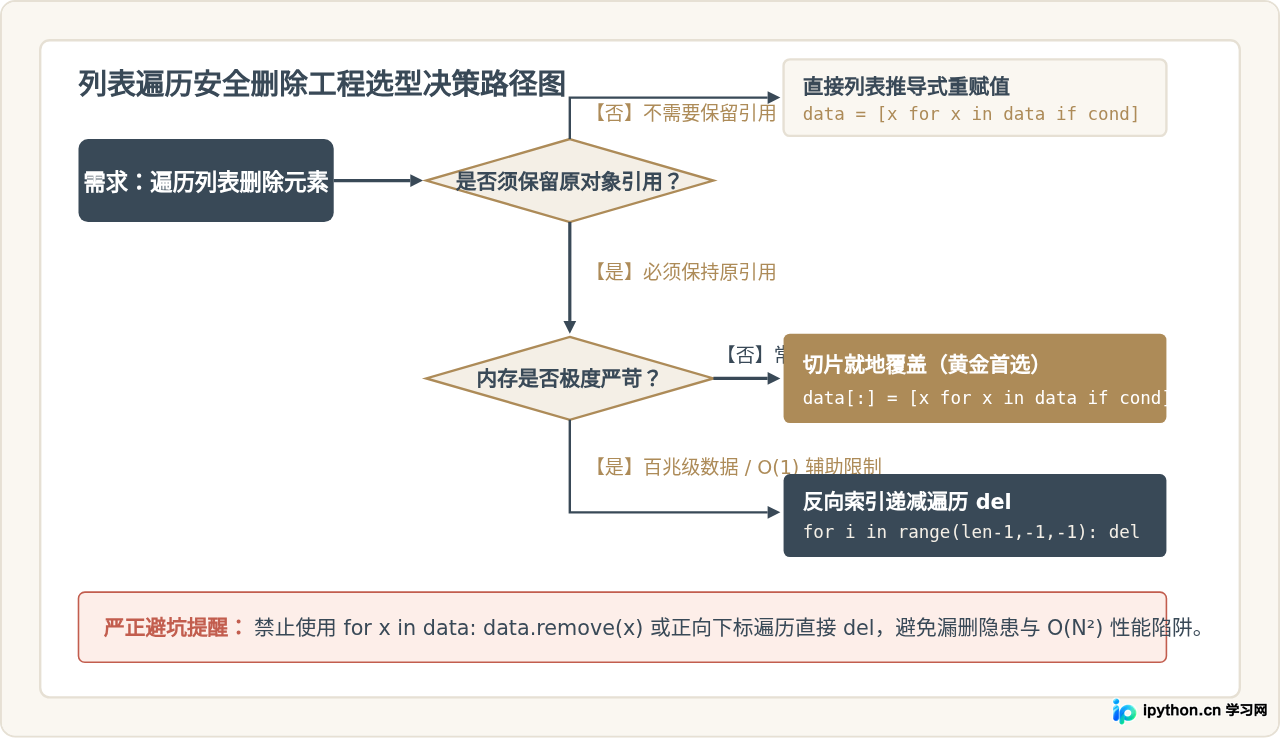
综上所述,在 Python 开发中处理“遍历时删除列表元素”的需求,记住两条金科玉律即可:
- 绝大多数日常业务:直接使用切片推导式
data[:] = [x for x in data if not should_delete(x)],兼顾语法优雅、引用一致性与最佳运行速度; - 高内存敏感或复杂原地操作:使用
for i in range(len(data)-1, -1, -1): del data[i],从物理结构上消除游标跳过的可能性。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















