


Python Web框架性能优化:从代码到部署的最佳实践

涵盖压测剖析、异步与序列化加速、数据库ORM与连接池治理、WSGI/ASGI Worker配比及Nginx网关调优全流程
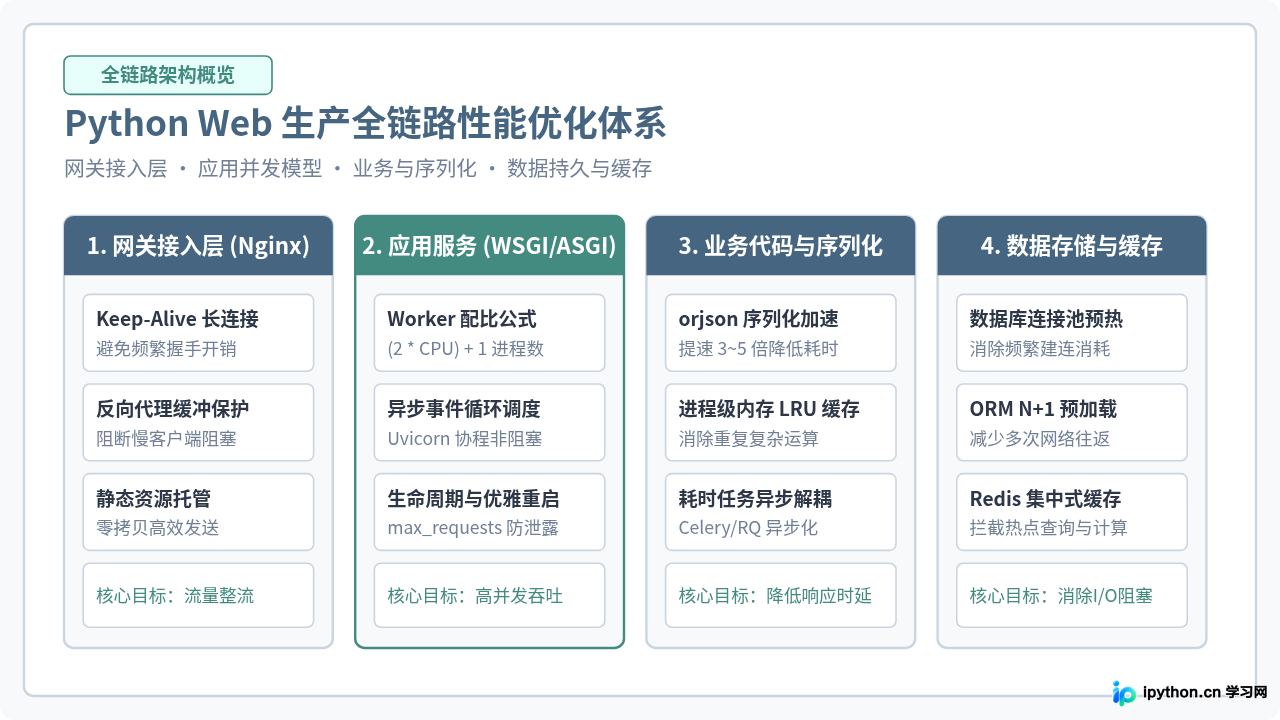
一、基准压测与性能剖析:定位瓶颈而非盲目猜测
很多开发者在面临性能瓶颈时,容易陷入局部细节的盲目微调,比如纠结某个循环语句的编写方式,而忽略了应用中高达 80% 的耗时实际上来自于慢 SQL 或外部 HTTP 阻塞。性能优化的第一准则,是使用标准化工具测得精准的量化指标。
1. 基准压测工具选型与指标
建议使用 wrk 进行轻量级高并发压测,或使用 Locust 模拟包含复杂鉴权与业务流的场景。压测应重点关注以下核心指标:
- RPS(Requests Per Second):系统每秒处理的请求峰值,直接反映吞吐能力。
- P95 与 P99 延迟:95% 与 99% 请求的响应时间上限,长尾延迟最能暴露偶发性 I/O 阻塞或连接池耗尽问题。
- 错误率:高并发下是否出现 502 Bad Gateway 或 504 Gateway Timeout。
# 使用 wrk 发起持续 30 秒、4 线程、100 并发连接的基准压测
wrk -t4 -c100 -d30s --latency http://127.0.0.1:8000/api/v1/items
2. 使用 py-spy 无侵入生成火焰图
py-spy 是一款基于 Rust 开发的 Python 采样分析器。它无需修改任何代码,也无需重启正在运行的生产进程,即可对目标 Python 进程进行低开销采样并生成清晰的 SVG 火焰图。
# 针对正在运行的 Gunicorn / Uvicorn 进程 (PID: 12345) 采样 30 秒并导出火焰图
py-spy record -o profile.svg --pid 12345 --duration 30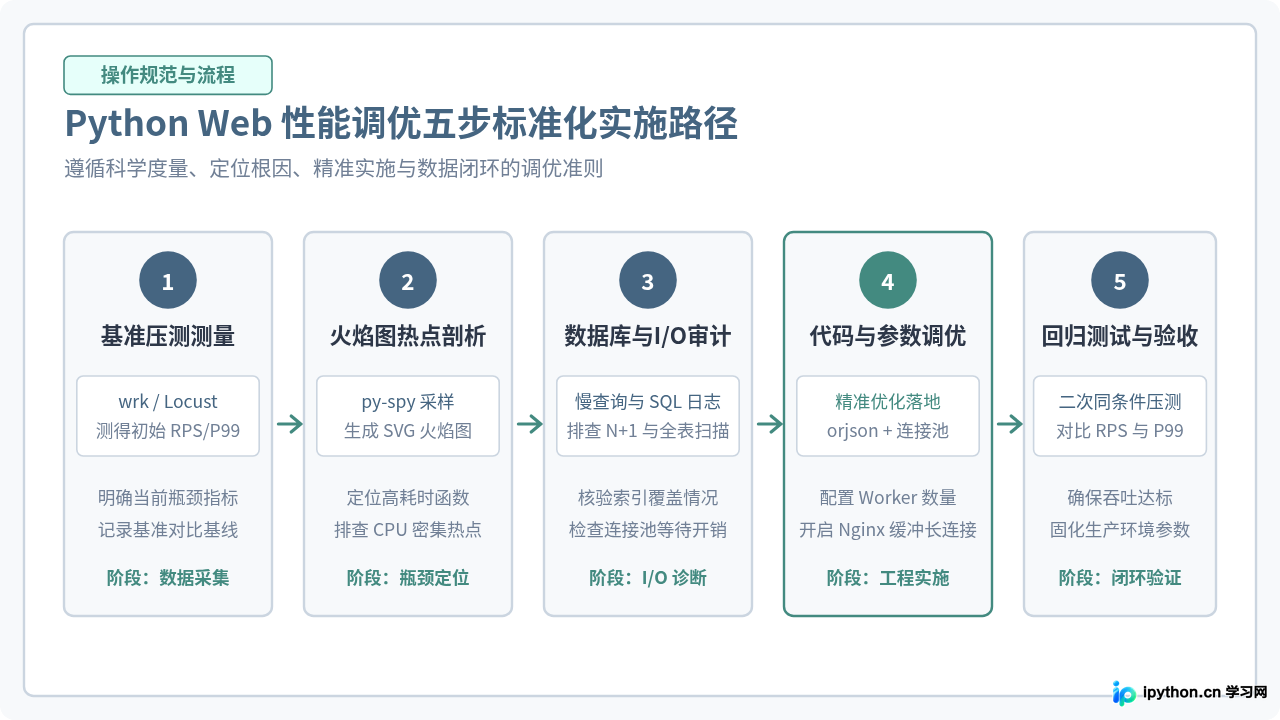
二、代码与业务层优化:消除计算热点与序列化开销
在 Python Web 开发中,代码层优化主要集中在数据序列化加速、框架异步并发能力匹配以及本地高频计算缓存三个方向。
1. 替换标准库 JSON:改用 orjson 加速数据吞吐
现代 Web 接口普遍以 JSON 作为核心数据交换格式。Python 内置的 json 模块完全由纯 Python 实现,在序列化嵌套字典或大体积列表时开销显著。基于 Rust 编写的高性能库 orjson 能够带来 3 到 5 倍的吞吐量提升,原生支持 datetime、UUID 与 dataclass 类型的极速序列化。
# 在 FastAPI 或 Starlette 中配置自定义的高性能 ORJSONResponse
from fastapi import FastAPI
from fastapi.responses import ORJSONResponse

app = FastAPI(default_response_class=ORJSONResponse)

@app.get("/api/v1/records", response_class=ORJSONResponse)
async def get_records():
    # 模拟复杂嵌套数据,orjson 原生以 C/Rust 级别直接序列化为二进制字节流
    return {"status": "success", "data": [{"id": i, "score": i * 1.5} for i in range(1000)]}
2. 利用 functools.lru_cache 消除重复计算
对于权限校验模板解析、固定枚举配置加载等计算密集型或高频只读逻辑,应善用进程内缓存。使用 functools.lru_cache 避免在每次 HTTP 请求中重复执行高开销解析。
import functools
import time

@functools.lru_cache(maxsize=1024)
def resolve_permission_tree(role_id: int):
    # 耗时计算逻辑通过内存缓存,后续请求可在 0.01ms 内直接返回
    return {"role": role_id, "cached_at": time.time()}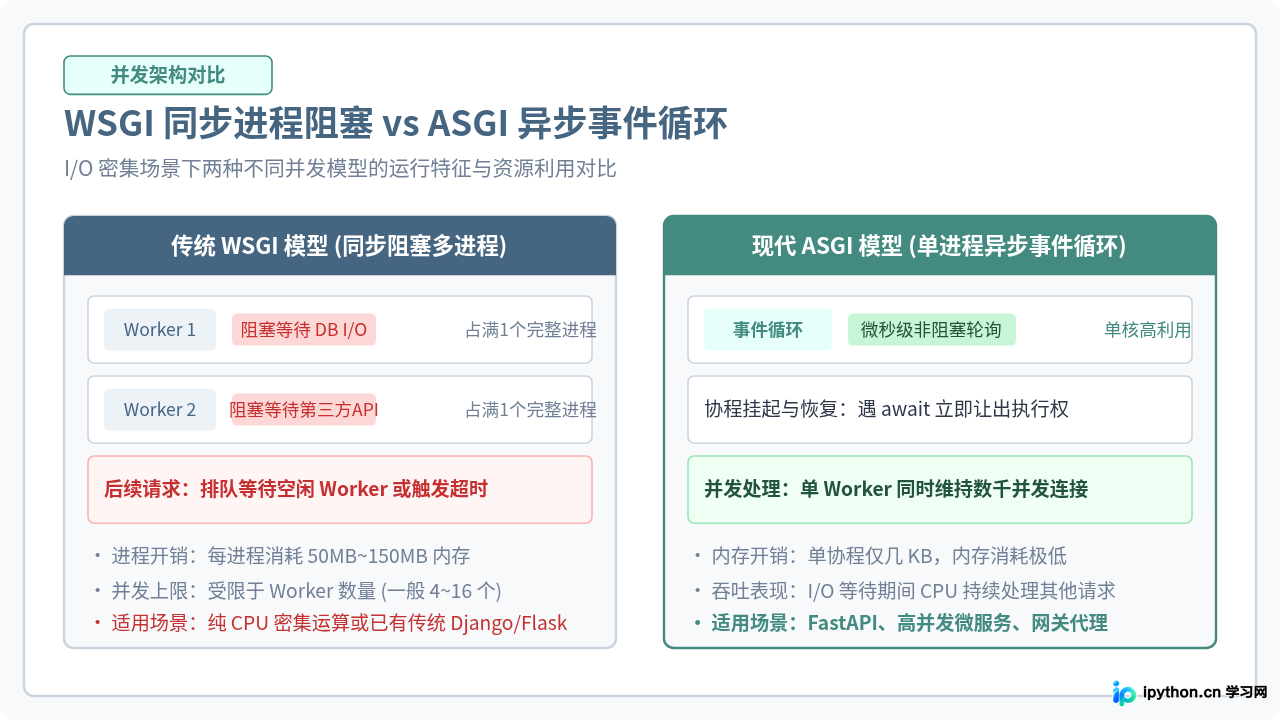
三、数据与 I/O 治理:消除最严重的延迟源
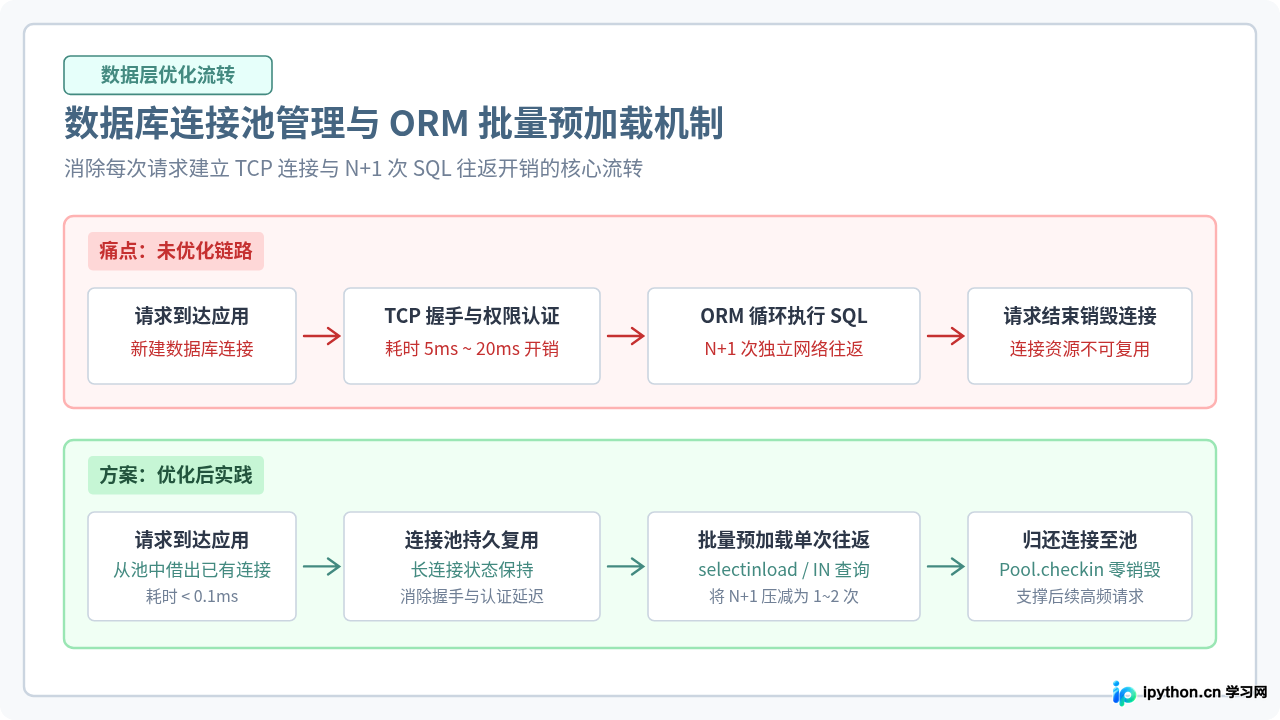
超过 70% 的 Python Web 延迟问题根源在于数据库交互。未经优化的 ORM 查询会导致大量的网络往返与连接建立开销。
1. 治理 ORM 懒加载与 N+1 查询
ORM 懒加载在关联对象被访问时触发独立查询,导致一次列表查询引发 N 次额外网络往返。在 SQLAlchemy 或 Django 中,必须显式使用批量预加载机制:
# 错误示例:引发 N+1 查询,循环内反复发起 SQL
users = session.query(User).all()
for u in users:
    print(u.orders)  # 每次循环均发起一次独立的 SELECT * FROM orders 语句

# 最佳实践:使用 selectinload 单次完成关联对象批量载入
from sqlalchemy.orm import selectinload

stmt = select(User).options(selectinload(User.orders))
users = (await session.execute(stmt)).scalars().all()
2. 科学配置数据库连接池
每次 HTTP 请求新建 TCP 数据库连接伴随着严苛的握手与认证开销(通常需要 5ms~20ms)。生产环境必须启用持久化连接池:
pool_size:长期维护的基础连接数。经验公式为:pool_size = (核心数 * 2) + 磁盘数,一般设置为 10~20 即可。max_overflow:流量激增时允许临时扩容的最大连接数,建议设为 10。pool_recycle:连接最大复用秒数(如 1800 秒),防止底层 MySQL/PostgreSQL 闲置超时强制切断连接导致服务端报错。
四、应用服务器生产调优:WSGI 与 ASGI Worker 体系
Python 应用本身是代码逻辑载体,其实际并发承载力取决于应用服务器的部署架构与进程管理策略。
1. Gunicorn / Uvicorn Worker 数量精准计算
传统的 Gunicorn 官方推荐公式为:workers = (2 * CPU_CORES) + 1。该公式背后的原理是:当某一个 Worker 因为磁盘 I/O 或数据库读取发生上下文切换时,操作系统的调度器可以无缝将 CPU 分配给其余待命的 Worker,保持核心满载。
multiprocessing.cpu_count(),该函数会返回宿主机的物理核数而非容器配额。必须读取 /sys/fs/cgroup/cpu/cpu.cfs_quota_us 限制,或者显式在启动脚本中传参。
2. 防止内存泄漏的生命周期配置
由于部分 C 扩展库或复杂引用的闭包缓存问题,Python 进程在长期运行下可能存在微量内存累积。配置 max_requests 与抖动参数可让 Worker 在完成指定请求后平滑重启:
# gunicorn.conf.py 生产配置示例
import multiprocessing

bind = "0.0.0.0:8000"
workers = 5  # 假设分配 2 核 CPU: (2 * 2) + 1
worker_class = "uvicorn.workers.UvicornWorker"

# 优雅重启参数:单个 worker 累计处理 1000 次请求后自动重启并回收内存
max_requests = 1000
max_requests_jitter = 100  # 添加随机扰动,防止所有 worker 同时重启引发雪崩

keepalive = 65  # 必须略大于前端 Nginx 的超时配置
timeout = 30
五、网关接入与系统级部署最佳实践
绝不应该让 Python 应用服务器直接暴露在公网面对海量客户端。前端部署专业的反向代理(如 Nginx)是保证系统高可用与低延迟的护城河。
1. Nginx 反向代理缓冲与长连接复用
如果客户端处于弱网环境,慢速的数据接收会长期霸占 Python Worker 进程。开启 Nginx 的 proxy_buffering 可以让 Nginx 先将 Python 生成的响应完整缓存到内存中,立即释放后端 Python Worker,再由 Nginx 的 epoll 异步管道慢速下发给客户端。
# nginx.conf 关键调优配置片段
upstream python_backend {
    server 127.0.0.1:8000;
    keepalive 32;  # 保持与后端应用服务器的 32 个长连接池
}

server {
    listen 80;
    server_name example.com;

    location / {
        proxy_pass http://python_backend;
        proxy_http_version 1.1;
        proxy_set_header Connection "";  # 清除 Connection 头,激活 upstream keepalive

        proxy_buffering on;
        proxy_buffer_size 8k;
        proxy_buffers 8 64k;
        proxy_busy_buffers_size 128k;

        proxy_set_header Host $host;
        proxy_set_header X-Real-IP $remote_addr;
        proxy_set_header X-Forwarded-For $proxy_add_x_forwarded_for;
    }

    # 静态资源直接由 Nginx 零拷贝分流,不经过 Python 进程
    location /static/ {
        alias /var/www/static/;
        expires 30d;
        add_header Cache-Control "public, no-transform";
    }
}
2. Linux 内核连接队列参数优化
在高并发瞬时洪峰下,操作系统层面的握手队列过短可能直接导致丢包。需要在宿主机或容器层面调整 sysctl 参数:
net.core.somaxconn = 4096:增大监听队列最大长度,避免连接溢出。net.ipv4.tcp_max_syn_backlog = 8192:增大 SYN 队列容纳量。fs.file-max = 65535:提高进程可打开的文件描述符上限。
六、生产全链路调优总结与排查清单
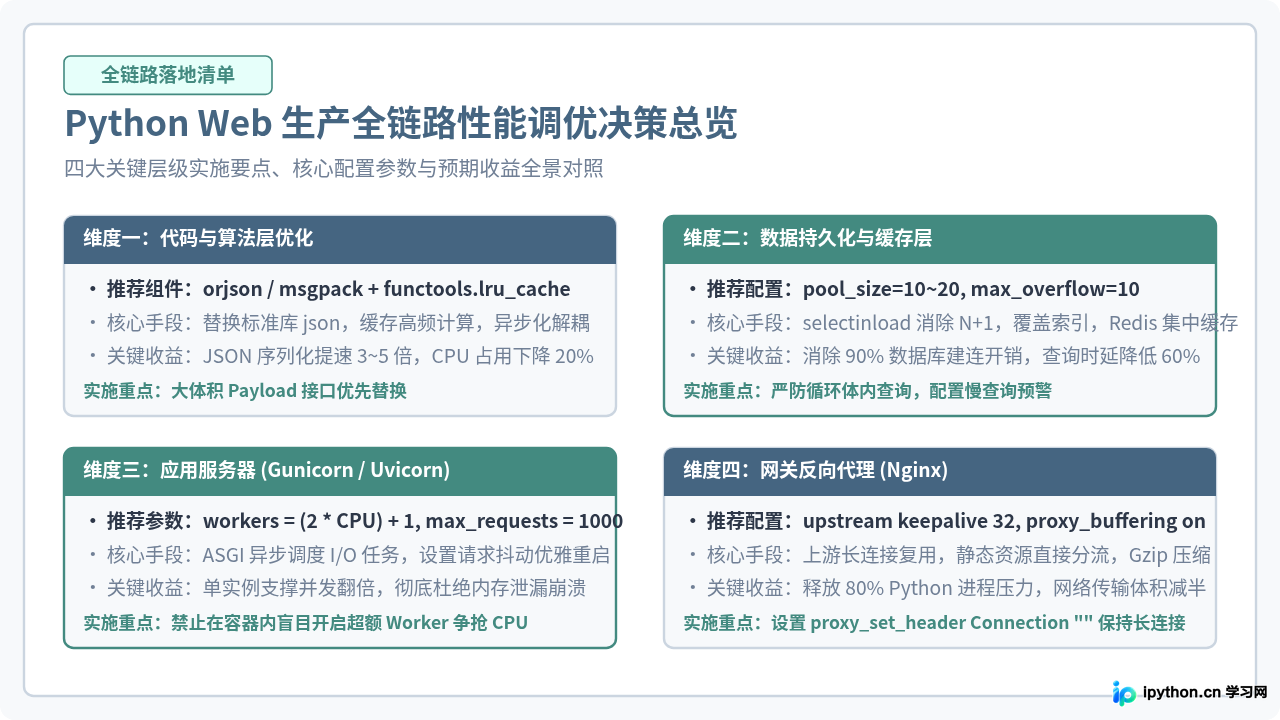
下表整理了全链路各个关键层级的核心优化措施、推荐参数与预期性能改善:
| 调优层级 | 主要瓶颈 | 实施措施与推荐配置 | 预期性能改善 |
|---|---|---|---|
| 代码与序列化 | JSON 编解码与 CPU 循环重复计算 | 使用 orjson / msgpack,接入 functools.lru_cache |
JSON 吞吐提升 3~5 倍,CPU 占用下降 15%~25% |
| 数据持久层 | TCP 频繁建连与 ORM N+1 循环查询 | 配置 SQLAlchemy 连接池 (pool_size=10~20),显式使用 selectinload |
消除 90% 建连开销,长尾延迟 P99 下降 50% 以上 |
| 应用服务器 | Worker 数量不当与进程内存泄露 | 设置 workers = (2*CPU)+1,配置 max_requests=1000 平滑重启 |
最大吞吐量翻倍,消除内存无限增长崩溃风险 |
| 网关反向代理 | 慢客户端霸占 Worker 与网络频繁握手 | Nginx 开启 proxy_buffering on 与 upstream keepalive 32 |
Python 进程处理周期缩短 40%,系统抗并发能力显著增强 |
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















