


Python数据结构与算法练习题精选(含答案)

掌握数据结构与算法的核心在于通过经典题目建立清晰的解题思维,并将抽象逻辑转化为稳定可靠的代码。本文精选了五道涵盖数组、链表、栈、二叉树与二分查找的高频实用练习题,每道题目均提供详细的思考路径、完整的 Python 示例实现、输入输出验证以及关键易错点梳理,帮助你在面对同类问题时能够准确选型并写出高效解法。
一、算法题目的系统化解题思维与流程
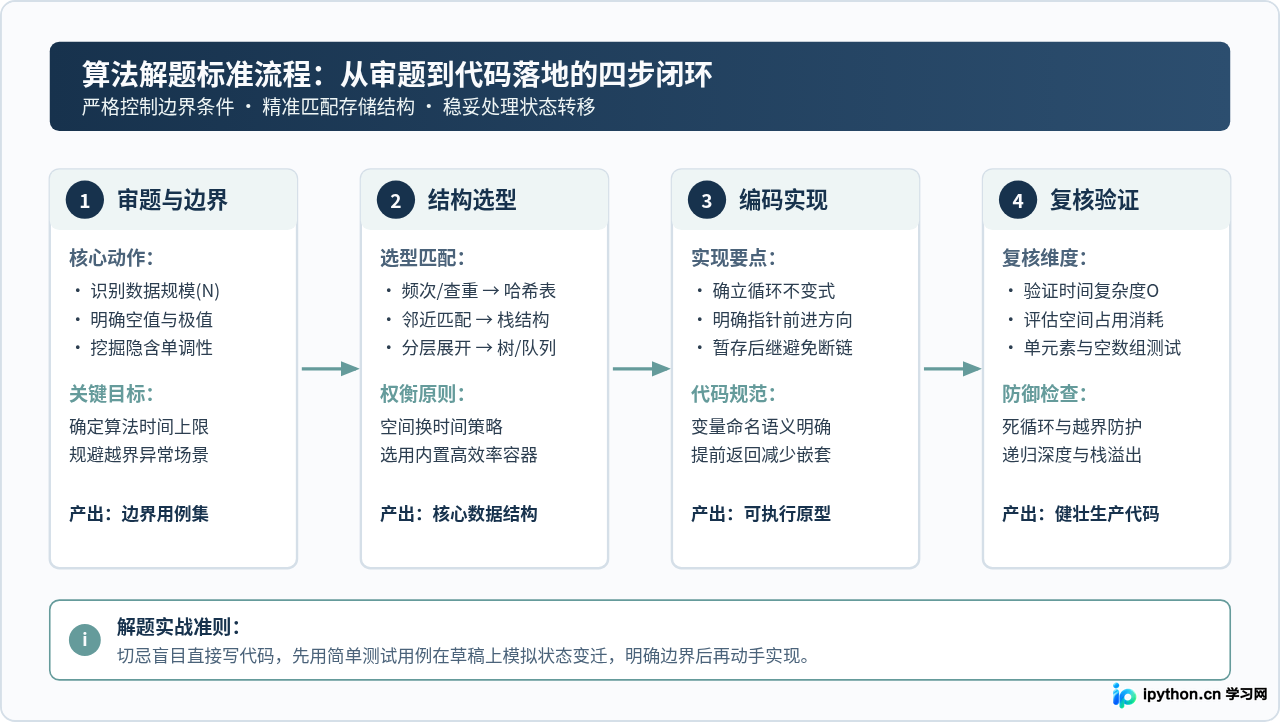
在动手编写代码之前,建立标准化的分析闭环能够显著降低逻辑漏洞与运行错误。面对任何算法问题,建议按照明确的步骤推进:首先明确数据规模与极值边界,以此推导允许的时间复杂度;其次挑选最契合访问特性的数据结构;接着设计循环不变式并完成编码;最后通过边界用例复核程序鲁棒性。
二、练习题一:数组与哈希表——两数之和
题目描述:给定一个整数数组 nums 和一个整数目标值 target,请你在该数组中找出和为目标值 target 的那两个整数,并返回它们的数组下标。你可以假设每种输入只对应一个有效答案,但数组中同一个元素在答案里不能重复出现。
1. 解题思路与结构匹配
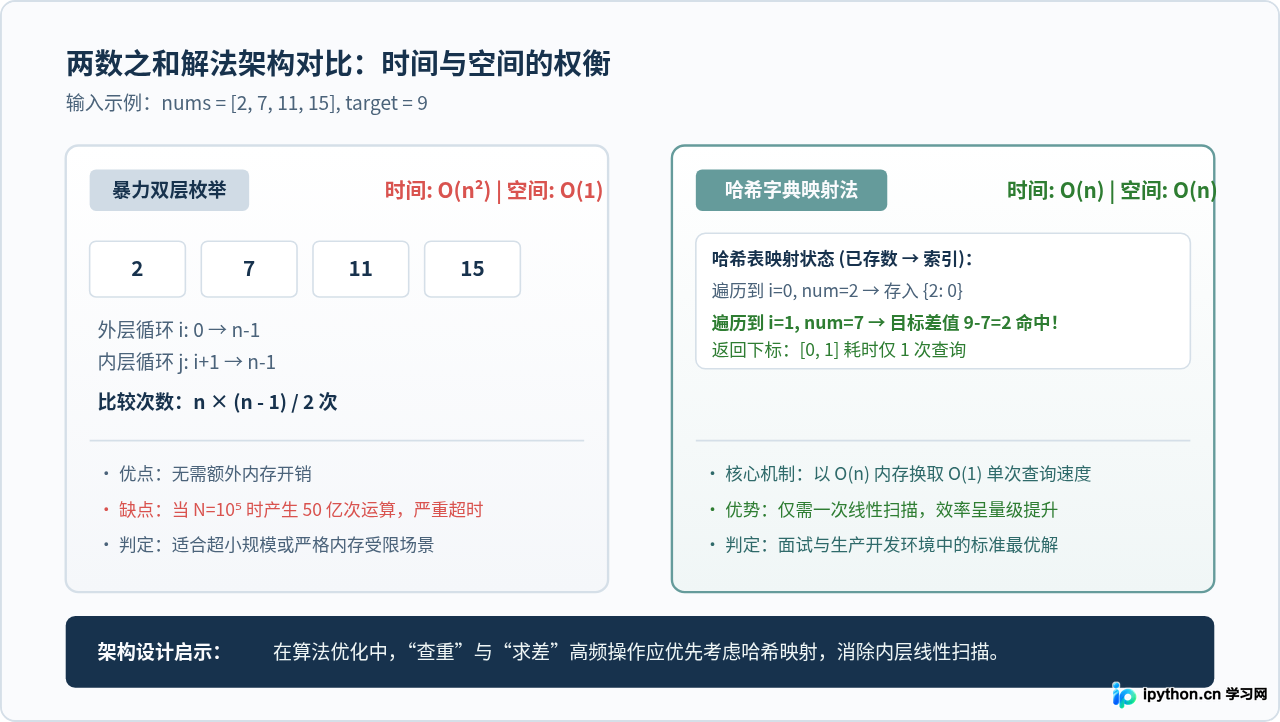
最直观的暴力解法是使用两层嵌套循环,外层固定元素 nums[i],内层从 i + 1 开始查找 nums[j] == target - nums[i]。当数组长度达到 10⁵ 时,比较次数约为 5 × 10⁹,必定触发执行超时。
优化路径在于引入哈希表(Python 内置 dict)。哈希表支持平均 O(1) 的键值检索。在单次遍历过程中,对于当前数字 num,我们计算补数 complement = target - num。若该补数已存在于哈希表中,说明先前已扫描过匹配值,直接返回两者的索引;若不存在,则将当前 {num: index} 存入哈希表继续扫描。这样将两层循环的时间复杂度降为单层线性扫描。
2. Python 完整代码实现
def two_sum(nums: list[int], target: int) -> list[int]:
    """
    使用哈希表在 O(n) 时间内找出和为 target 的两个数的下标。
    """
    num_to_index = {}
    for current_index, num in enumerate(nums):
        complement = target - num
        # 检查所需补数是否已经在哈希表中
        if complement in num_to_index:
            return [num_to_index[complement], current_index]
        # 记录当前元素及其下标,供后续元素查找
        num_to_index[num] = current_index
    return []

# 验证调用
test_nums = [2, 7, 11, 15]
test_target = 9
result = two_sum(test_nums, test_target)
print("计算结果:", result)
示例输出:
计算结果: [0, 1]3. 复杂度与注意事项
- 时间复杂度:O(n),每个元素仅扫描一次,哈希表插入与查找均摊耗时为 O(1)。
- 空间复杂度:O(n),最坏情况下需要将所有元素存入字典。
- 防踩坑要点:切勿先一次性将所有元素存入哈希表再遍历查找,否则当数组包含相同元素(如
nums = [3, 3], target = 6)时,后存入的索引会覆盖前面的索引,导致逻辑错误或出现同一个下标被重复使用的违规行为。边查边存可天然规避重复使用自身的问题。
三、练习题二:链表——反转单向链表
题目描述:给你单链表的头节点 head,请你反转链表,并返回反转后的头节点指针。
1. 解题思路与指针推导
单向链表的每个节点仅保存其后继节点的地址引用。若直接将 curr.next 指向前驱节点 prev,会导致原后继节点的引用丢失,从而发生断链。因此,在迭代过程中,必须先用临时变量 next_node = curr.next 保存下一节点的地址,再实施反转操作。
2. Python 完整代码实现
class ListNode:
    def __init__(self, val: int = 0, next: "ListNode | None" = None):
        self.val = val
        self.next = next

def reverse_list(head: ListNode | None) -> ListNode | None:
    """
    双指针迭代法反转单向链表。
    """
    prev = None
    curr = head
    while curr is not None:
        # 步骤 1:提前暂存后继节点,防止断链
        next_node = curr.next
        # 步骤 2:反转当前节点的指向
        curr.next = prev
        # 步骤 3:前驱指针前移
        prev = curr
        # 步骤 4:当前指针移动至暂存的后继节点
        curr = next_node
    # 循环终止时 curr 为 None,prev 恰好指向新的头节点
    return prev

# 辅助函数:构建链表
def build_linked_list(arr: list[int]) -> ListNode | None:
    dummy = ListNode(0)
    tail = dummy
    for v in arr:
        tail.next = ListNode(v)
        tail = tail.next
    return dummy.next

# 辅助函数:输出链表
def print_linked_list(head: ListNode | None) -> list[int]:
    nodes = []
    while head is not None:
        nodes.append(head.val)
        head = head.next
    return nodes

# 验证调用
test_head = build_linked_list([1, 2, 3, 4, 5])
reversed_head = reverse_list(test_head)
print("反转后链表节点序列:", print_linked_list(reversed_head))
示例输出:
反转后链表节点序列: [5, 4, 3, 2, 1]3. 复杂度与注意事项
- 时间复杂度:O(n),每个链表节点仅被访问一次。
- 空间复杂度:O(1),仅使用常数个辅助指针,无需开辟额外堆内存。
- 边界处理:当输入为空链表(
head is None)或只有一个节点时,循环体直接跳过或仅执行一次,能正确返回None或原节点。
四、练习题三:栈——有效的括号匹配
题目描述:给定一个只包括 '('、')'、'{'、'}'、'['、']' 的字符串 s,判断字符串是否有效。有效字符串需满足:左括号必须用相同类型的右括号闭合,左括号必须以正确的顺序闭合,且每个右括号都有一个对应的相同类型左括号。
1. 解题思路与状态推导
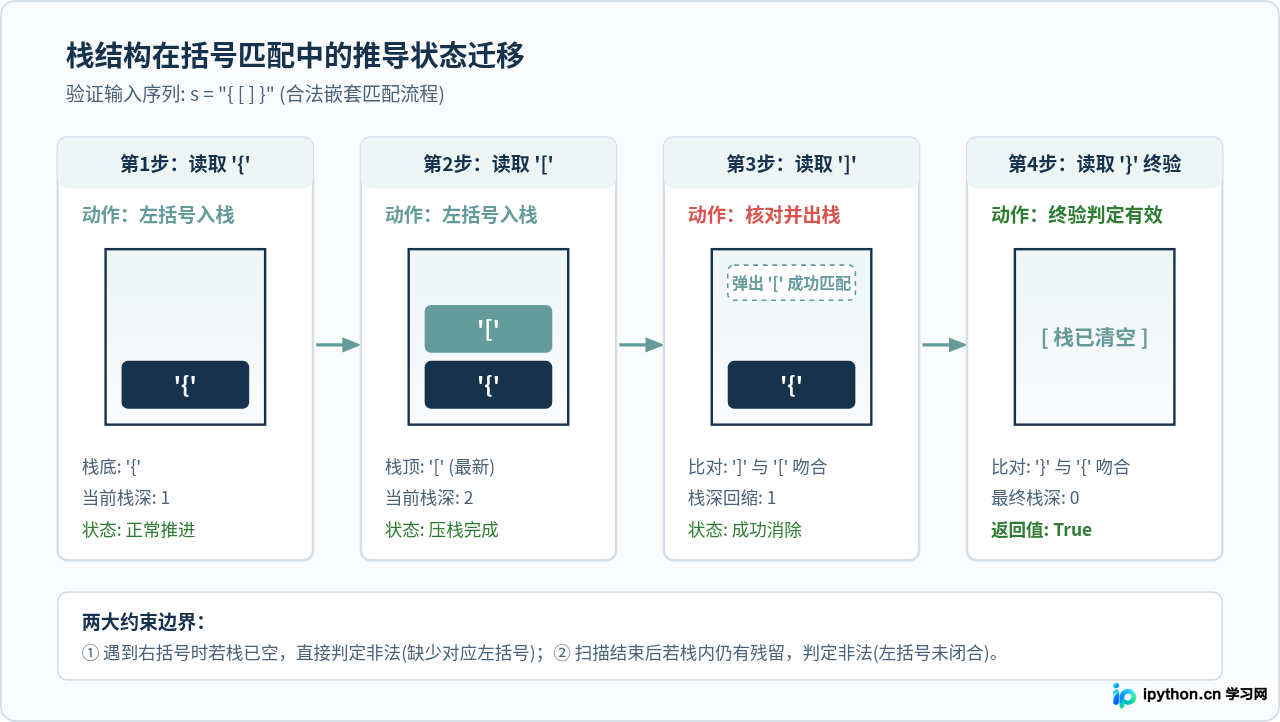
括号匹配具有显著的“后闭合优先配对”特性,即最后出现的左括号必须最先被对应的右括号闭合。这种“后进先出(LIFO)”的行为模式与“栈”数据结构高度契合。
具体策略:建立右括号到左括号的映射字典 mapping = {')': '(', '}': '{', ']': '['}。遍历字符串时,遇到左括号直接压入栈中;遇到右括号时,若栈已为空,说明缺少匹配的左括号,判定非法;若栈非空,则弹出栈顶元素比对,不相等即非法。遍历完毕后,若栈内仍有未消除的左括号,同样判定为非法。
2. Python 完整代码实现
def is_valid_parentheses(s: str) -> bool:
    """
    使用栈结构验证括号字符串的有效性。
    """
    # 建立右括号到对应左括号的映射字典
    mapping = {")": "(", "}": "{", "]": "["}
    stack = []

    for char in s:
        if char in mapping:
            # 遇到右括号:若栈为空,或者栈顶元素与预期左括号不符,则非法
            if not stack or stack[-1] != mapping[char]:
                return False
            stack.pop()
        else:
            # 遇到左括号:压入栈中
            stack.append(char)

    # 扫描结束后必须确认栈内无剩余未闭合左括号
    return len(stack) == 0

# 验证调用
test_valid = "{[()]}"
test_invalid = "{[(])}"
print("序列 '{[()]}' 判定结果:", is_valid_parentheses(test_valid))
print("序列 '{[(])}' 判定结果:", is_valid_parentheses(test_invalid))
示例输出:
序列 '{[()]}' 判定结果: True
序列 '{[(])}' 判定结果: False
3. 复杂度与注意事项
- 时间复杂度:O(n),字符串只进行一次线性扫描。
- 空间复杂度:O(n),最坏情况下(全为左括号)栈占用 O(n) 的内存。
- 防踩坑要点:切记在弹出栈顶前先判断
not stack,防止在输入如")("时因对空列表执行pop()抛出IndexError。
五、练习题四:二叉树——二叉树的最大深度
题目描述:给定一个二叉树的根节点 root,返回其最大深度。最大深度是指从根节点到最远叶子节点的最长路径上的节点数。
1. 解题思路:深度优先(DFS)与广度优先(BFS)
二叉树深度可通过分治递归法极简求解:树的最大深度等于根节点本身(1)加上左右子树深度的较大者,即 1 + max(dfs(left), dfs(right))。递归基线为遇到 None 时深度为 0。
此外,使用队列进行层序遍历(BFS)同样直观:每次按层处理当前队列中的所有节点,并将它们的非空子节点压入队列,每一层循环使深度计数值加 1。
2. Python 完整代码实现
from collections import deque

class TreeNode:
    def __init__(self, val: int = 0, left: "TreeNode | None" = None, right: "TreeNode | None" = None):
        self.val = val
        self.left = left
        self.right = right

def max_depth_dfs(root: TreeNode | None) -> int:
    """
    DFS 递归法计算二叉树最大深度。
    """
    if root is None:
        return 0
    left_depth = max_depth_dfs(root.left)
    right_depth = max_depth_dfs(root.right)
    return 1 + max(left_depth, right_depth)

def max_depth_bfs(root: TreeNode | None) -> int:
    """
    BFS 层序遍历队列法计算二叉树最大深度。
    """
    if root is None:
        return 0
    queue = deque([root])
    depth = 0
    while queue:
        level_size = len(queue)
        for _ in range(level_size):
            node = queue.popleft()
            if node.left is not None:
                queue.append(node.left)
            if node.right is not None:
                queue.append(node.right)
        depth += 1
    return depth

# 验证调用:构建树 [3, 9, 20, None, None, 15, 7]
tree_root = TreeNode(3)
tree_root.left = TreeNode(9)
tree_root.right = TreeNode(20, TreeNode(15), TreeNode(7))

print("DFS 计算最大深度:", max_depth_dfs(tree_root))
print("BFS 计算最大深度:", max_depth_bfs(tree_root))
示例输出:
DFS 计算最大深度: 3
BFS 计算最大深度: 3
3. 复杂度与注意事项
- 时间复杂度:O(n),DFS 与 BFS 均需遍历二叉树中的每个节点恰好一次。
- 空间复杂度:DFS 为 O(h)(h 为树的高度,平衡二叉树时为 O(log n),退化为单支树时为 O(n));BFS 队列最大宽度在满二叉树底层时为 O(n)。
- 边界防御:当根节点为
None时,直接返回 0,不可对None对象访问属性。
六、练习题五:二分查找——区间收缩与边界控制
题目描述:给定一个按照升序排列的整数数组 nums 和一个目标值 target,写一个函数搜索 nums 中的 target,如果目标值存在返回下标,否则返回 -1。
1. 解题思路与边界闭环
二分查找的关键在于维持“循环不变量”。推荐使用标准的左闭右闭区间 [left, right]:初始时 left = 0, right = len(nums) - 1。因为区间两端均为闭合有效点,循环条件必须采用 left <= right。
在中间索引计算上,采用 mid = left + (right - left) // 2 可防止在极端大数下标下发生数值溢出。当 nums[mid] < target 时,说明目标在右半段,收缩左边界为 left = mid + 1;当 nums[mid] > target 时,收缩右边界为 right = mid - 1。
2. Python 完整代码实现
def binary_search(nums: list[int], target: int) -> int:
    """
    闭区间 [left, right] 标准二分查找实现。
    """
    left = 0
    right = len(nums) - 1

    while left <= right:
        # 防溢出中点计算方式
        mid = left + (right - left) // 2
        if nums[mid] == target:
            return mid
        elif nums[mid] < target:
            # 目标在右侧,收缩左边界
            left = mid + 1
        else:
            # 目标在左侧,收缩右边界
            right = mid - 1

    return -1

# 验证调用
sorted_array = [-1, 0, 3, 5, 9, 12]
find_target = 9
not_found_target = 2

print("查找 9 的下标:", binary_search(sorted_array, find_target))
print("查找 2 的下标:", binary_search(sorted_array, not_found_target))
示例输出:
查找 9 的下标: 4
查找 2 的下标: -1
3. 复杂度与注意事项
- 时间复杂度:O(log n),每次判断排除一半区间候选值。
- 空间复杂度:O(1),原地迭代,无额外内存开销。
- 核心陷阱:不可将循环条件写为
left < right,否则在单元素命中场景(如nums = [5], target = 5)下,由于left == right == 0会直接跳出循环造成漏检。
七、精选题型知识架构与实战复习矩阵
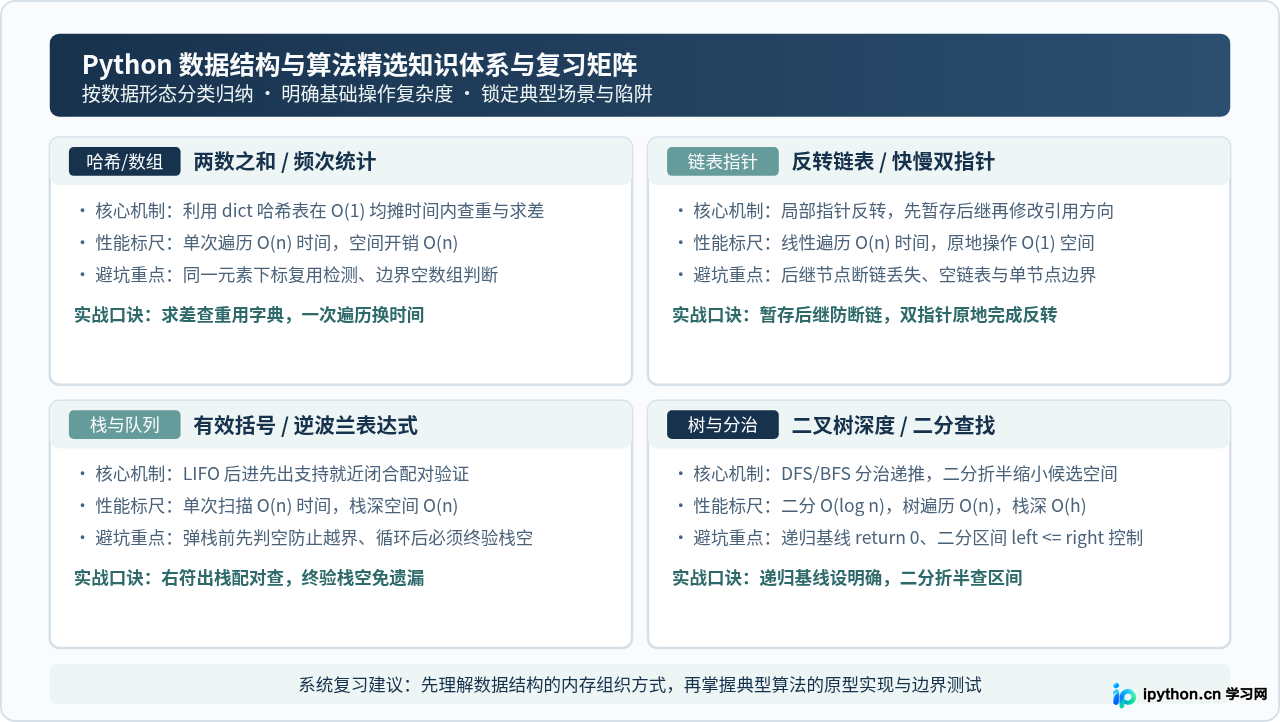
练习算法题目的本质是理解底层存储形式对操作开销的决定性作用。在复习过程中,建议将各类基础题型归纳为结构与模式特征:哈希表消除嵌套循环、双指针优化原地重排、栈处理逆序匹配、分治拆解复杂层级。下表汇总了本篇五道核心题型的架构精要与实战要诀。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















