


LangChain在Python AI应用集成中的优势与用法

在基于 Python 构建大语言模型应用时,开发者如果直接调用各厂商提供的底层 SDK,往往需要编写大量用于参数转换、上下文拼接和异常重试的胶水代码。LangChain 针对这一痛点,通过标准化的接口抽象、声明式表达式语言(LCEL)以及对检索与工具生态的深度整合,提供了一套面向工程化的编排规范。本文将剖析 LangChain 在 Python AI 应用集成中的核心优势,并通过完整可运行的代码演示从基础流水线组装、模型平滑切换到生产级容灾的标准化用法。
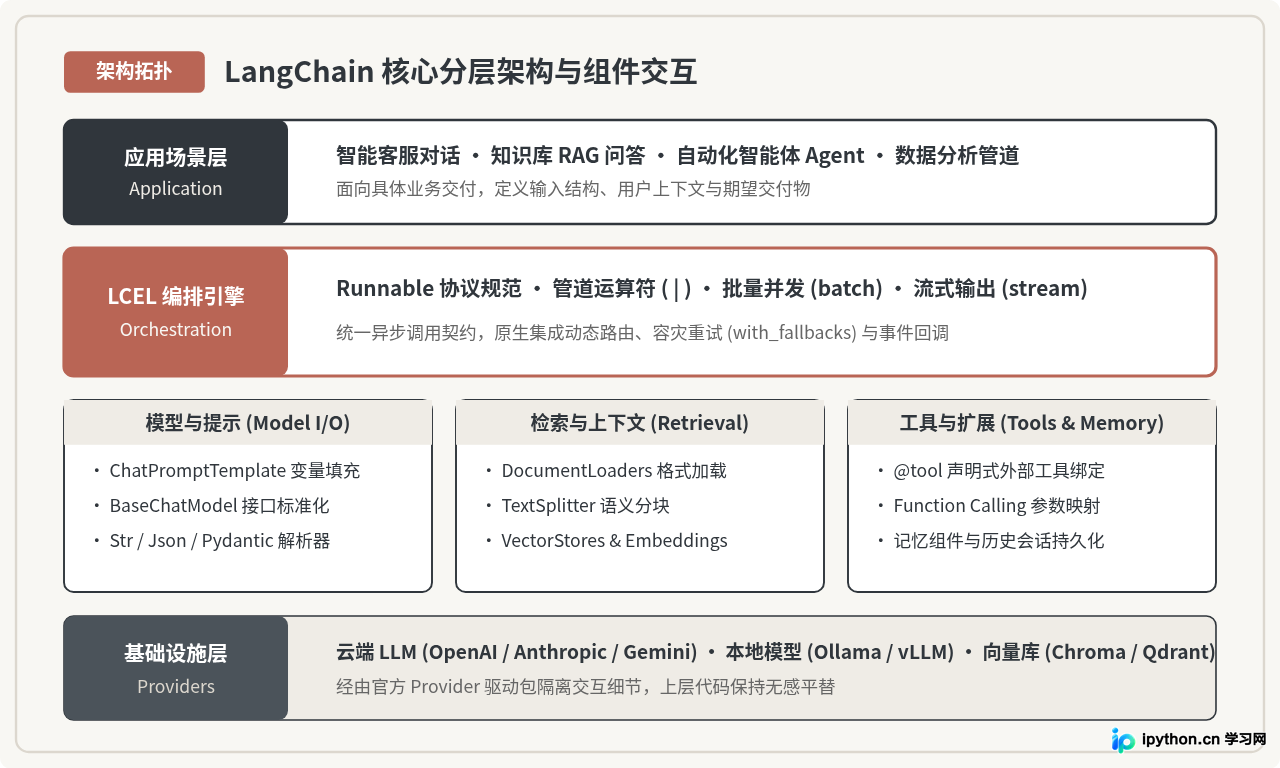
一、LangChain 在 Python AI 集成中的核心优势
评估一个 AI 应用开发框架的工程价值,不能仅看简单的“对话封装”,而要看其在面对真实业务复杂度时所能提供的复用度与扩展能力。LangChain 在 Python 生态中的优势主要体现在三个层面:
- 标准化的模型 I/O 抽象:统一了 OpenAI、Anthropic、Gemini 以及本地 Ollama 等数十种模型的调用输入与输出格式。上层应用只需依赖通用的
BaseChatModel规范,更换底层模型提供商时无需重写业务调用逻辑。 - LCEL(LangChain 表达式语言)声明式编排:采用函数式管道设计,通过 Python 重载的
|运算符直观拼接提示词模板、模型与输出解析器,内置异步调用(ainvoke)、批处理(batch)与流式穿透(astream)支持。 - 全链路生产级治理:开箱即用支持模型降级切换(
with_fallbacks)、重试补偿、并发控制以及标准化的链路追踪(Tracing),避免了自行维护状态机带来的冗余代码。
二、原生 SDK 直接调用 vs LangChain 编排机制对比
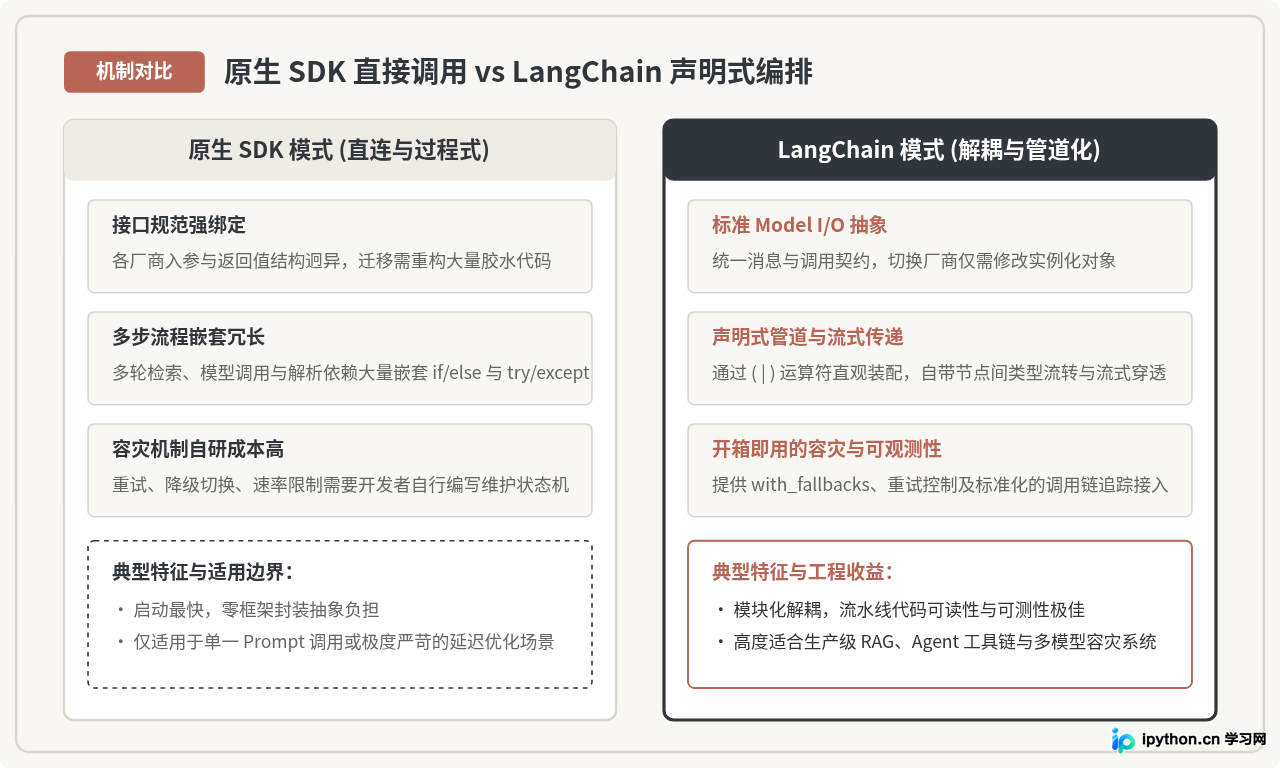
许多团队在技术选型初期会纠结:是否值得为了集成大模型引入一个框架?通过对比两者在核心维度的实现机制,可以明确其权衡边界:
- 代码耦合度:使用原生 SDK 时,请求参数(如
messages格式、temperature传递方式)和返回对象解析均与特定 SDK 紧密耦合。一旦需要接入新模型或本地开源模型,往往需要重构调用层。LangChain 的BaseChatModel则抹平了这类差异。 - 复杂链式流转:当业务演变为“检索向量库 -> 筛选重排序 -> 注入提示词 -> 模型推理 -> 结构化验证”的多步流程时,原生 SDK 代码会充斥着深层嵌套与临时变量;而 LCEL 将其转化为扁平、高可读的流水线。
- 维护边界:原生 SDK 的优势在于启动速度快、零额外框架依赖,非常适合单一 Prompt、单次生成的极简脚本;但在企业级复杂应用中,LangChain 提供的规范化资产复用性显著优于自研胶水层。
三、LangChain 在 Python 中的核心用法与代码实现
在当前最新的 LangChain 设计规范中,核心框架已全面解耦为精简的基础核心包 langchain-core 与各厂商专用驱动包。以下按照项目落地的真实步骤展开讲解。
步骤 1:安装轻量依赖并配置运行环境
在 Python 虚拟环境中,推荐按需安装最小依赖集,避免引入早期版本中庞大且废弃的单体包:
# 安装核心基础库与目标模型驱动
pip install langchain-core langchain-openai

# 导出 API 认证密钥(以环境变量方式管理,严禁硬编码进代码)
export OPENAI_API_KEY="sk-your-openai-api-key"
步骤 2:使用 LCEL 组装基础对话处理链
通过提示词模板、模型与字符串输出解析器,使用 | 运算符即可完成标准调用链的组装:
from langchain_core.prompts import ChatPromptTemplate
from langchain_core.output_parsers import StrOutputParser
from langchain_openai import ChatOpenAI

# 1. 声明结构化提示词模板
prompt = ChatPromptTemplate.from_messages([
    ("system", "你是一名资深 Python 架构师,回答要求条理清晰、紧扣要点。"),
    ("human", "{question}")
])

# 2. 实例化模型对象
model = ChatOpenAI(model="gpt-4o-mini", temperature=0.2)

# 3. 声明输出解析器
parser = StrOutputParser()

# 4. 使用 LCEL 管道符声明式组装
chain = prompt | model | parser

# 5. 执行同步调用
result = chain.invoke({"question": "解释 Python 中的 GIL 对多线程 CPU 密集型任务的影响。"})
print(result)输出为格式化后的纯文本字符串,解析器已自动剥离底层响应对象的 AIMessage 外壳,直接交付业务层所需结果。
步骤 3:配置多模型备用与容灾降级(with_fallbacks)
在生产环境中,单一模型 API 偶发超时或服务限流是高频故障。LangChain 提供了开箱即用的平滑降级能力:
from langchain_core.prompts import ChatPromptTemplate
from langchain_core.output_parsers import StrOutputParser
from langchain_openai import ChatOpenAI

# 声明首选主模型与容灾备用模型
primary_model = ChatOpenAI(model="gpt-4o", timeout=5.0)
fallback_model = ChatOpenAI(model="gpt-4o-mini", timeout=10.0)

# 为主模型挂载备用模型链
resilient_model = primary_model.with_fallbacks([fallback_model])

prompt = ChatPromptTemplate.from_template("请用一句话总结:{topic}")
chain = prompt | resilient_model | StrOutputParser()

# 当 primary_model 触发超时或异常时,执行流会自动且无缝切换至 fallback_model
output = chain.invoke({"topic": "异步编程的核心价值"})
print(output)
步骤 4:结构化工具绑定与输出解析
现代 AI 应用往往需要大语言模型返回结构化数据(如 JSON/Pydantic 模型)或调用外部工具(Function Calling):
from typing import List
from pydantic import BaseModel, Field
from langchain_core.prompts import ChatPromptTemplate
from langchain_core.output_parsers import PydanticOutputParser
from langchain_openai import ChatOpenAI

# 定义业务所需的数据结构契约
class CodeReviewResult(BaseModel):
    passed: bool = Field(description="代码评审是否通过")
    score: int = Field(description="代码质量评分,范围 1 到 100")
    suggestions: List[str] = Field(description="改进建议清单")

parser = PydanticOutputParser(pydantic_object=CodeReviewResult)

prompt = ChatPromptTemplate.from_messages([
    ("system", "你是一名代码审查助手。请严格按照以下格式输出审查结论:\n{format_instructions}"),
    ("human", "代码片段:\n{code}")
]).partial(format_instructions=parser.get_format_instructions())

model = ChatOpenAI(model="gpt-4o-mini", temperature=0.0)
review_chain = prompt | model | parser

# 执行调用,直接获得强类型的 Pydantic 对象实例
review = review_chain.invoke({"code": "def add(a, b): return a + b"})
print(f"审核状态: {review.passed}, 分数: {review.score}")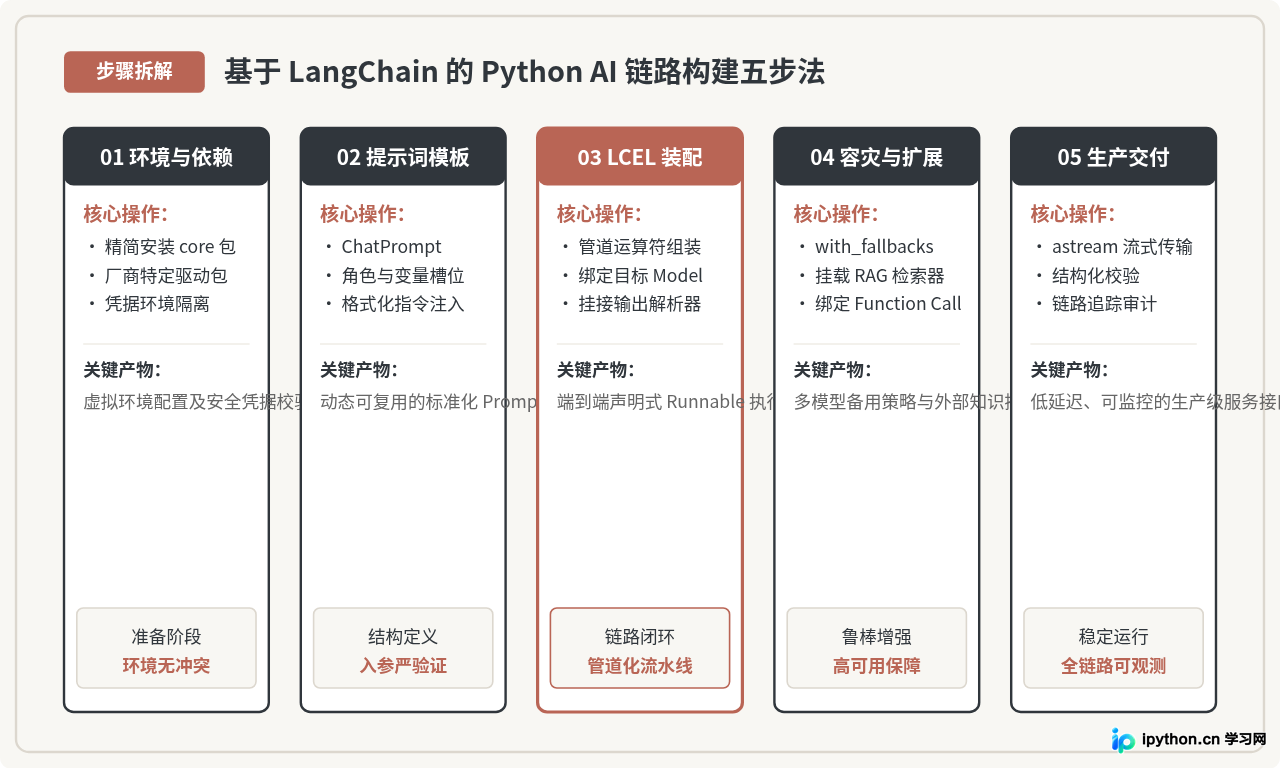
四、生产环境落地的关键注意事项与常见陷阱
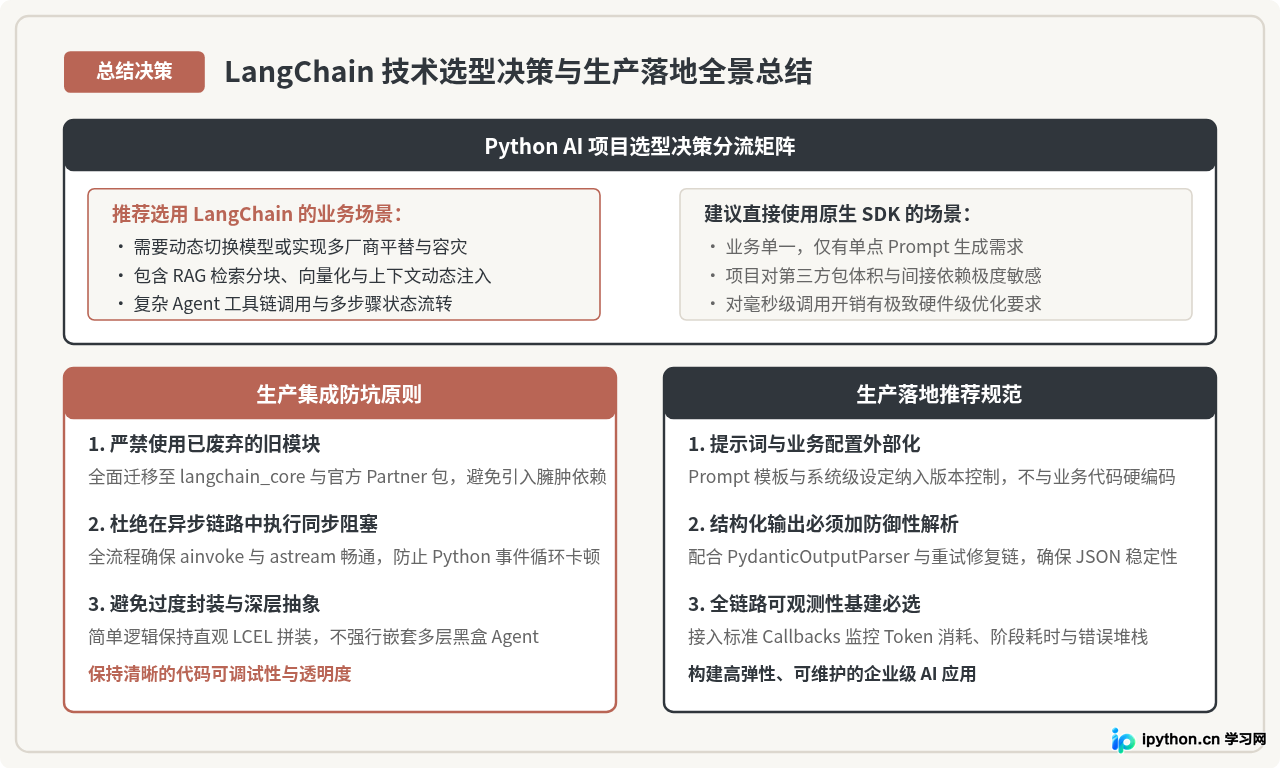
将 LangChain 引入生产系统时,如果缺乏清晰的工程规范,容易踩入包体积过大、事件循环阻塞等陷阱。团队应重点遵循以下三条原则:
- 精简依赖与版本边界:切忌直接安装历史遗留的单体
langchain完整包。现代实践应只引入langchain-core以及专用的 Provider 包(如langchain-openai、langchain-community)。已废弃的旧版类库(如老旧的LLMChain或弃用的initialize_agent)应坚决杜绝使用。 - 保持异步穿透,杜绝阻塞调用:在 FastAPI 等基于异步事件循环(
asyncio)的 Web 服务中,必须统一使用chain.ainvoke()或chain.astream()。一旦在异步路由中调用同步的chain.invoke(),将导致整个工作线程被大模型网络 I/O 阻塞。 - 全链路可观测性不可或缺:必须接入标准 Callbacks 监听器,或者集成 OpenTelemetry 与专业追踪平台。对每个节点的 Token 消耗量、端到端延迟(TTFT 首字延迟)及返回码实施精准监控。
五、总结
LangChain 为 Python AI 应用集成建立了一套兼具灵活性与工程弹性的开发范式。通过 Model I/O 抽象解除对特定模型提供商的深度绑定,依托 LCEL 管道提供清晰的流式与异步编排能力,配合丰富的检索与工具生态,能够帮助技术团队在复杂度递增的场景下维持代码库的整洁与可维护性。在具体落地中,遵循现代模块化引入、善用 with_fallbacks 容灾并坚持异步与可观测性实践,是构建高可用 Python AI 服务的坚实基础。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















