


Python asyncio入门:从同步代码到异步思维的转变

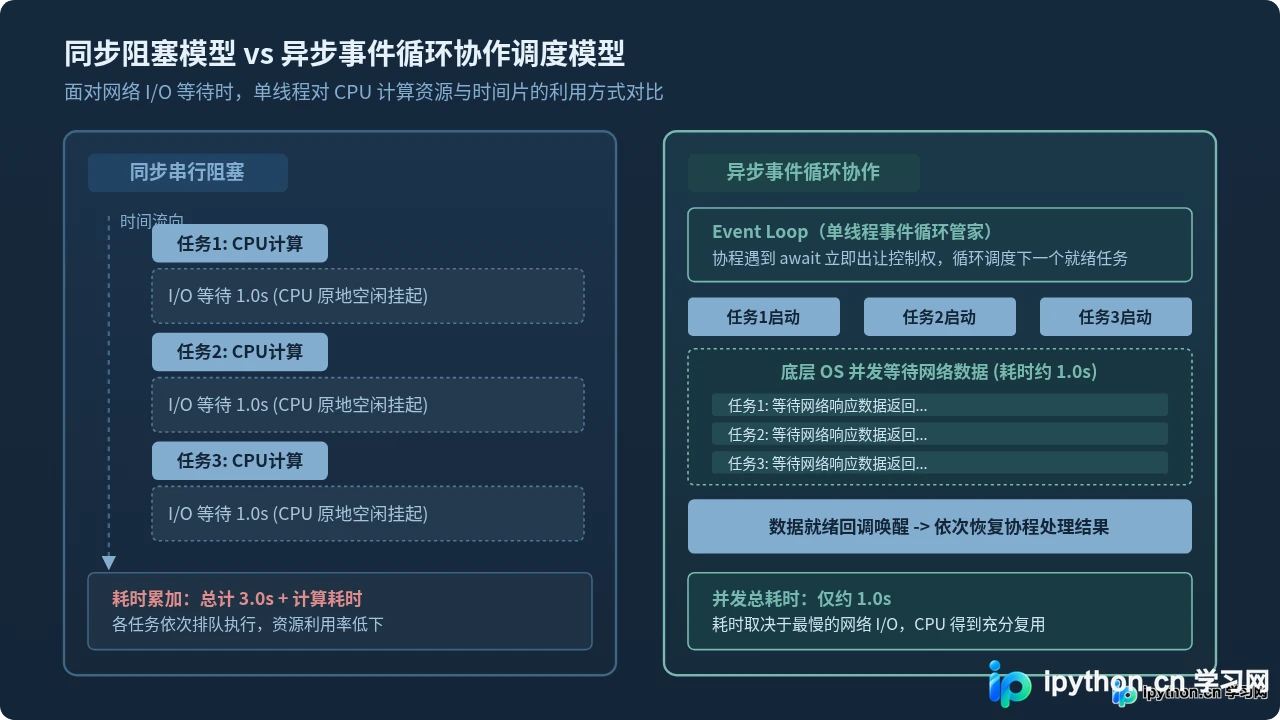
假设我们需要编写一个网络爬虫脚本,从 10 个不同的远程接口拉取数据,每个接口在网络传输中稳定需要 1 秒钟返回。在传统的同步编程模式下,脚本会发出第 1 个请求并停在原地等待其完成,接着再发起第 2 个、第 3 个……整套流程走完总耗时必然超过 10 秒。在这个过程中,计算机性能强劲的 CPU 实际上有超过 95% 的时间处于空闲等待状态,只是在被动等待网络数据包到达。如果在发出网络请求的瞬间,程序能够立刻转去发起下一个请求,并在任意请求返回数据时再交替处理结果,整个过程就能在略大于 1 秒的时间内全部结束。Python 的 asyncio 标准库正是解决这一 I/O 阻塞问题的核心工具。理解 asyncio 的关键并非记住几个语法关键字,而是完成从“按序阻塞等待”到“事件驱动协作”的思维方式转变。
一、同步阻塞与异步非阻塞:理解单线程中的协作调度
在同步代码中,函数的执行遵循严格的线性因果关系:一行代码未执行完毕,下一行代码就绝不可能启动。这种模型符合人类的自然直觉,但在处理网络请求、磁盘文件读写或数据库查询等 I/O 密集型任务时,会导致严重的性能浪费。调用方线程在发起 I/O 操作后会被操作系统挂起,CPU 资源无法在该线程内得到继续利用。
面对 I/O 阻塞,传统的解决方案是创建多线程或多进程。然而,多线程由操作系统进行抢占式调度,线程切换伴随着栈上下文保存、内核态转换以及显著的内存开销;更重要的是,Python 的全局解释器锁(GIL)使得多线程无法并行执行 Python 字节码,且多线程共享内存带来了难以调试的锁竞争和竞态条件风险。相比之下,asyncio 采用的是基于单线程的用户态协作式多任务(Cooperative Multitasking)模型。在一个线程内部,程序维护一个高效的事件循环;任务在遇到 I/O 等待时通过 await 主动让出 CPU 控制权,通知事件循环调度其他已准备就绪的任务执行。这种切换完全发生在用户空间,内存占用极小,单机支撑数万个并发任务成为可能。
二、asyncio 核心基石:协程、await 与事件循环
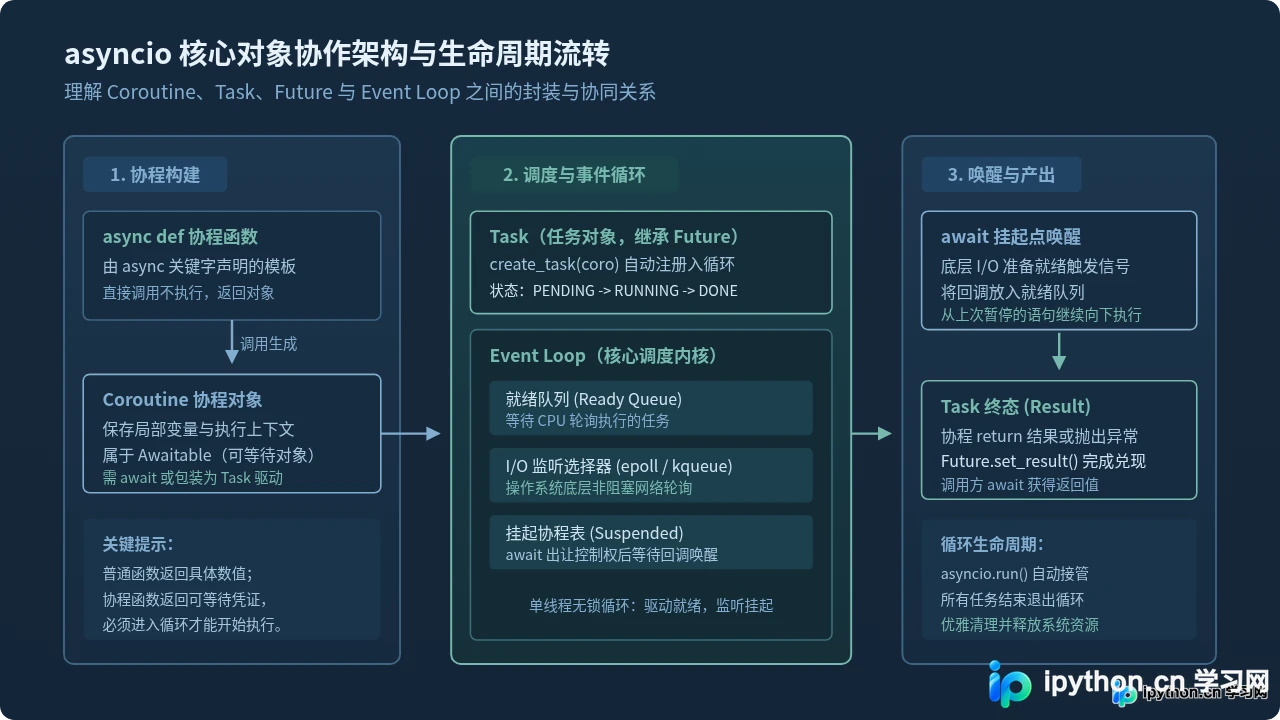
编写 asyncio 代码时,我们主要与四个核心概念打交道:协程函数(Coroutine Function)、协程对象(Coroutine Object)、Task 任务以及事件循环(Event Loop)。它们共同构成了异步调度的完整闭环:
- 协程函数与协程对象:使用
async def声明的函数即为协程函数。与普通函数不同,直接调用协程函数并不会立刻执行函数体中的代码,而是仅仅生成并返回一个协程对象。你可以将协程对象看作一张“待兑现的任务凭证”,它封装了函数的执行逻辑与局部状态,但必须被送入事件循环中才能实际运转。 - await 关键字的语义:
await是协作式调度的核心动作。它只能出现在async def函数内部,后面必须跟随一个可等待对象(Awaitable)。当执行到await expr时,当前协程会主动暂停自身的执行,并将 CPU 控制权交还给事件循环,附带一条指令:“在expr所代表的 I/O 完成前不要再唤醒我”。事件循环随即去执行其他就绪任务。 - Task 与 Future:协程对象本身是惰性的。通过
asyncio.create_task(coro),我们将协程包装成一个Task对象。Task继承自底层的Future,并在创建的瞬间被立即注册到事件循环的就绪队列中,进入可被调度的状态。 - 事件循环:事件循环是单线程调度的“心脏”。它在一个无限循环中轮询:一方面监听底层的系统 I/O 多路复用器(如 Linux 的 epoll 或 macOS 的 kqueue),另一方面按顺序驱动就绪队列中的任务执行到下一个
await挂起点。
三、实战重构:从同步阻塞到异步并发的四步演进
为了直观展现从同步到异步的改造过程,我们首先来看一段典型的同步代码。该程序使用 time.sleep(1.0) 模拟 3 次分别耗时 1 秒的网络数据获取任务:
# 示例 1:同步阻塞版本(耗时累加)
import time

def fetch_data(task_id: int, delay: float) -> str:
    print(f"[任务 {task_id}] 开始同步请求,预计等待 {delay} 秒...")
    time.sleep(delay)  # 致命阻塞点:挂起整个线程
    print(f"[任务 {task_id}] 同步请求完成!")
    return f"数据_{task_id}"

def main():
    start_time = time.time()
    results = []
    for task_id in range(1, 4):
        res = fetch_data(task_id, 1.0)
        results.append(res)
    total_duration = time.time() - start_time
    print(f"全部完成,返回数据: {results}")
    print(f"同步总耗时: {total_duration:.2f} 秒")

if __name__ == "__main__":
    main()
[示例输出]
[任务 1] 开始同步请求,预计等待 1.0 秒...
[任务 1] 同步请求完成!
[任务 2] 开始同步请求,预计等待 1.0 秒...
[任务 2] 同步请求完成!
[任务 3] 开始同步请求,预计等待 1.0 秒...
[任务 3] 同步请求完成!
全部完成,返回数据: ['数据_1', '数据_2', '数据_3']
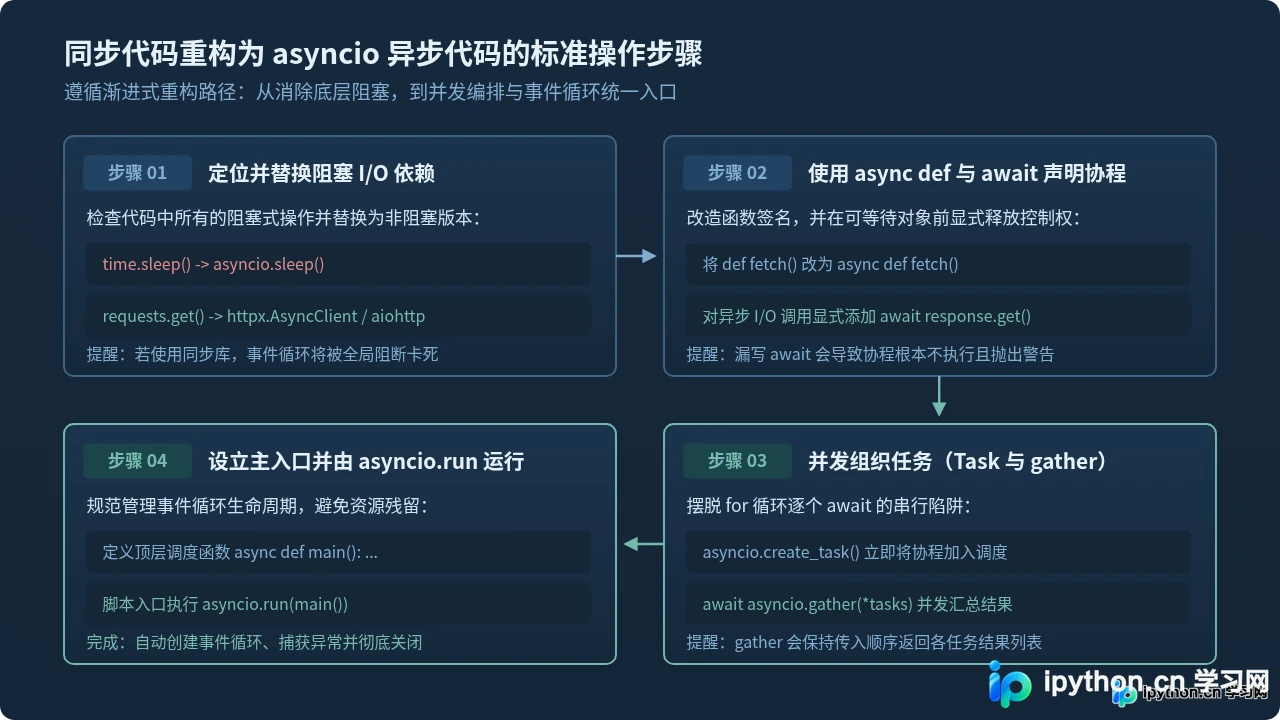
同步总耗时: 3.01 秒从输出中可以看到,3 个任务完全排队执行,总耗时为各任务耗时之和(3.01 秒)。接下来,我们按照标准重构步骤将其改写为 asyncio 异步并发版本:
# 示例 2:重构后的 asyncio 异步并发版本
import asyncio
import time

async def fetch_data(task_id: int, delay: float) -> str:
    print(f"[任务 {task_id}] 开始异步请求,预计等待 {delay} 秒...")
    # 步骤 1 & 2:使用非阻塞的 asyncio.sleep 并主动 await 出让控制权
    await asyncio.sleep(delay)
    print(f"[任务 {task_id}] 异步请求完成!")
    return f"数据_{task_id}"

async def main():
    start_time = time.time()
    # 步骤 3:构建协程列表,并通过 asyncio.gather 并发启动与结果聚合
    coros = [fetch_data(i, 1.0) for i in range(1, 4)]
    results = await asyncio.gather(*coros)

    total_duration = time.time() - start_time
    print(f"全部完成,返回数据: {results}")
    print(f"异步并发总耗时: {total_duration:.2f} 秒")

if __name__ == "__main__":
    # 步骤 4:由 asyncio.run 统筹管理事件循环的初始化与优雅回收
    asyncio.run(main())
[示例输出]
[任务 1] 开始异步请求,预计等待 1.0 秒...
[任务 2] 开始异步请求,预计等待 1.0 秒...
[任务 3] 开始异步请求,预计等待 1.0 秒...
[任务 1] 异步请求完成!
[任务 2] 异步请求完成!
[任务 3] 异步请求完成!
全部完成,返回数据: ['数据_1', '数据_2', '数据_3']
异步并发总耗时: 1.01 秒运行结果清晰证明了异步并发的威力:3 个任务几乎在同一瞬间交替发起,底层操作系统网络等待并行展开,程序在 1.01 秒内便收集齐了全部数据,执行效率相比同步串行直接提升了 3 倍。
四、常见误区与防坑指南
初学者在编写 asyncio 代码时极易踩入几个经典陷阱,导致程序看似写了 async 却毫无并发性能,甚至直接抛出异常:
asyncio 是单线程模型!如果在协程内部调用了 time.sleep()、传统的 requests.get() 或同步数据库驱动,该阻塞调用将把唯一的事件循环线程彻底锁死,所有其他原本并发的协程都将被迫停摆。
解决方案:全面采用异步生态库(例如使用 httpx 或 aiohttp 替代 requests,使用 aiofiles 替代内置 open())。如果不得不调用现有的第三方同步阻塞函数,可以使用 Python 3.9+ 提供的 asyncio.to_thread() 将其安全卸载到独立的后台工作线程中,从而避免卡死事件循环:
# 示例 3:使用 asyncio.to_thread 隔离遗留同步阻塞调用
import asyncio
import time

def legacy_blocking_task(name: str) -> str:
    time.sleep(1.0)  # 遗留同步阻塞库
    return f"{name} 处理完成"

async def main():
    # 将同步阻塞操作委托给后台工作线程池,主事件循环保持顺畅
    result = await asyncio.to_thread(legacy_blocking_task, "离线报表")
    print(result)

if __name__ == "__main__":
asyncio.run(main())写出
for coro in coros: res = await coro 是极为普遍的误区。在循环中对每个协程直接 await 会导致当前协程必须等前一个协程完全执行完毕才进入下一轮循环,直接退化回串行阻塞。请务必使用 asyncio.gather() 或 asyncio.create_task() 批量启动任务后再做等待。
调用协程函数
do_work() 时若忘记加 await,控制台将输出 RuntimeWarning: coroutine 'do_work' was never awaited。这是因为未被 await 或注册为 Task 的协程对象只是一个未执行的容器,函数体内部代码根本不会被调用。
五、并发模型选型与适用场景决策矩阵
虽然 asyncio 性能卓越,但它并非适用于所有并发场景的灵丹妙药。Python 提供了同步模型、多线程(threading)、多进程(multiprocessing)以及异步协程(asyncio)四种主要形态。了解它们各自的优劣边界,才能做出正确的架构选型:
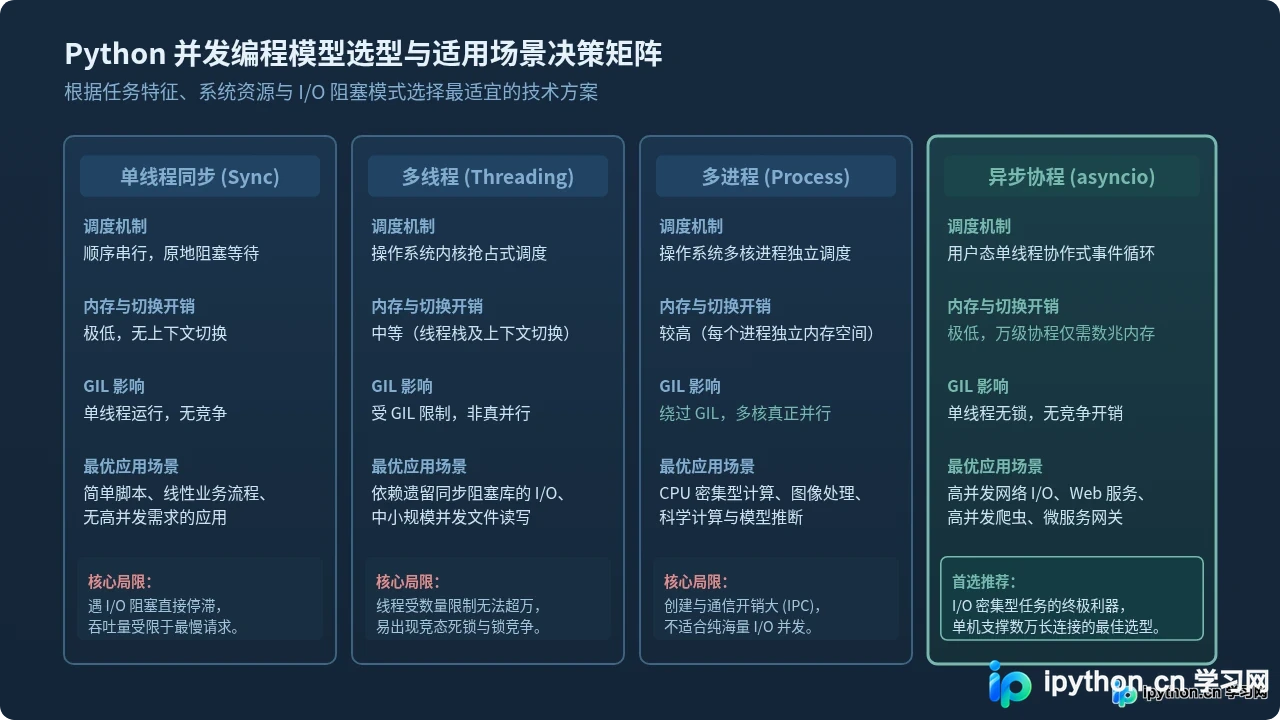
从同步代码向异步思维的转变,本质上是从主动掌控每一步的时间流逝,转变为定义协作规则并托付给事件循环管理。当你面对的是高并发网络连接、海量 API 数据抓取或即时 Web 通信时,asyncio 能够以极其轻量的系统开销带来成倍的吞吐量跃升;而只要牢记“不在协程内阻塞事件循环”这一核心原则,你便能真正发挥出现代 Python 异步并发的全部实力。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















