


Python嵌套循环的执行顺序与应用场景

在 Python 编程中,嵌套循环是指在一个循环结构内部包含另一个循环结构。掌握嵌套循环的关键在于理解其核心时序法则:外层循环每推进一次迭代,内层循环都必须从头至尾完整执行其所有的迭代轮次。无论是遍历多维数据表格、生成不同维度的排列组合,还是实现条件匹配检索,嵌套循环都扮演着底层控制流的基础角色。本文将直接拆解嵌套循环的执行顺序、提供单步时序跟踪推导,并结合典型工程场景与控制流避坑规则进行深入说明。
一、嵌套循环的核心执行机制与运行顺序
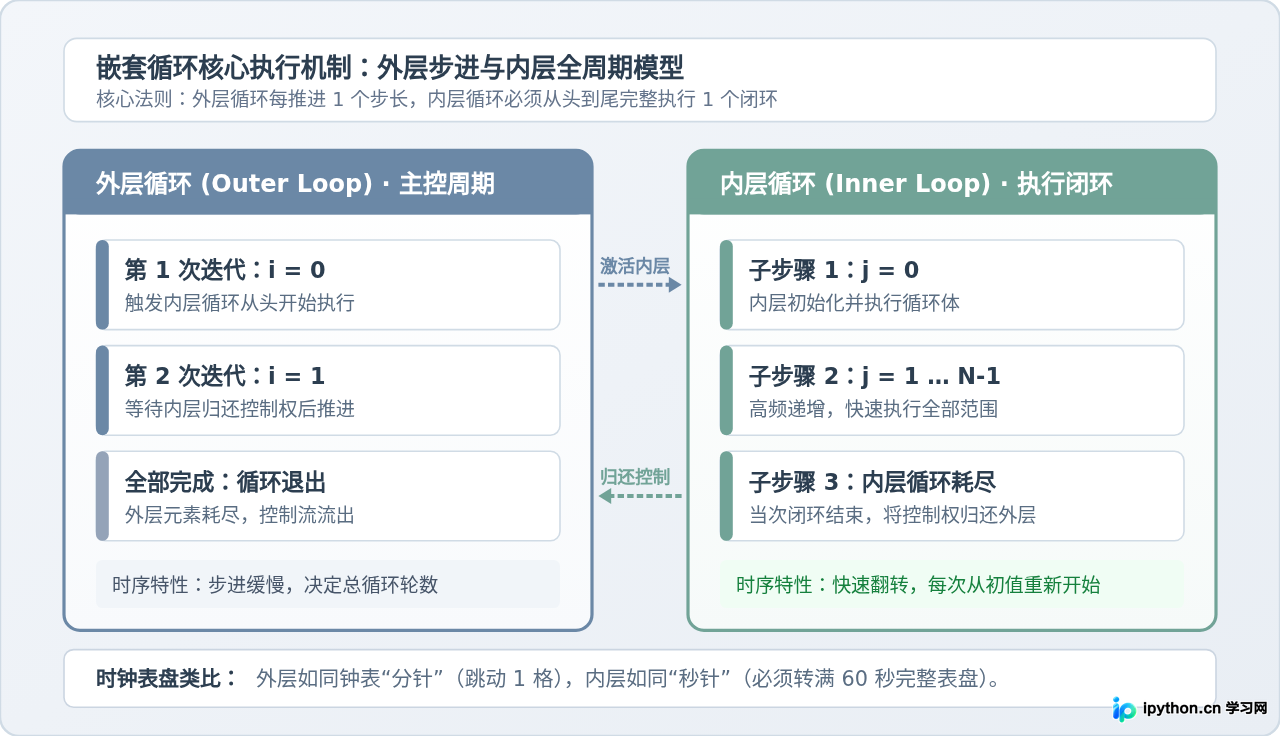
理解嵌套循环最直观的方式是“时钟表盘模型”:外层循环相当于时钟的分针,而内层循环相当于秒针。分针每向前走动一小格,秒针必须在表盘上完整转满六十秒的一整圈。类似地,在 Python 代码执行过程中,外层循环控制宏观的主轮次,每触发一次外层迭代,控制权便移交给内层循环;内层循环执行完毕并退出后,控制权才会归还给外层循环以推进下一步。
这种分层协作关系决定了嵌套循环的层次性与顺序性。外层循环变量在内层循环的整个生命周期中保持恒定不变,直到内层循环全部迭代结束,外层循环变量才会更新进入下一个值。
二、单步拆解:2×3 嵌套循环执行全流程
为了精确掌握变量在内存与控制流中的即时变化,我们通过一个基础的双重 for 循环进行单步执行推导。考虑以下标准代码片段:
# Python 3 嵌套循环单步跟踪示例
for i in range(2):
    for j in range(3):
        print(f"外层 i={i}, 内层 j={j}")
在该代码中,外层迭代范围是 range(2)(生成 0, 1),内层迭代范围是 range(3)(生成 0, 1, 2)。整个程序的具体执行步骤如下:
- 步骤 1:外层循环启动,取得首个元素
i = 0。控制流随即进入内层循环,内层初始化取得j = 0。循环体执行,输出(0, 0)。 - 步骤 2:外层
i仍为 0,内层推进至下一个元素j = 1。循环体执行,输出(0, 1)。 - 步骤 3:外层
i仍为 0,内层推进至末尾元素j = 2。循环体执行,输出(0, 2)。至此,内层可迭代对象已耗尽,内层循环退出,控制流交还外层。 - 步骤 4:外层循环推进至下一个元素
i = 1。控制流再次进入内层循环,内层完全重新初始化,取得j = 0。循环体执行,输出(1, 0)。 - 步骤 5:外层
i仍为 1,内层推进至j = 1。循环体执行,输出(1, 1)。 - 步骤 6:外层
i仍为 1,内层推进至末尾j = 2。循环体执行,输出(1, 2)。内层再次耗尽并退出。 - 退出:外层
range(2)也全部耗尽,循环整体结束。
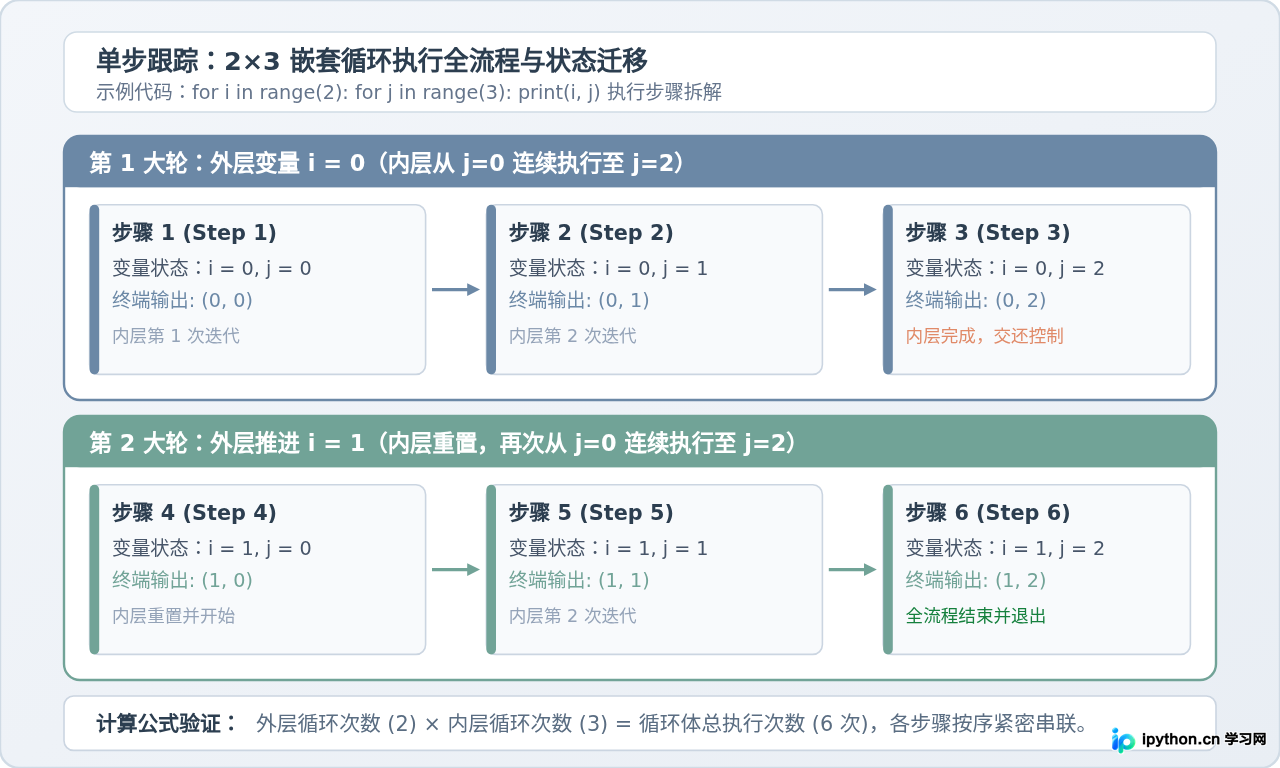
从以上推导可以看出,在没有 break 或 return 等提前干预语句的情况下,最内层循环体执行的总次数严格遵循乘法原理:总执行次数 = 外层迭代次数 × 内层迭代次数。若有三重嵌套,则为三者次数之积。
三、嵌套循环的三大经典应用场景
理解了执行顺序后,我们来看工程实践中嵌套循环的最常见应用场景。主要集中在三大类:二维/多维网格遍历、笛卡尔积组合生成以及双数据集的条件比对。
场景 1:二维结构(矩阵/表格/像素网格)的遍历与处理
在数据处理中,二维列表、电子表格、棋盘状态和数字图像通常采用行与列的矩阵结构。此时,外层循环遍历“行”,内层循环遍历“列”,通过 matrix[row][col] 精确定位并操作每个单元格。
# 二维列表的行与列遍历示例
matrix = [
    [10, 20, 30],
    [40, 50, 60]
]

for row_idx, row in enumerate(matrix):
    for col_idx, value in enumerate(row):
        print(f"坐标 [{row_idx}][{col_idx}] 的数值为: {value}")

# 示例输出:
# 坐标 [0][0] 的数值为: 10
# 坐标 [0][1] 的数值为: 20
# 坐标 [0][2] 的数值为: 30
# 坐标 [1][0] 的数值为: 40
# 坐标 [1][1] 的数值为: 50
# 坐标 [1][2] 的数值为: 60
场景 2:笛卡尔积组合与全排列配对
当需要将两个或多个独立集合中的所有元素进行两两配对时,嵌套循环是最自然的解决方案。例如电商系统中将不同“颜色”与不同“尺码”生成全量 SKU 组合:
# 电商商品 SKU 组合生成示例
colors = ["曜石黑", "冰川白"]
sizes = ["S", "M", "L"]

sku_list = []
for color in colors:
    for size in sizes:
        sku_list.append(f"{color}-{size}")

print("生成的全量 SKU 组合:", sku_list)
# 示例输出: ['曜石黑-S', '曜石黑-M', '曜石黑-L', '冰川白-S', '冰川白-M', '冰川白-L']
场景 3:双数据集的条件匹配与检索过滤
在未引入高级索引或数据库关联查询时,若要在两个数据集中找出满足某种特定关联条件的数据对(例如寻找共同好友、计算两两距离或求解特定数值和),常使用嵌套循环进行交叉扫描:
# 找出两个列表中数值相加等于目标值的配对
list_a = [1, 4, 7]
list_b = [3, 6, 9]
target_sum = 10

matched_pairs = []
for a in list_a:
    for b in list_b:
        if a + b == target_sum:
            matched_pairs.append((a, b))

print("满足条件的配对:", matched_pairs)
# 示例输出: [(1, 9), (4, 6), (7, 3)]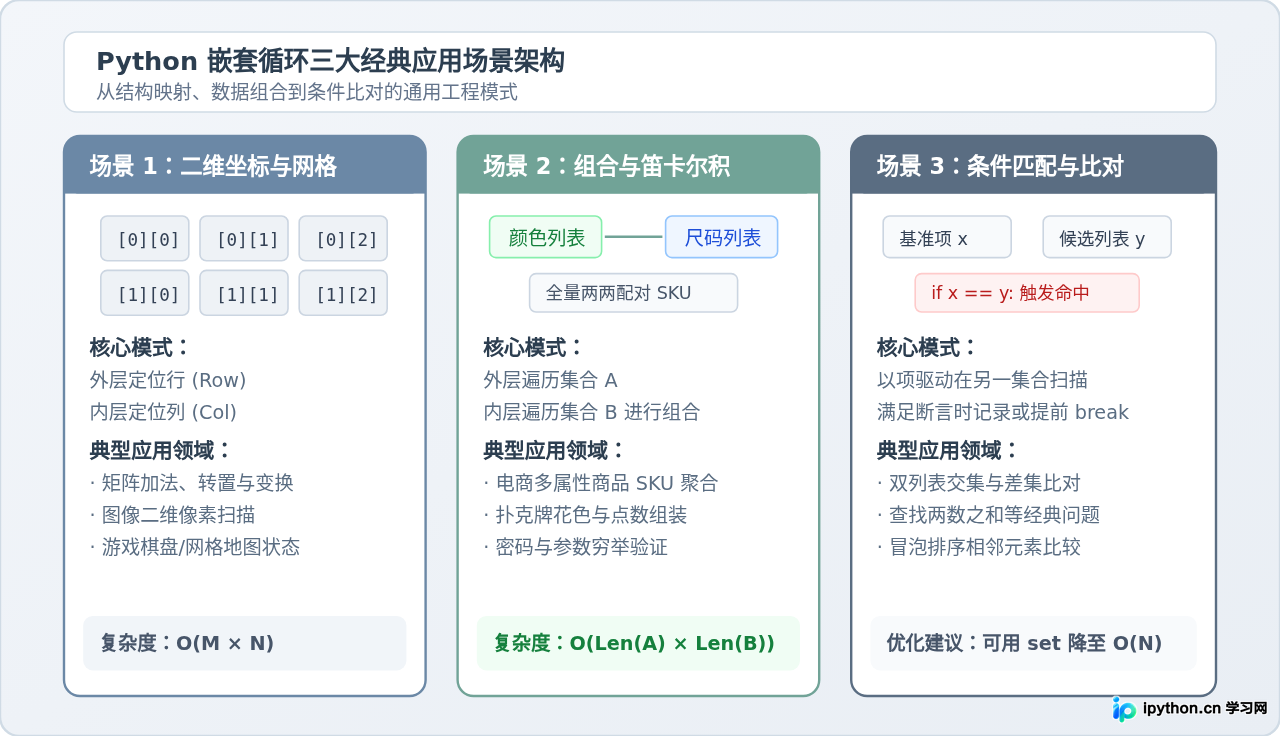
四、循环控制边界与常见陷阱防御
在编写嵌套循环时,控制语句(如 break、continue)的作用范围、循环变量的命名以及算法的时间复杂度是最容易出现缺陷的地方。以下逐一阐明对应的防范策略。
1. break 语句的单层作用域边界
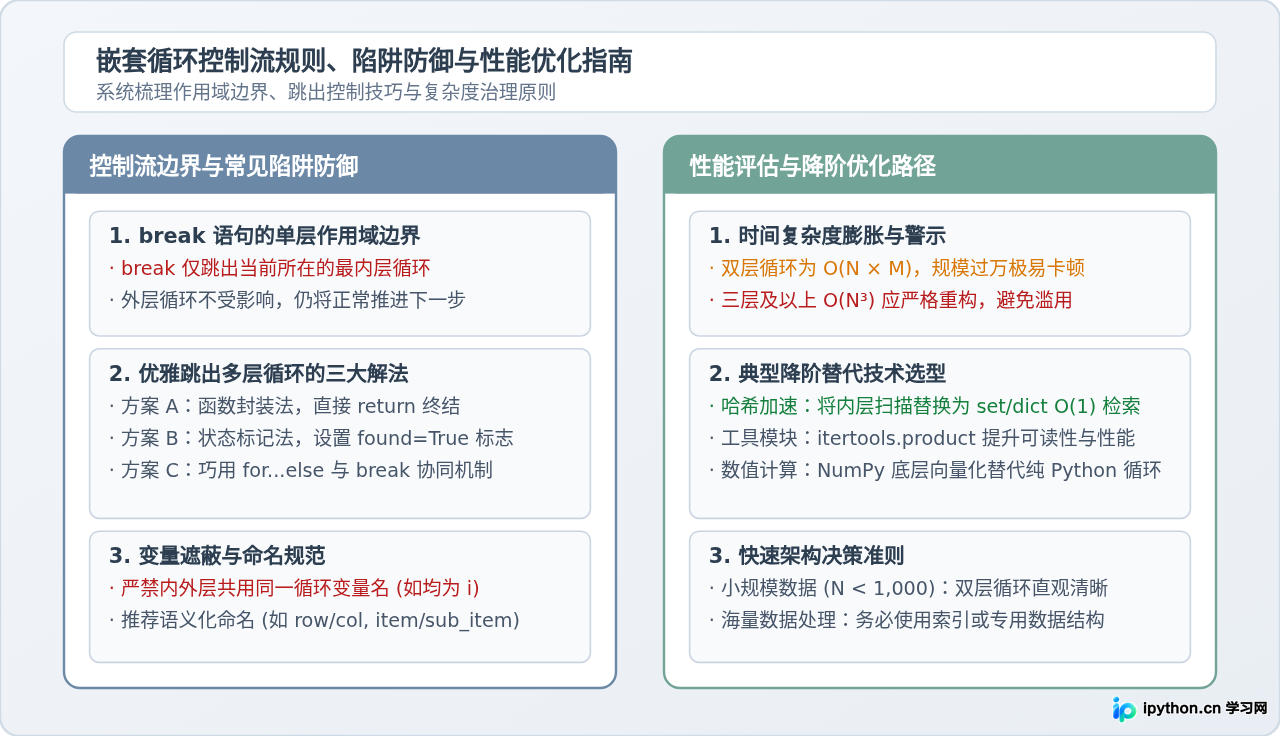
初学者极易产生一个误区:以为在内层循环中执行 break 能够跳出整个双重循环。事实上,Python 中的 break 仅对它所在的最内层循环起作用,外层循环丝毫不会被终止,而是继续递增进入下一轮。
# break 只跳出最内层循环的示例
for i in range(2):
    print(f"外层开始: i={i}")
    for j in range(5):
        if j == 2:
            print("  遇到条件,执行 break 跳出内层")
            break
        print(f"  内层 j={j}")
    print(f"外层结束: i={i}\n")

# 示例输出:
# 外层开始: i=0
#   内层 j=0
#   内层 j=1
#   遇到条件,执行 break 跳出内层
# 外层结束: i=0
#
# 外层开始: i=1
#   内层 j=0
#   内层 j=1
#   遇到条件,执行 break 跳出内层
# 外层结束: i=1如果需要在满足条件时彻底终结所有循环,通常有三种规范做法:
- 封装函数法(推荐):将嵌套循环包装在独立函数中,一旦命中目标直接
return,函数退出自然带走所有循环层。 - 标志位法(Flag):在外部定义布尔变量
found = False,内层break前将found = True,外层检测到该标志后也执行break。 - for...else 语法法:内层利用
break跳出并跳过自身的else,外层配合else级联触发跳出。
2. 循环变量命名遮蔽
在写多层循环时,必须避免内外层使用相同的变量名称。例如以下错误示范:
# 错误示范:内外层共用变量名 i
for i in range(3):
    for i in range(2):  # 覆盖了外层的 i
        print(i)
这种写法不仅会导致外层循环的逻辑受到干扰,而且破坏了代码的可读性。规范做法是使用具有明确几何或业务含义的命名,例如 row 与 col、category 与 item,或者在纯数学索引时规范使用 i 与 j。
3. 时间复杂度爆炸与降阶优化
双层嵌套循环的时间复杂度通常为 \(O(N \times M)\)。当 \(N\) 和 \(M\) 均为 1,000 时,计算量为一百万次,现代计算机可在毫秒内完成;但当数据规模达到 100,000 时,计算量骤增至 100 亿次,会导致程序明显卡死甚至超时崩溃。
特别是在“列表交叉查重”场景中,如果使用嵌套循环在包含 10 万条数据的列表 A 中逐个比对列表 B,时间复杂度为 \(O(N^2)\)。此时的优化手段是将内层可迭代对象转换为集合(set)或字典(dict):集合的哈希检索时间为 \(O(1)\),整体复杂度瞬间降为 \(O(N)\),执行时间可由数小时缩减至数十毫秒。
五、总结与速查清单
嵌套循环是构建多维逻辑不可或缺的语法工具。为了在编写代码时做到既清晰又高效,可参考下表总结的核心要点:
| 核心维度 | 运行特征 / 核心法则 | 工程建议与防错提示 |
|---|---|---|
| 执行顺序 | 外层每前进 1 步,内层完整跑完 1 轮 | 记住钟表分针与秒针机制,内层每次都重新开始 |
| 执行总频次 | 外层长度 × 内层长度 | 评估计算量时进行乘法估算,避免深层嵌套 |
| 二维结构处理 | 外层控制行索引,内层控制列索引 | 优先使用 matrix[row][col] 坐标思维 |
| 组合生成 | 多集合元素两两完全配对 | 复杂场景可使用 itertools.product 简化层级 |
| 跳出控制 | break 仅跳出当前所在最内层 |
需要完全跳出时,优先封装为函数使用 return |
| 性能边界 | 时间复杂度为 \(O(N \times M)\) | 大数据集匹配应将内层转为 set 或 dict 优化为 \(O(N)\) |
只要牢牢把握“外层定宏观步调、内层做微观全周期”的时序主线,合理命名变量并警惕大集合上的性能开销,就能在日常 Python 编程中准确、稳健地运用嵌套循环完成各种复杂的业务逻辑。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















