



在 Scala 集合操作里,分组和排序几乎是最常见的一类需求,尤其到了 Spark、Flink 这类数据处理代码中,写法是否清楚、返回值是否符合预期,会直接影响后续统计与转换逻辑。下面围绕 `groupBy`、`sorted`、`sortBy`、`sortWith` 四个方法逐一展开,既看它们各自解决什么问题,也通过示例代码说明什么时候该选哪一种写法。
Scala 集合函数式操作先看全貌
Scala 中不少常见函数式方法,都是围绕集合做转换或计算。通常可以分成两类:
- 转换操作(transformation):把一个集合变成另一个集合。
- 行动操作(actions,也常被叫作聚合操作):基于集合计算出某种结果值。
开发里常见的方法包括:
foreachmapflatmapfilterexistssorted、sortBy、sortWithgroupByreducefold
这篇重点只聚焦两组高频能力:一组是按规则拆分数据的 groupBy,另一组是按不同条件排序的 sorted、sortBy 和 sortWith。
groupBy 怎么用,适合解决什么问题
groupBy 的核心作用很直接:按照你提供的规则,把集合元素归入不同分组,并返回一个 Map。
可以把它理解成“先按某个键分类,再对每一类继续处理”。这也是它在统计类场景里特别常见的原因。
按字段分组的基本示例
下面这段代码把人员列表按性别分组。这里的每个元素都是一个二元组,_._2 表示取元组的第二个元素,也就是性别字段。
scala> val a = List("张三"->"男", "李四"->"女", "王五"->"男")
a: List[(String, String)] = List((张三,男), (李四,女), (王五,男))
// 按照性别分组
scala> a.groupBy(_._2)  //._2这是元组的取数方法,表示取元组的第二个元素
res0: scala.collection.immutable.Map[String,List[(String, String)]] = Map(男 -> List((
张三,男), (王五,男)),
女 -> List((李四,女)))
87
// 将分组后的映射转换为性别/人数元组列表
scala> res0.map(x => x._1 -> x._2.size)
res3: scala.collection.immutable.Map[String,Int] = Map(男 -> 2, 女 -> 1)
从结果可以看出,groupBy 返回的不是单个集合,而是一个按键组织好的映射结构。得到这个 Map 之后,再去做计数、筛选或进一步转换会更顺手。
理解 groupBy 的返回值
很多人第一次使用 groupBy 时,容易把注意力放在“怎么分”,却忽略了“分完以后拿到的是什么”。这一点其实非常关键。
- 键是你分组规则计算出来的结果。
- 值是落入该分组的全部元素集合。
- 因此它天然适合继续做数量统计、分组汇总和结构重组。
像上面的示例里,键是 男、女,值则分别对应各自的人员列表。继续调用 size,就能很快得到每组数量。
groupBy 和 partition 有什么区别
分组场景里,partition 也常被一起提到。两者都能按照条件拆分数据,但返回值完全不同,这也是选型时最该先看的地方。
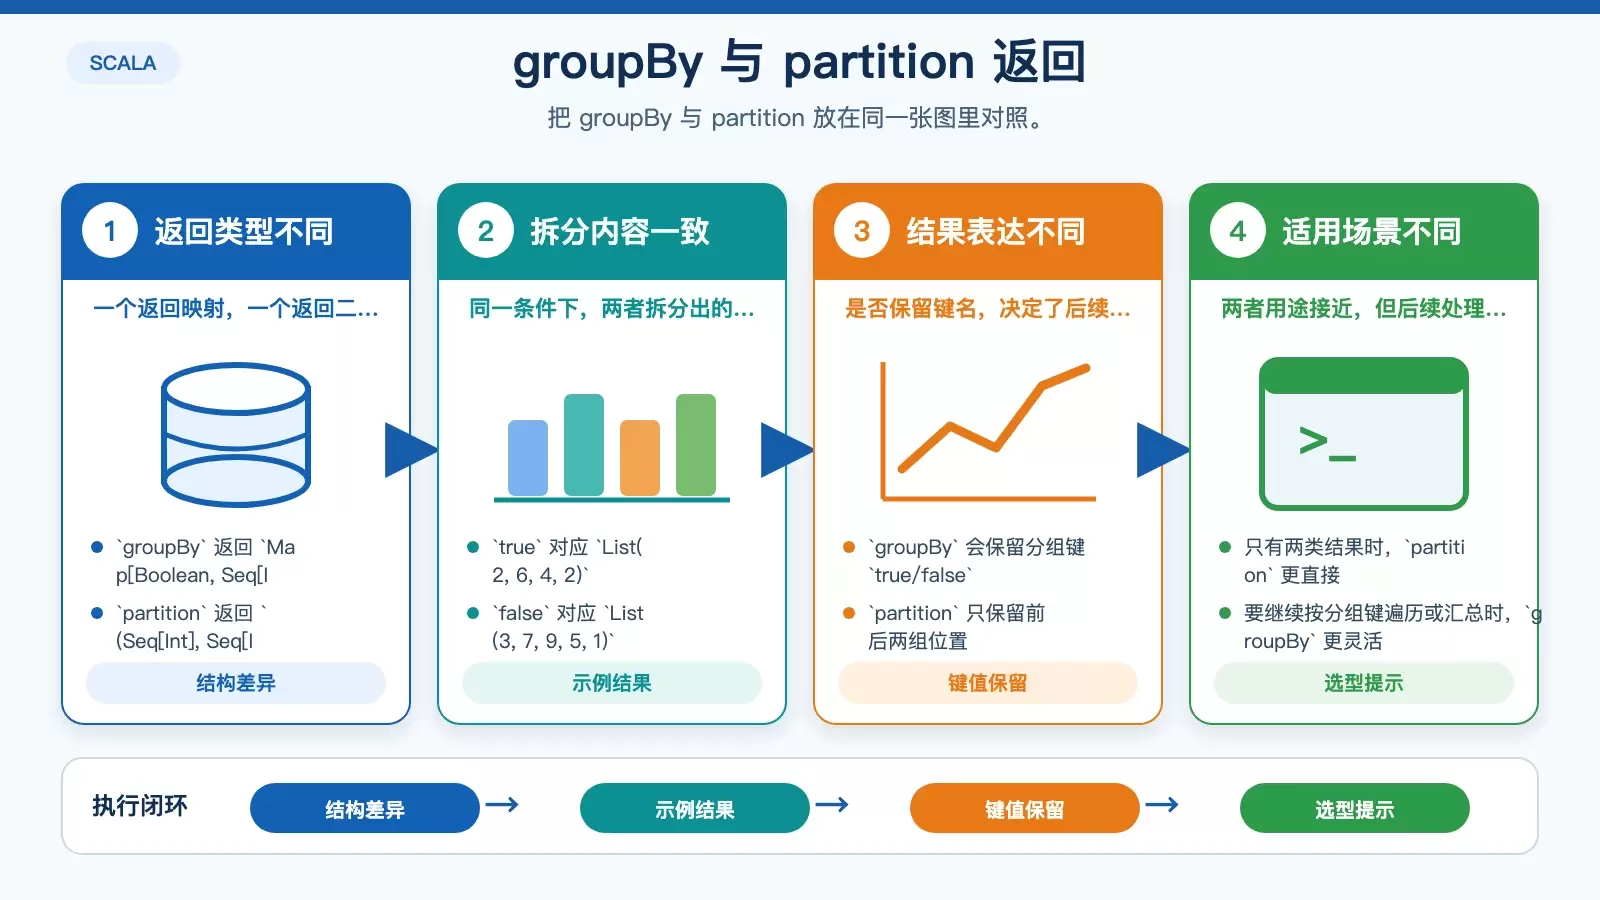
scala> val numbers = Seq(3, 7, 2, 9, 6, 5, 1, 4, 2)
numbers: Seq[Int] = List(3, 7, 2, 9, 6, 5, 1, 4, 2)

scala> numbers.partition(n => n % 2 == 0)
res32: (Seq[Int], Seq[Int]) = (List(2, 6, 4, 2),List(3, 7, 9, 5, 1))

scala> numbers.groupBy(n => n % 2 == 0)
res33: scala.collection.immutable.Map[Boolean,Seq[Int]] = Map(false -> List(3, 7, 9, 5, 1), true -> List(2, 6, 4, 2))
差异可以概括为:
partition只会把结果拆成两部分,返回一个二元组:满足条件的一组,不满足条件的一组。groupBy返回的是Map,更适合按多个分组键统一处理。
如果你的条件天然只有“是 / 否”两类,partition 会更直接;如果你后面还要围绕分组键做统计、遍历或映射,通常还是 groupBy 更灵活。
Scala 集合排序有哪三种常见方式
Scala 集合里,排序常见有三种写法:
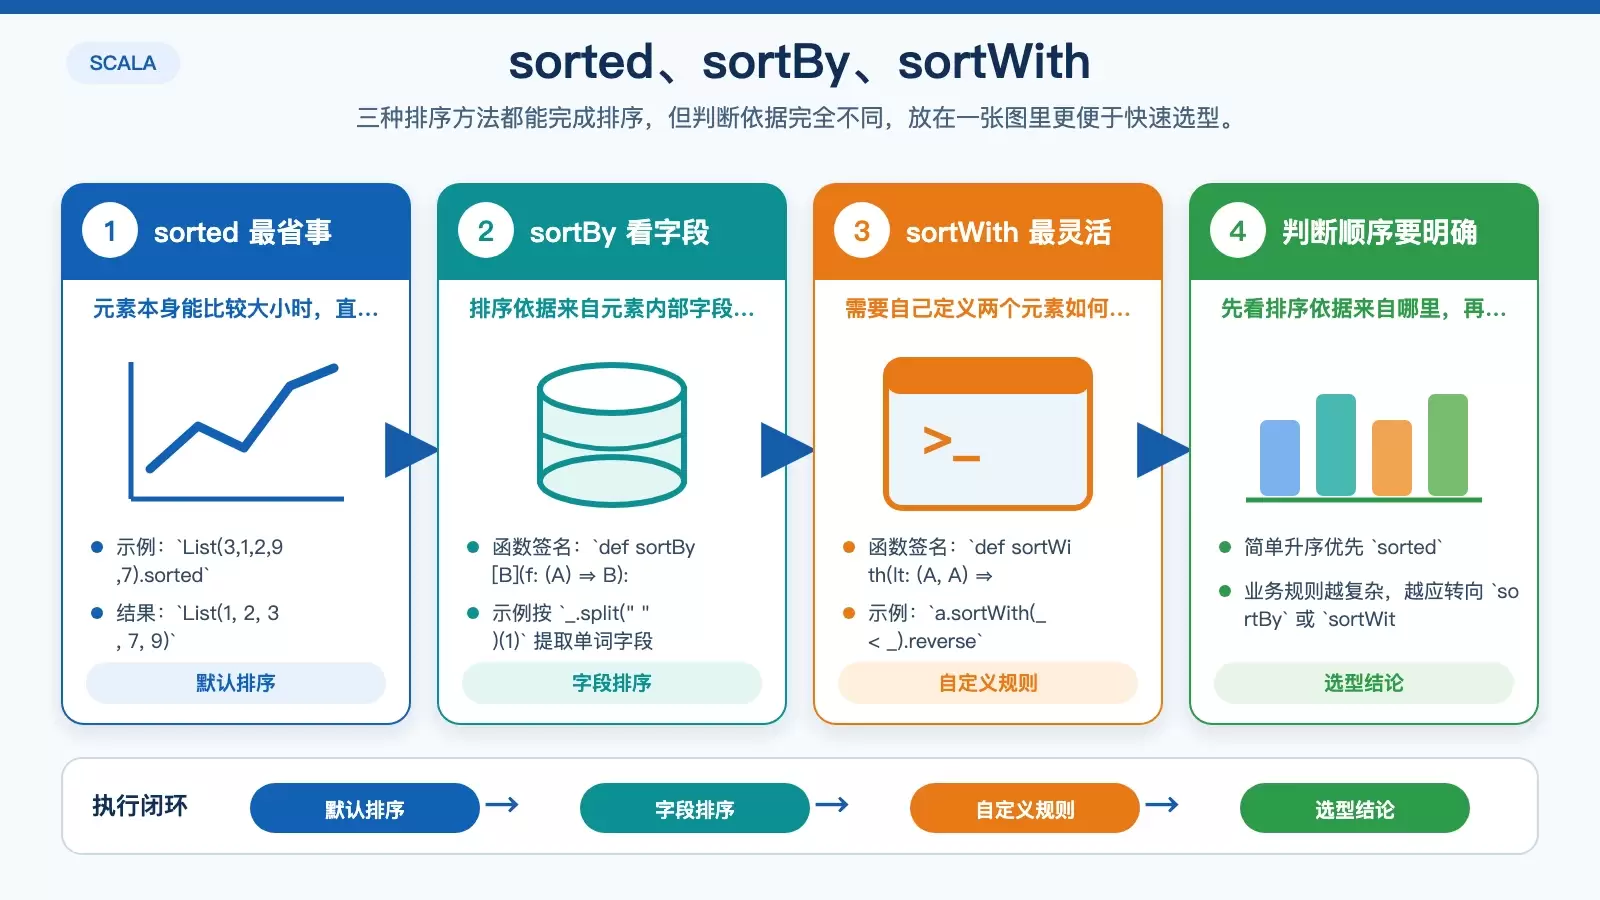
sorted:默认排序sortBy:按指定字段排序sortWith:按自定义比较规则排序
它们的差别,主要不在“能不能排”,而在“排序依据由谁提供”。
sorted:默认排序
sorted 适合元素本身就具备自然顺序的情况,比如数字、字符串等。调用方式最简洁,适合基础排序需求。
scala> List(3,1,2,9,7).sorted
res16: List[Int] = List(1, 2, 3, 7, 9)
这类写法的特点是省心,但前提也很明确:集合元素本身必须能直接比较大小。
sortBy:按字段或派生值排序
当集合元素不是简单数字,而是对象、元组、字符串记录这类复合结构时,sortBy 会更常用。它的思路是先从元素里取出一个用于比较的字段,再按照这个字段排序。
def sortBy[B](f: (A) ⇒ B): List[A]
例如下面这组字符串,每个元素前面带编号,后面是真正的单词内容。这里并不是按编号排序,而是取空格后的单词字段来排序。
scala> val a = List("01 hadoop", "02 flume", "03 hive", "04 spark")
a: List[String] = List(01 hadoop, 02 flume, 03 hive, 04 spark)
// 获取单词字段
scala> a.sortBy(_.split(" ")(1))
res8: List[String] = List(02 flume, 01 hadoop, 03 hive, 04 spark)
这个例子很典型:排序依据并不是元素本身,而是通过 _.split(" ")(1) 提取出来的第二段字符串。
sortWith:自定义比较规则
如果默认顺序不够用,按字段提取也无法准确表达业务规则,就需要用 sortWith 自己定义比较逻辑。它接收一个函数,函数返回 Boolean,用来决定两个元素前后顺序。
def sortWith(lt: (A, A) ⇒ Boolean): List[A]
先看基础写法:
//基础函数
scala> val a = List(2,3,1,6,4,5)
a: List[Int] = List(2, 3, 1, 6, 4, 5)

scala> a.sortWith((x,y) => if(x<y)true else false)
res15: List[Int] = List(1, 2, 3, 4, 5, 6)

scala> res15.reverse
res18: List[Int] = List(6, 5, 4, 3, 2, 1)

//简化函数
scala> val a = List(2,3,1,6,4,5)
a: List[Int] = List(2, 3, 1, 6, 4, 5)

// 函数参数只在函数中间出现一次,可以使用下划线代替
scala> a.sortWith(_ < _).reverse
res19: List[Int] = List(6, 5, 4, 3, 2, 1)
从这段代码可以看到,sortWith 的灵活性最高,但代价是你要自己把比较规则写清楚。对于复杂业务排序,它最合适;如果只是普通字段排序,通常还是优先考虑 sortBy,代码会更直观。
groupBy、sorted、sortBy、sortWith 怎么选
最后可以把这几个方法按使用场景快速归纳一下:
- 需要把集合按某个规则分类,并保留每组完整数据:用
groupBy。 - 只有两个分支,想直接拿到“满足条件 / 不满足条件”两组:用
partition。 - 元素本身支持自然顺序,需求只是简单升序:用
sorted。 - 排序依据是元素里的某个字段或派生值:用
sortBy。 - 排序逻辑比较特殊,需要自己定义元素比较关系:用
sortWith。
如果你正在写 Spark 或 Flink 里的 Scala 代码,这个判断顺序通常够用:先看是“分组”还是“排序”,再看排序依据是默认顺序、字段提取,还是完全自定义规则。把这一步想清楚,代码会短很多,后续维护也更省事。















