



Scala 入门后,很多人会碰到一类“看似零散、其实很典型”的练习:递归、面向对象建模、SQL 聚合,以及 Akka 并发通信。本文把几段示例按问题场景重新整理,保留原有命令、数字和代码事实,帮助你快速判断每段代码解决的是什么问题、关键逻辑在哪里,以及它们分别对应了哪些常见开发思路。
递归求解:100 元最多能喝多少瓶啤酒
题目条件怎么拆
题目条件很直接:每瓶啤酒 2 元,3 个空酒瓶或者 5 个瓶盖可以换 1 瓶啤酒,现有 100 元,且不允许借啤酒,问最多能喝多少瓶。
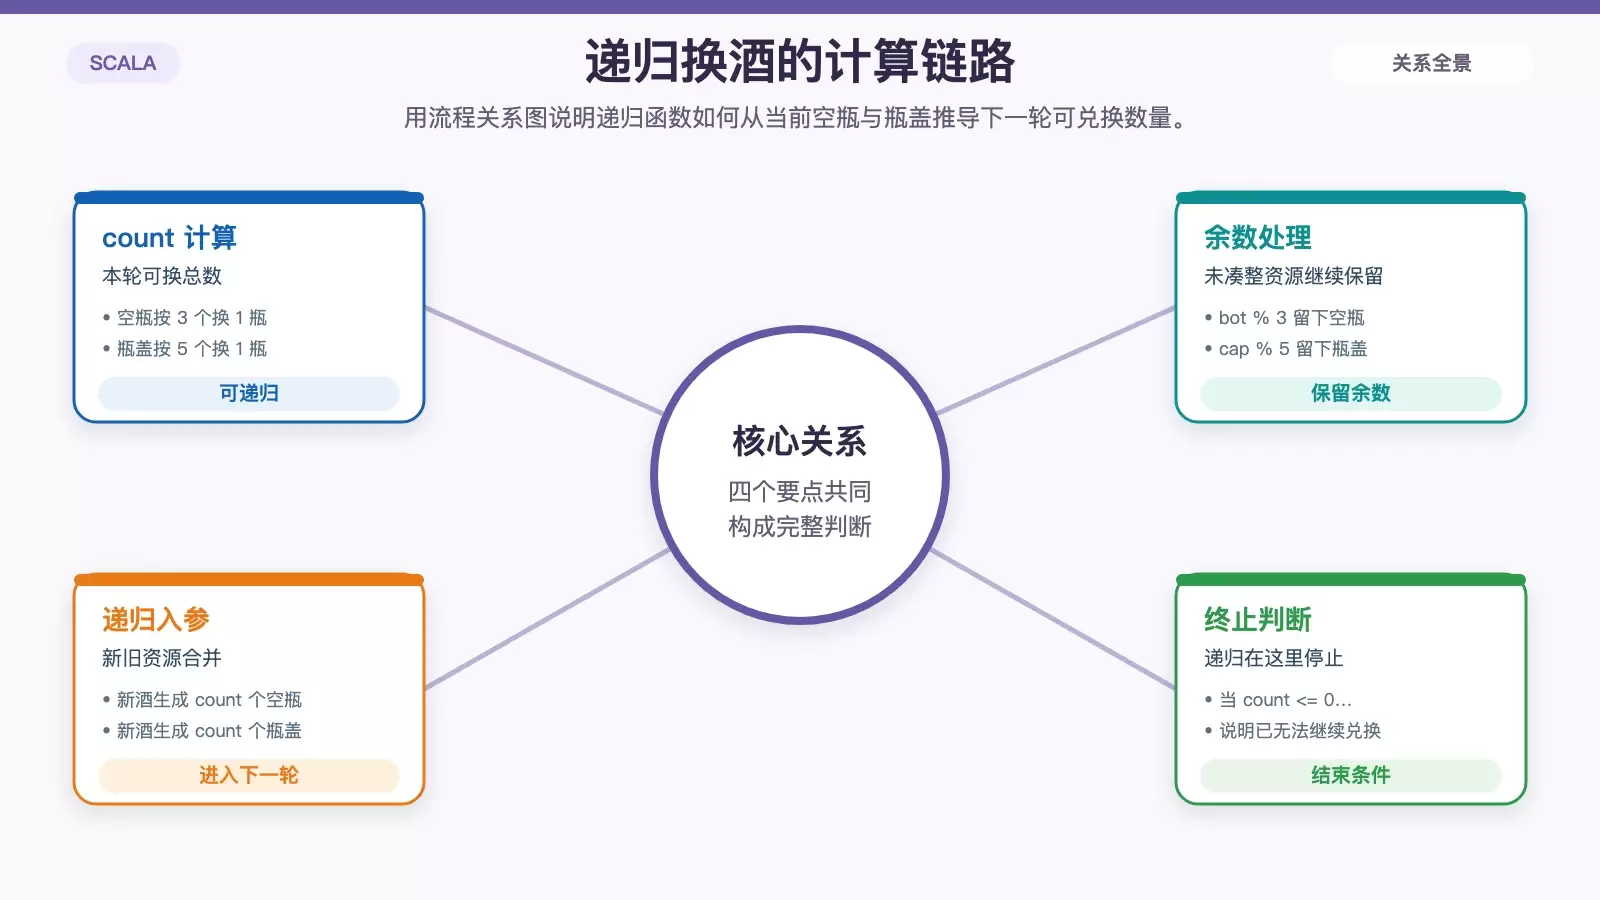
这类题的关键不在第一次购买,而在“换来的酒还会继续产生空瓶和瓶盖”。因此,比起手工一轮一轮推,递归更适合描述这个过程:
- 先一次性买完初始啤酒;
- 统计当前空瓶和瓶盖能再换多少瓶;
- 把新得到的酒继续折算成新的空瓶和瓶盖,直到再也换不出酒为止。
递归代码在做什么
  def extralPeer(bot: Int, cap: Int): Int = {
    val count = bot / 3 + cap / 5
    if (count <= 0)
      return 0

    val modBot = bot % 3
    val modCap = cap % 5
    count + extralPeer(count + modBot, count + modCap)
  }
这段函数可以直接理解为“当前资源还能换出多少瓶额外啤酒”:
bot / 3表示空瓶可兑换的数量;cap / 5表示瓶盖可兑换的数量;count是这一轮总共能换到的啤酒数;modBot和modCap分别保留本轮兑换后剩余的空瓶和瓶盖;- 下一轮递归时,新换到的
count瓶酒本身又会生成count个空瓶和count个瓶盖,所以传入的是count + modBot与count + modCap。
如果从题目原始条件出发,100 元先买 50 瓶,那么初始可用资源就是 50 个空瓶和 50 个瓶盖。实际使用时,只需要把这两个初始值传给递归函数,就能得到全部额外可换的啤酒数,再加上最初买到的 50 瓶即可。
这类写法的价值在于,它把“持续兑换直到不能再换”的终止条件写得很清楚:当 count <= 0 时,递归结束。
Scala 猜拳游戏:从需求到类设计
先明确交互规则
第二段内容是一个控制台猜拳小游戏,需求包括:
- 选取对战角色;
- 开始对战,用户出拳,与对手进行比较,提示胜负信息;
- 猜拳结束算分,平局都加一分,获胜加二分,失败不加分;
- 循环对战,当输入“n”时,终止对战,并显示对战结果;
- 游戏结束后显示得分。
这类练习的重点通常不是算法,而是把“玩家、电脑、游戏流程”拆成几个职责清晰的对象。
实现逻辑为什么这么分
原始设计思路包括几步:
- 创建用户类
User,定义属性name、score和方法showFist(); - 创建计算机类
Computer,同样定义name、score和showFist(); - 让计算机随机出拳;
- 创建游戏类
Game,保存甲方玩家、乙方玩家和对战次数; - 编写初始化方法和游戏开始方法。
这样划分的好处是,出拳动作、得分状态和游戏控制流程是分开的。后续如果要增加更多角色、调整计分规则,通常只需要改局部逻辑,而不用把所有输入输出混在一个大函数里。
代码获取方式
示例代码给出了仓库地址:
github.com/hulichao/bigdata-code/tree/master/src/main/scala/com/hoult/scala/job/game
原文这一节后附的代码块与前面的递归函数重复,真正值得看的其实是类设计和控制台循环对战流程。对初学者来说,这一题更适合拿来练习 Scala 基本类定义、方法封装和简单状态管理。
位置停留时长统计:这条 SQL 能解决什么问题
需求本质是连续记录合并吗
第三段是一个典型的数据处理题。已知字段包括用户 ID、位置 ID、开始时间和停留时长,样例数据如下:
UserA,LocationA,8,60 UserA,LocationA,9,60 UserB,LocationB,10,60 UserB,LocationB,11,80
其中,UserA 在 LocationA 从 8 点开始停留 60 分钟,等等。处理要求有两点:
- 对于同一个用户在同一个位置的连续多条记录进行合并;
- 开始时间取最早时间,停留时长累计求和。
从业务描述看,这道题想表达的是“按用户和位置聚合”,把同类记录汇成一条结果。
原始 SQL 实现
select user_id, location_id, min(start_time) as start_time, sum(stay_time) as stay_time from t1 group by user_id, location_id
这条 SQL 的逻辑非常直接:
- 用
group by user_id, location_id按用户和位置分组; - 用
min(start_time)取最早开始时间; - 用
sum(stay_time)累加停留时长。
需要注意的是,如果严格按“连续多条记录”理解,现实场景里往往还要补充时间是否相邻、是否允许中断后再次合并等判断条件;但就当前给出的样例和 SQL 来看,题目采用的是更简化的聚合口径,即同一用户在同一位置直接合并统计。
Akka Actor 间通信:两个 Actor 如何开始对话
启动流程的关键点
这一节开始进入 Akka 并发编程。目标很简单:编写两个 Actor,分别是 AActor 和 BActor,让它们可以互相发送消息。
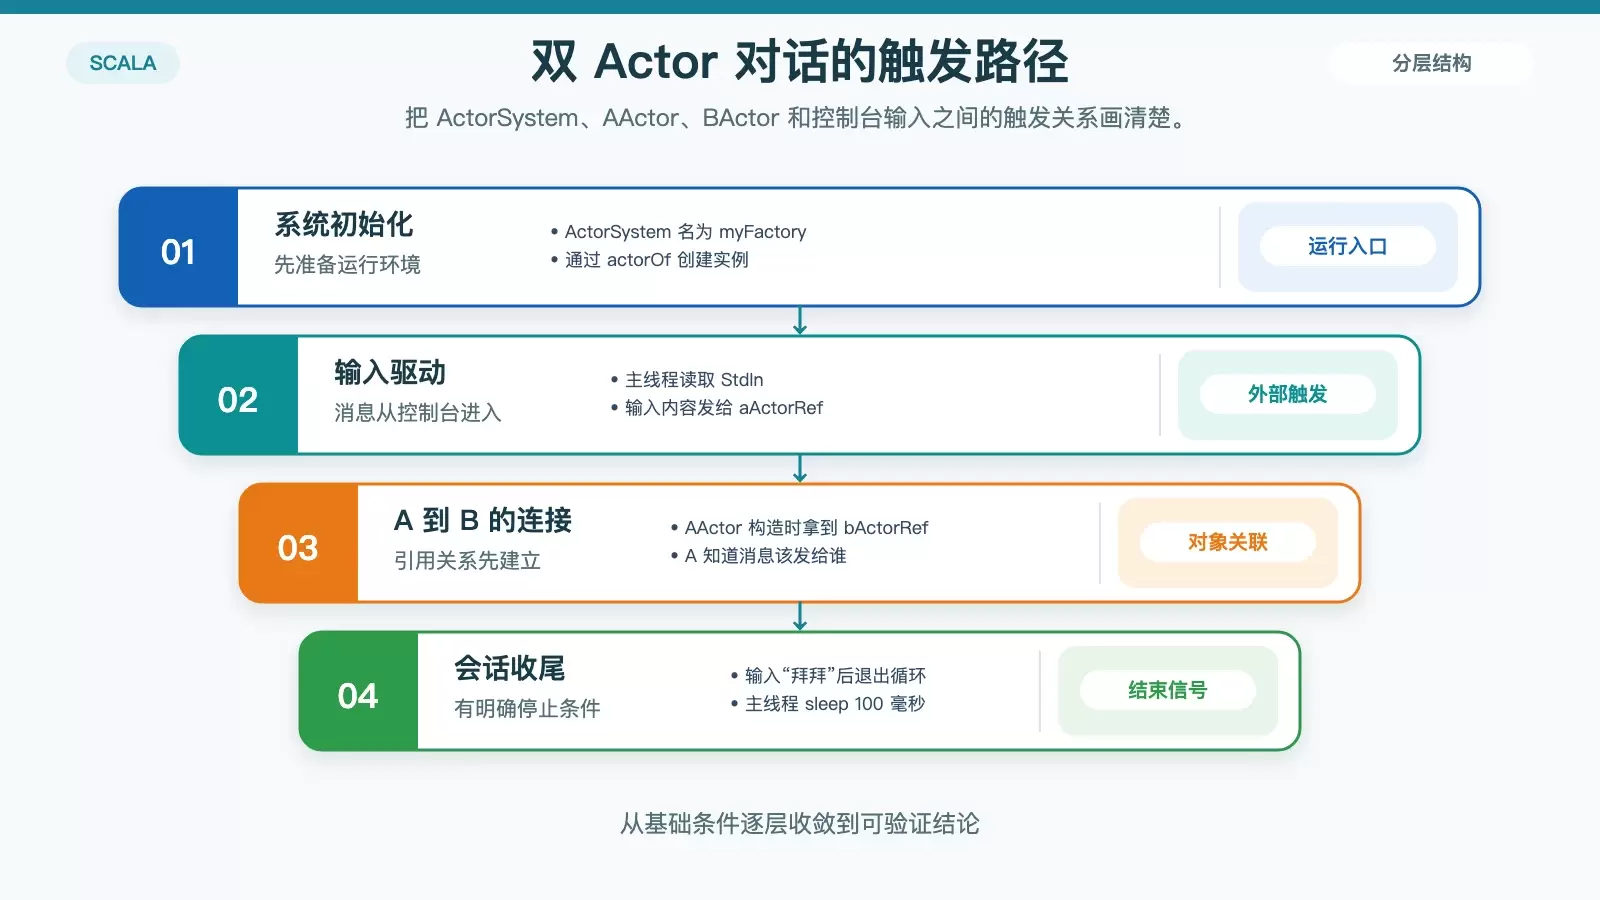
原始思路是先用一个 start 命令启动 AActor,再由它给自己发消息,触发后续 go 流程,然后由 A、B 两个 Actor 进入循环通信。
核心代码说明
代码地址如下:
github.com/hulichao/bigdata-code/tree/master/src/main/scala/com/hoult/scala/job/actor
object Demo {
  private val MyFactory = ActorSystem("myFactory")
  // 通过MyFactory.actorOf方法来创建一个actor;
  //只给A发消息,让他们两个Actor开始对话
  private val bActorRef = MyFactory.actorOf(Props[BActor], "bAcator")
  private val aActorRef = MyFactory.actorOf(Props(new AActor(bActorRef)), "aAcator")
  def main(args: Array[String]): Unit = {
    var flag = true
    while (flag) {
      val consoleLine: String = StdIn.readLine()
      //通过!来发送消息
      aActorRef ! consoleLine
      if (consoleLine.equals("拜拜")) {
        flag = false
        println("程序即将结束!")
      }
      // 休眠100毫秒
      Thread.sleep(100)
    }
  }
}
这段示例里有几个值得注意的点:
- 通过
ActorSystem("myFactory")创建 Actor 运行环境; - 使用
actorOf分别创建BActor和AActor; AActor构造时直接拿到bActorRef,因此它知道消息要发给谁;- 主线程通过
StdIn.readLine()接收控制台输入,并使用!把消息发给aActorRef; - 当输入为
"拜拜"时,结束循环并打印“程序即将结束!”。
如果把它当成 Akka 入门示例,可以把注意力放在两件事上:一是 Actor 之间只通过消息通信,二是对话是由外部消息触发的,而不是像普通方法调用那样直接互相执行函数。
模拟 Spark 风格的 Master/Worker 心跳机制
为什么这一节更接近真实分布式场景
最后一节是在 Actor 通信的基础上,进一步模拟 Spark 中 Master 与 Worker 的进程通信。目标是借助一个更完整的例子,理解主从服务中的心跳检测机制(HeartBeat)。
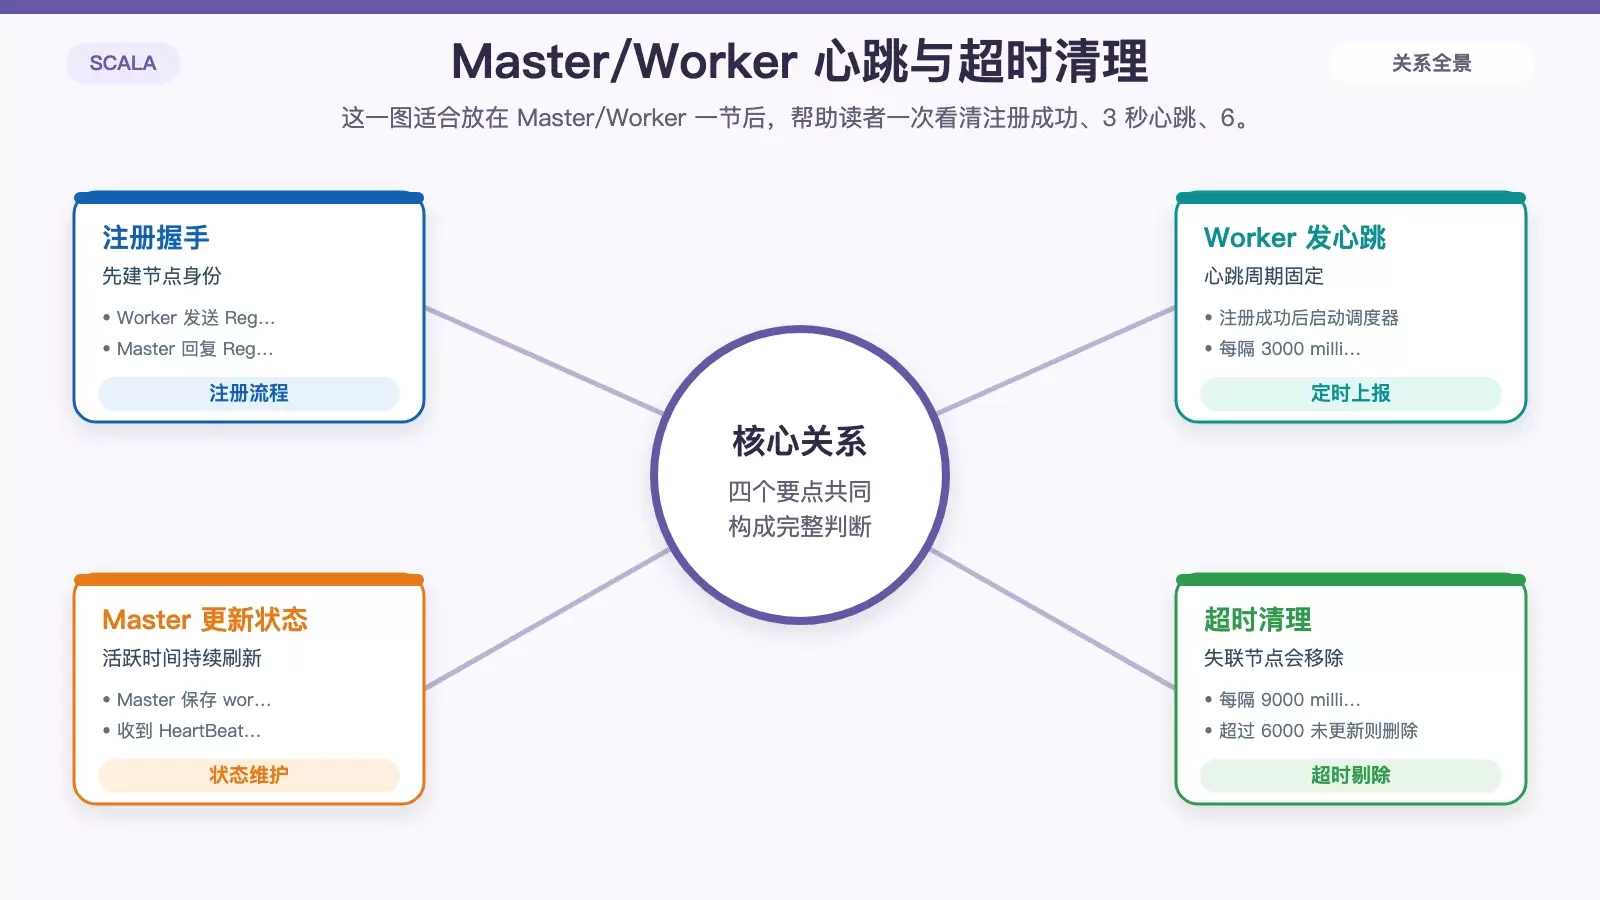
题目要求包含四部分:
- Worker 注册到 Master,Master 完成注册,并回复 Worker 注册成功;
- Worker 定时发送心跳,并在 Master 接收到;
- Master 接收到 Worker 心跳后,更新该 Worker 最近一次发送心跳的时间;
- 给 Master 启动定时任务,定时检测哪些 Worker 没有更新心跳,并将其从 hashmap 中删除。
消息协议和启动方式
这一节特别提到,Worker 和 Master 都通过发送 start 来启动,通信协议借助模板类实现,因此需要新增几个 case class 作为消息类型。实际编码时,关键就是先把“谁发什么消息、谁接什么消息”理顺,然后再写各自的处理逻辑。
代码地址为:
github.com/hulichao/bigdata-code/tree/master/src/main/scala/com/hoult/scala/job/actor
Master 端处理了哪些事
//master消息处理
val workers = mutable.Map[String, WorkerInfo]()
  override def receive: Receive = {
    case "start" => {
      println("master running....")
      // 检查超时worker
      self ! StartTimeOutWorker
    }

    case StartTimeOutWorker => {
      println("start check timeout worker...")
      // 定义定时器,每隔一段时间检查worker心跳是否超时
      import context.dispatcher
      context.system.scheduler.schedule(0 millis, 9000 millis, self, RemoveTimeOutWorker)
    }
    case RemoveTimeOutWorker => {
      // 获取workers中所有workerInfo
      val workerInfos = workers.values
      // 获取当前时间
      val currentTime = System.currentTimeMillis()
      // 找出超时6秒的worker
      workerInfos.filter(info => (currentTime - info.lastHeartBeatTime) > 6000)
        .foreach(workers -= _.id)
      println(s"===> workers.size = ${workers.size}")
    }

    case RegisterWorkerInfo(id, cpu, ram) => {
      //判断是否已注册
      if (!workers.contains(id)) {
        val info =
        // 添加数据
        workers += (id -> new WorkerInfo(id, cpu, ram)) //worker列表添加
        println("workers => 注册:" + workers)
        //注册成功回复消息
        sender() ! RegisteredWorkerInfo
      }

    }
    case HeartBeat(id) => {
      // 更新对应workinfo的心跳时间
      // 从workers中取出workerinfo
      val workerInfo = workers(id)
      // 更新最后心跳时间
      workerInfo.lastHeartBeatTime = System.currentTimeMillis()
      println(s"master updated worker ${id}'s heartbeat")
    }
Master 端实际上承担了三项职责:
- 维护一个
mutable.Map[String, WorkerInfo](),保存当前注册的 Worker; - 收到
RegisterWorkerInfo(id, cpu, ram)时完成注册,并回复RegisteredWorkerInfo; - 收到
HeartBeat(id)时更新对应 Worker 的最后心跳时间。
此外,它还会在收到 "start" 后触发超时检测流程,并通过调度器每隔 9000 millis 执行一次 RemoveTimeOutWorker。清理规则是:若当前时间与 lastHeartBeatTime 的差值大于 6000,就把该 Worker 从集合中移除。
Worker 端如何注册并持续发心跳
//worker消息处理
override def receive: Receive = {

    case "start" => {
      println("worker running...")
      // 发送注册信息
      masterProxy ! RegisterWorkerInfo(id, 16, 16 * 1024)
    }
    case RegisteredWorkerInfo => {
      println(s"worker ${id} registered!")

      // 定义定时器,每隔一段时间告诉自己发送心跳
      import context.dispatcher
      // 0 millis:立即执行
      // 3000 millis:每隔3秒执行
      // self:接收对象,发给自己
      // SendHeartBeat:发送内容
      context.system.scheduler.schedule(0 millis, 3000 millis, self, SendHeartBeat)
    }
    //发送心跳
    case SendHeartBeat => {
      println(s"worker ${id} send heartbeat to master")
      masterProxy ! HeartBeat(id)
    }
Worker 端的逻辑更清晰一些:
- 收到
"start"后,先向 Master 发送RegisterWorkerInfo(id, 16, 16 * 1024); - 收到
RegisteredWorkerInfo后,说明注册成功; - 随后启动定时任务,按
0 millis立即开始、每隔3000 millis给自己发送一次SendHeartBeat; - 真正处理
SendHeartBeat时,再把HeartBeat(id)发给 Master。
这是一种很典型的 Actor 写法:让定时器给自己发消息,再在 receive 里统一处理,从而保持消息驱动模型的一致性。
这个例子适合拿来理解什么
如果把整套流程连起来看,它已经具备了一个简化版主从系统的关键行为:
- Master 启动后准备接收注册,并开启超时检测;
- Worker 启动后主动注册;
- 注册成功后,Worker 周期性上报心跳;
- Master 根据最近心跳时间判断节点是否存活;
- 超过阈值的 Worker 会被剔除。
对于刚接触 Akka 或分布式调度机制的读者,这一节比简单的双 Actor 对话更有参考价值,因为它把注册、状态维护、定时调度和超时清理这几类常见模式放到了同一个样例里。















