



磁盘空间莫名其妙被吃掉、项目目录越用越大,很多时候并不是程序本身出了问题,而是重复文件在不断堆积。相比手动翻目录,Python 更适合做这类清理工作:既能按内容识别重名或异名重复文件,也能逐步加入过滤、预览、交互删除和性能优化。下面按“为什么要清、脚本怎么做、实际使用怎么避坑”的顺序展开,便于你判断这套方案适不适合自己的环境。
为什么要清理重复文件
重复文件往往不是一次性产生的,而是在日常使用中慢慢堆出来的。最常见的情况包括:同一文件被多次下载到不同目录、软件自动生成备份、浏览器和编辑器留下缓存、开发时直接复制项目目录,以及云同步工具在多设备间同步时产生冗余副本。
手动删除的最大问题不只是慢,还不够准。你可以靠文件名找到一部分重复项,但很难识别“文件名不同、内容却完全相同”的情况;遇到隐藏目录、系统目录或权限限制时,也容易漏掉关键位置。更现实的风险是误删,尤其是当多个副本分散在不同盘符和项目目录时,单靠肉眼几乎无法稳定判断该留哪一个。
Python 方案的核心原理
用哈希值判断内容是否重复
判断两个文件是否重复,最可靠的方式是比较内容。直接逐字节比较当然可行,但文件一多,效率会很差,因此更常见的做法是先为文件计算哈希值。这里使用的是 MD5:它可以把文件内容映射成一段固定长度的“指纹”,只要内容相同,哈希值就一致。
import hashlib

def get_file_hash(file_path, block_size=65536):
    """计算文件的MD5哈希值"""
    hasher = hashlib.md5()
    try:
        with open(file_path, 'rb') as f:
            buf = f.read(block_size)
            while len(buf) > 0:
                hasher.update(buf)
                buf = f.read(block_size)
        return hasher.hexdigest()
    except (PermissionError, FileNotFoundError, OSError):
        return None
先按文件大小分组,再做精确比对
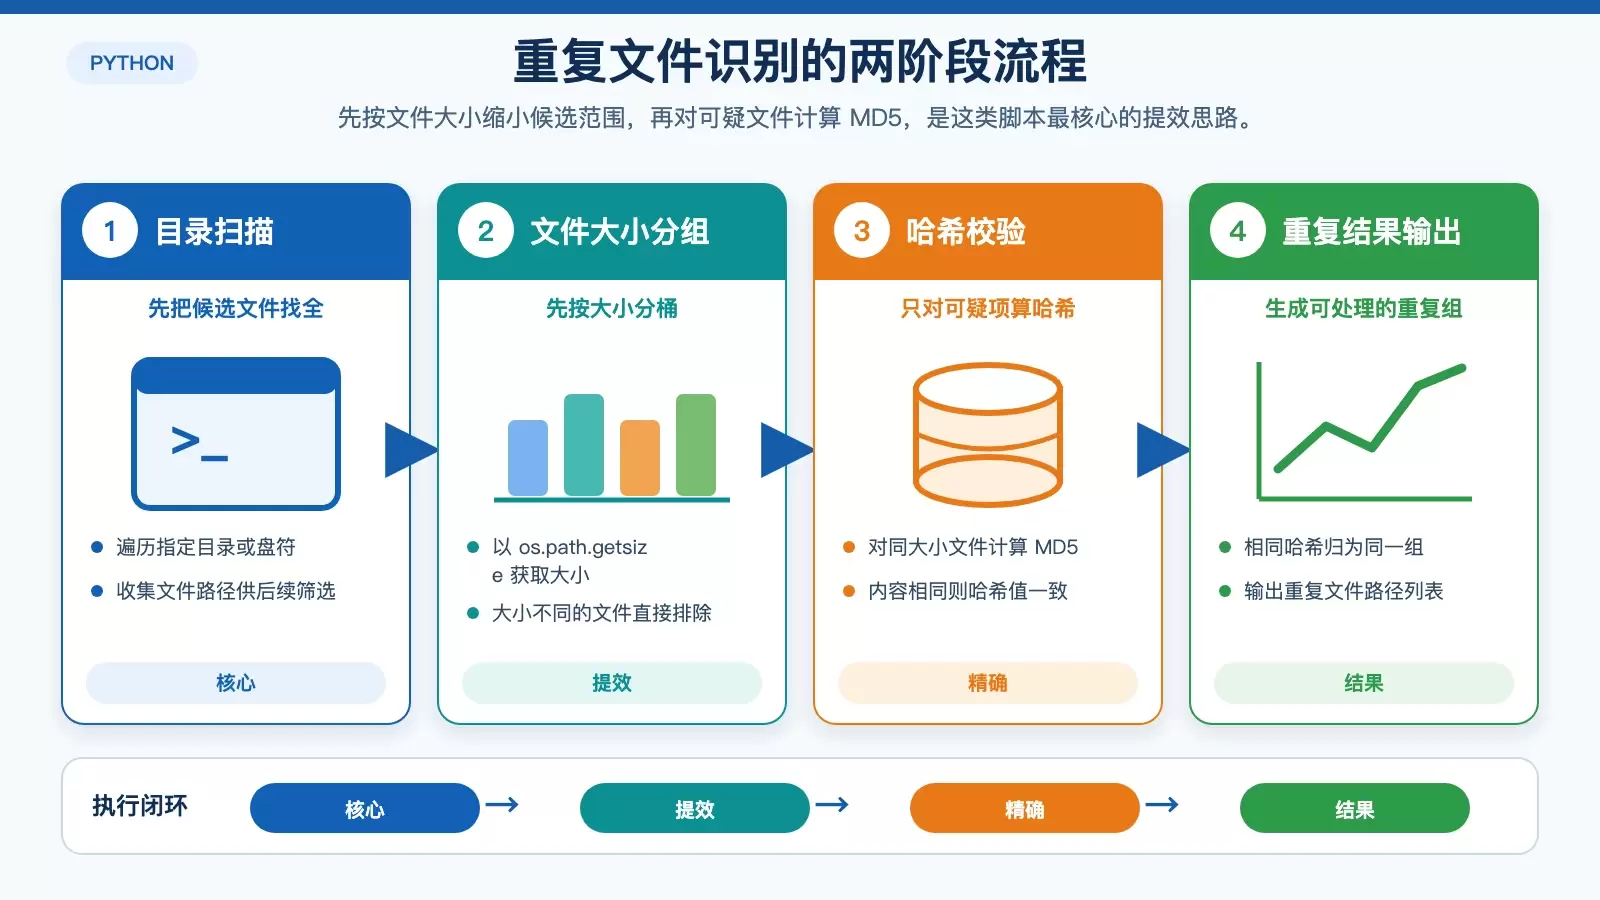
如果对所有文件直接算 MD5,扫描范围一大,时间成本会明显上升。一个更实用的思路是先按文件大小分组,因为大小不同的文件不可能完全重复。这样只有那些“大小相同”的候选文件,才需要进入下一步哈希计算。
这个两阶段策略很适合磁盘清理场景:先用低成本筛出候选,再用 MD5 做精确确认,能显著减少不必要的哈希运算。
from collections import defaultdict
import os

size_dict = defaultdict(list)
for root, _, files in os.walk(directory):
    for filename in files:
        file_path = os.path.join(root, filename)
        try:
            file_size = os.path.getsize(file_path)
            size_dict[file_size].append(file_path)
        except (OSError, PermissionError):
            continue
完整脚本怎么组织
扫描文件并输出重复分组
把前面的两个步骤串起来,就可以得到一个可用的重复文件扫描器。这个版本支持多盘符扫描,并通过 min_size 参数忽略过小文件,减少低价值扫描。
import argparse
import time
from collections import defaultdict

def find_duplicate_files(drives, min_size=0):
    """查找重复文件"""
    print("开始扫描磁盘中的文件...")
    size_dict = defaultdict(list)
    total_files = 0

    for drive in drives:
        for root, _, files in os.walk(drive):
            for filename in files:
                file_path = os.path.join(root, filename)
                try:
                    file_size = os.path.getsize(file_path)
                    if file_size >= min_size:  # 忽略小于指定大小的文件
                        size_dict[file_size].append(file_path)
                        total_files += 1
                        if total_files % 1000 == 0:
                            print(f"已扫描 {total_files} 个文件...")
                except (OSError, PermissionError):
                    continue

    print(f"文件扫描完成,共扫描 {total_files} 个文件。")
    print("开始计算文件哈希值以查找重复...")

    hash_dict = defaultdict(list)
    for size, file_list in size_dict.items():
        if len(file_list) > 1:
            for file_path in file_list:
                file_hash = get_file_hash(file_path)
                if file_hash:
                    hash_dict[file_hash].append(file_path)

    duplicates = {h: p for h, p in hash_dict.items() if len(p) > 1}
    return duplicates
返回结果里,键是哈希值,值是对应的重复文件路径列表。这样做的好处是,后续无论是输出报告、交互式处理,还是接入图形界面,数据结构都比较直接。
加入交互式删除,避免误删
扫描出重复项不等于应该立刻全删。更稳妥的做法,是把每组重复文件列出来,让用户决定保留哪一个,其余再删除。这样尤其适合文档、项目文件和手工整理过的素材目录。
def interactive_delete(duplicates):
    """交互式删除重复文件"""
    for hash_val, file_paths in duplicates.items():
        print(f"n发现 {len(file_paths)} 个重复文件 (MD5: {hash_val}):")
        for i, path in enumerate(file_paths, 1):
            print(f"{i}. {path}")

        keep = input("请输入要保留的文件编号(多个用逗号分隔,默认保留第一个):")
        if not keep:
            keep = "1"

        keep_indices = [int(x.strip()) - 1 for x in keep.split(",")]
        for i in range(len(file_paths)):
            if i not in keep_indices:
                try:
                    os.remove(file_paths[i])
                    print(f"已删除: {file_paths[i]}")
                except Exception as e:
                    print(f"删除失败 {file_paths[i]}: {str(e)}")
除了交互删除,原始方案还可以继续补强,例如只检查某些文件类型、设置更细的进度提示,或者把默认最小文件大小设为 1MB,优先处理更占空间的重复项。
性能优化与安全边界
大量文件场景下的多线程加速
当候选文件很多时,真正耗时的通常不是遍历目录,而是读取文件并计算哈希。这里可以借助 ThreadPoolExecutor 并发处理候选文件列表,提高大磁盘扫描速度。
from concurrent.futures import ThreadPoolExecutor

def calculate_hashes(file_list):
    """多线程计算文件哈希"""
    with ThreadPoolExecutor() as executor:
        results = list(executor.map(get_file_hash, file_list))
    return results

# 在find_duplicate_files中替换单线程哈希计算
hashes = calculate_hashes(file_list)
保留最新文件,并排除关键目录
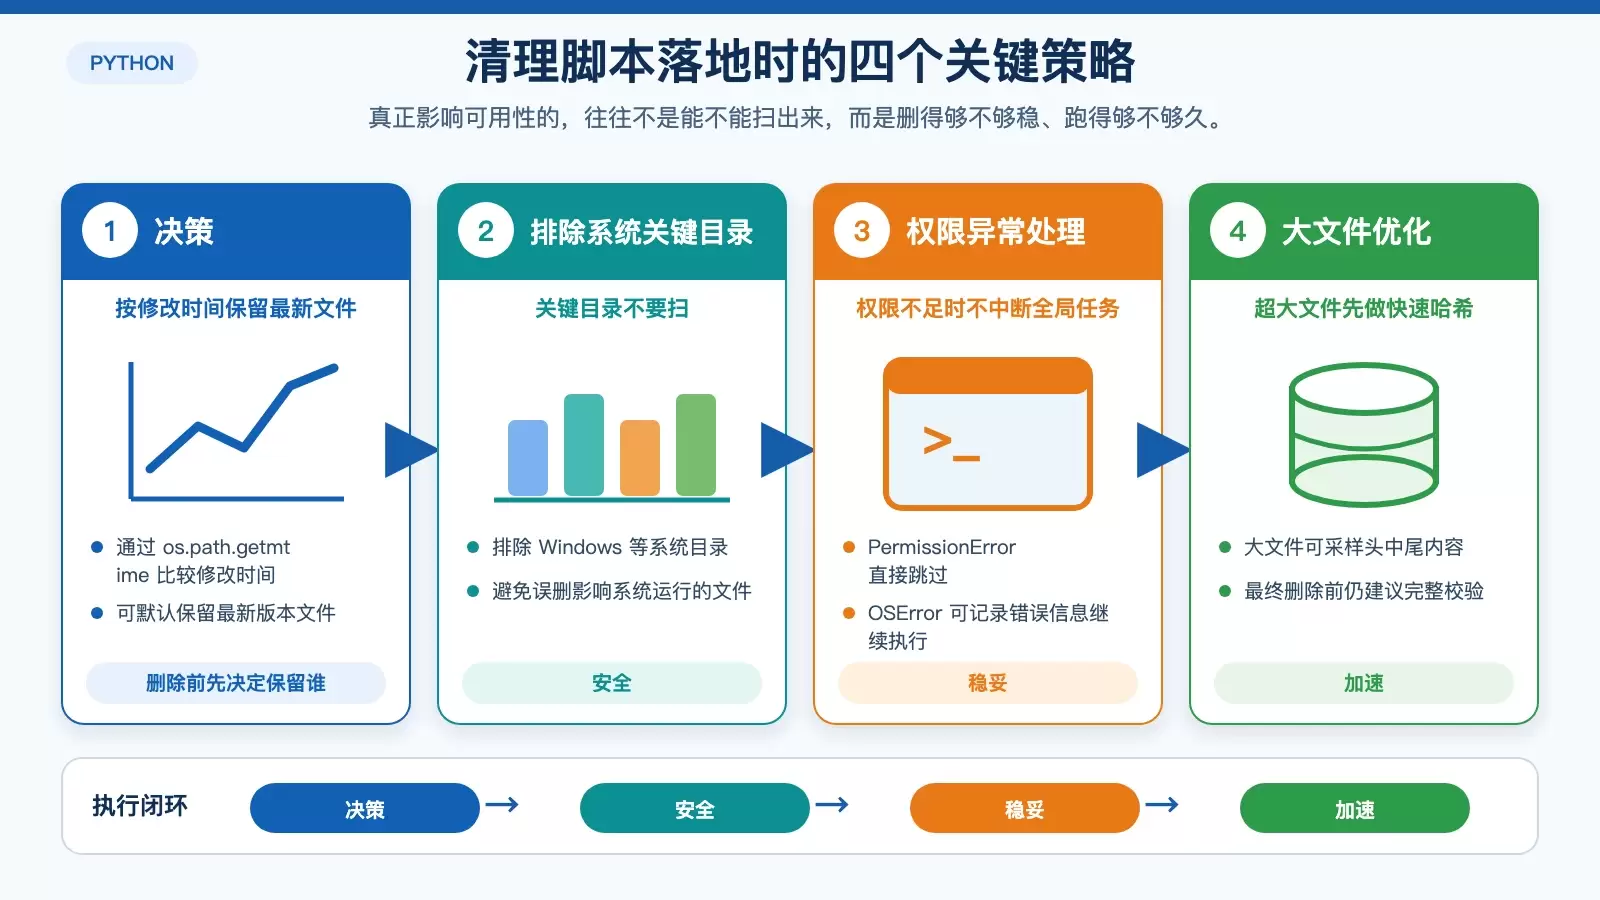
重复文件里到底保留哪一个,很多时候并不只是“留第一个”。如果你更在意版本新旧,可以结合文件修改时间,默认保留最新文件。
def get_file_mtime(file_path):
    """获取文件修改时间"""
    return os.path.getmtime(file_path)

# 在交互式删除时,可以默认保留最新文件
latest_index = max(range(len(file_paths)), key=lambda i: get_file_mtime(file_paths[i]))
同时,系统目录通常不适合纳入清理范围,尤其是在 Windows 环境下。把关键目录排除掉,可以大幅降低误删风险。
EXCLUDE_DIRS = {
    "Windows",
    "Program Files",
    "Program Files (x86)",
    "System Volume Information",
    "$RECYCLE.BIN"
}

def should_exclude(path):
    """检查路径是否应该排除"""
    return any(exclude_dir in path for exclude_dir in EXCLUDE_DIRS)
权限、大文件与进度恢复要单独处理
实际跑脚本时,最常见的中断点是权限不足和大文件处理过慢。权限问题的处理方式很明确:跳过无权访问的文件,必要时记录错误信息,避免整轮扫描直接失败。
try:
    file_size = os.path.getsize(file_path)
except PermissionError:
    continue  # 跳过无权限访问的文件
except OSError as e:
    print(f"访问文件出错 {file_path}: {str(e)}")
    continue
对于视频、镜像包这类超大文件,完整读取后计算哈希会很慢。文中的优化方法是采样文件开头、中间和末尾各一段内容,用更低成本生成一个“快速哈希”。这适合先做候选筛选,但如果要执行真正删除,仍建议对最终候选再做完整校验。
def get_fast_hash(file_path, sample_size=1024*1024):
    """快速哈希计算,只采样文件部分内容"""
    file_size = os.path.getsize(file_path)
    if file_size < sample_size * 3:
        return get_file_hash(file_path)  # 小文件使用完整哈希

    hasher = hashlib.md5()
    try:
        with open(file_path, 'rb') as f:
            # 采样文件开头
            hasher.update(f.read(sample_size))
            # 采样文件中间
            f.seek(file_size // 2)
            hasher.update(f.read(sample_size))
            # 采样文件末尾
            f.seek(-sample_size, 2)
            hasher.update(f.read(sample_size))
        return hasher.hexdigest()
    except Exception:
        return None
如果扫描范围很大,或者清理流程可能被打断,还可以把进度写入本地 JSON 文件。这样中断后至少能恢复状态,而不是从头再来。
import json

def sa ve_progress(progress, file_path="progress.json"):
    """保存扫描进度"""
    with open(file_path, 'w') as f:
        json.dump(progress, f)

def load_progress(file_path="progress.json"):
    """加载扫描进度"""
    try:
        with open(file_path) as f:
            return json.load(f)
    except FileNotFoundError:
        return None
给非技术用户加一个图形界面
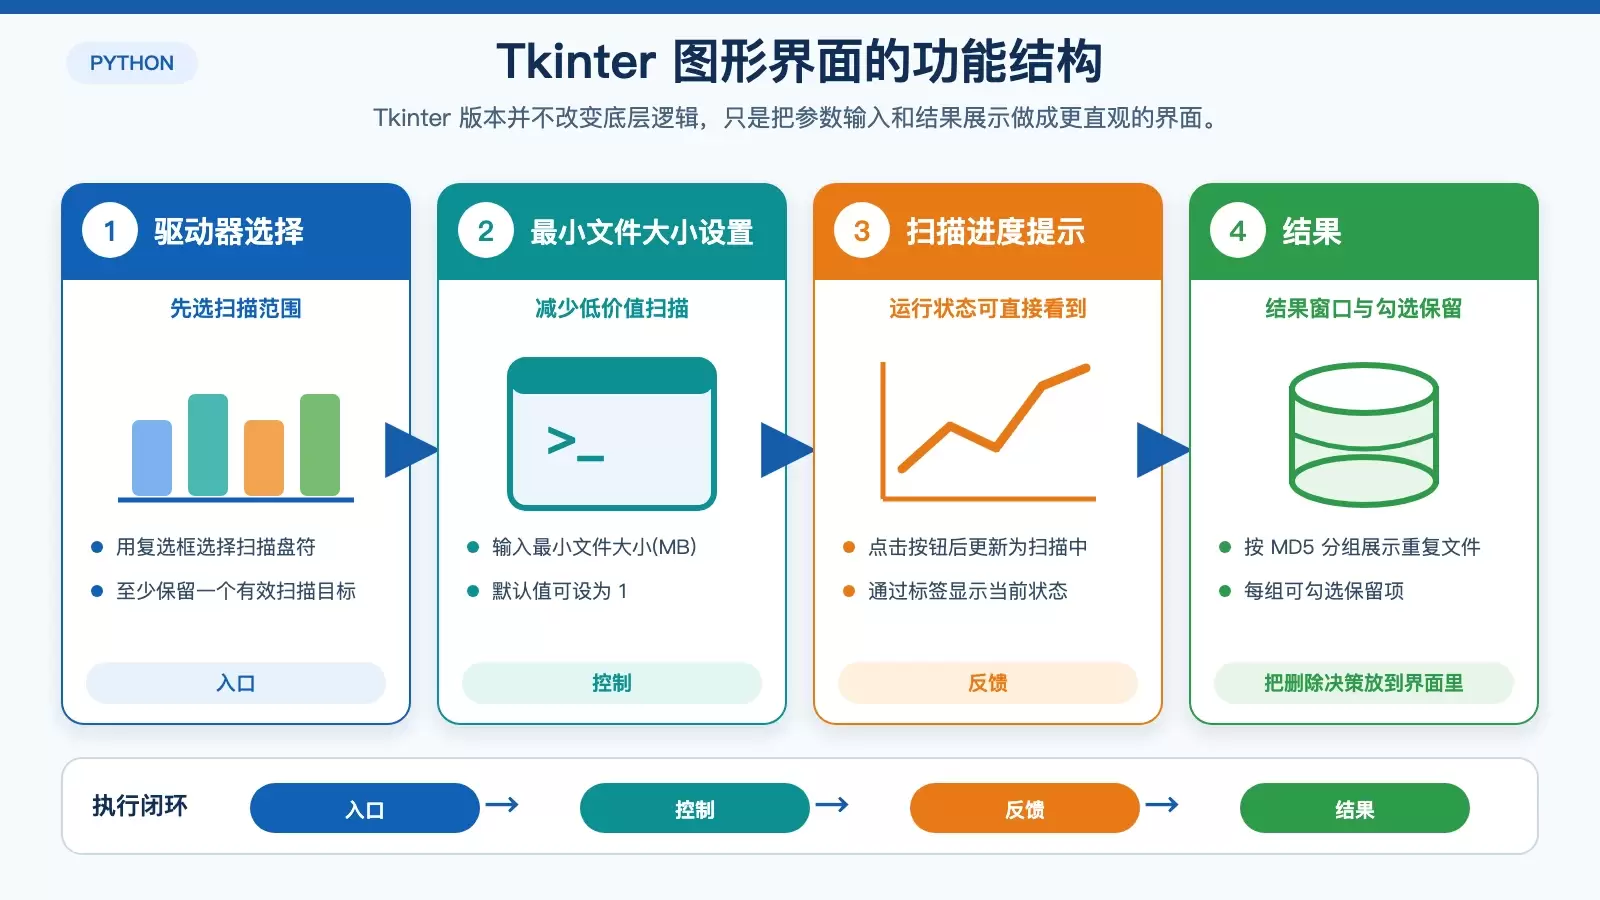
如果这套工具要交给不熟悉命令行的同事或家人使用,Tkinter 是一个成本不高的 GUI 方案。它可以把驱动器选择、最小文件大小输入、扫描按钮和结果展示做成一个简洁窗口。
import tkinter as tk
from tkinter import filedialog, messagebox

class DuplicateFileFinderApp:
    def __init__(self, root):
        self.root = root
        self.setup_ui()

    def setup_ui(self):
        self.root.title("重复文件清理工具")

        # 驱动器选择
        tk.Label(self.root, text="选择扫描的驱动器:").pack()
        self.drive_vars = []
        for drive in get_a vailable_drives():
            var = tk.BooleanVar(value=True)
            cb = tk.Checkbutton(self.root, text=drive, variable=var)
            cb.pack(anchor='w')
            self.drive_vars.append((drive, var))

        # 最小文件大小
        tk.Label(self.root, text="最小文件大小(MB):").pack()
        self.min_size = tk.Entry(self.root)
        self.min_size.insert(0, "1")
        self.min_size.pack()

        # 开始按钮
        tk.Button(self.root, text="开始扫描", command=self.start_scan).pack(pady=10)

        # 进度显示
        self.progress = tk.Label(self.root, text="准备就绪")
        self.progress.pack()

    def start_scan(self):
        drives = [drive for drive, var in self.drive_vars if var.get()]
        min_size = int(self.min_size.get()) * 1024 * 1024

        if not drives:
            messagebox.showerror("错误", "请至少选择一个驱动器")
            return

        self.progress.config(text="扫描中...")
        self.root.update()

        try:
            duplicates = find_duplicate_files(drives, min_size)
            self.show_results(duplicates)
        except Exception as e:
            messagebox.showerror("错误", str(e))

    def show_results(self, duplicates):
        result_window = tk.Toplevel(self.root)
        result_window.title("扫描结果")

        if not duplicates:
            tk.Label(result_window, text="未找到重复文件").pack()
            return

        tk.Label(result_window, text=f"找到 {len(duplicates)} 组重复文件").pack()

        for hash_val, file_paths in duplicates.items():
            group_frame = tk.Frame(result_window, relief='groove', borderwidth=1)
            group_frame.pack(fill='x', padx=5, pady=2)

            tk.Label(group_frame, text=f"MD5: {hash_val}").pack(anchor='w')

            for i, path in enumerate(file_paths):
                var = tk.BooleanVar(value=i==0)
                cb = tk.Checkbutton(group_frame, text=path, variable=var)
                cb.pack(anchor='w')
这类 GUI 不会改变底层逻辑,本质上只是把命令行参数和扫描结果可视化。对于轻量工具来说,这种做法比上完整桌面框架更容易维护。
还能继续扩展到哪些场景
图片相似性检测
普通哈希只能识别“内容完全相同”的图片。如果图片经过重新压缩、裁剪或导出,哪怕视觉上几乎一样,MD5 也会不同。这时可以接入感知哈希做相似图识别。
from PIL import Image
import imagehash

def get_image_hash(image_path):
    """计算图片感知哈希"""
    try:
        with Image.open(image_path) as img:
            return str(imagehash.a verage_hash(img))
    except Exception:
        return None
定期自动清理
如果重复文件问题经常出现,也可以把扫描任务做成定时作业。例如每周自动执行一次扫描,再结合预设删除策略处理固定目录。
import schedule
import time

def job():
    duplicates = find_duplicate_files(["C:/", "D:/"])
    auto_delete(duplicates)

schedule.every().week.do(job)

while True:
    schedule.run_pending()
    time.sleep(1)
扩展到云存储
这套思路也不局限于本地磁盘。只要网盘或对象存储能提供文件列表、大小和校验信息,就可以做重复文件检测。下面这个示例展示了如何读取 Google Drive 文件元数据。
from googleapiclient.discovery import build
from google.oauth2 import service_account

def get_google_drive_files(credentials_file):
    """获取Google Drive文件列表"""
    creds = service_account.Credentials.from_service_account_file(credentials_file)
    service = build('drive', 'v3', credentials=creds)

    results = service.files().list(
        pageSize=1000, fields="nextPageToken, files(id, name, md5Checksum, size)"
    ).execute()

    return results.get('files', [])
如果是实际项目,常见做法通常不是“直接全盘自动删除”,而是先快速扫描找出候选重复项,再对候选做更严格的比对和审查。到了企业场景,还可以把结果写入数据库,做历史对比、重复率统计和趋势分析。















