


Python random.sample()性能瓶颈与高效替代方案解析

当处理大规模数据集时,Python内置的random.sample()方法往往因性能瓶颈而显得力不从心。本文深入探讨了如何利用numpy.random.choice方法实现更高效的随机抽样,详细解析了无放回抽样配置及权重分配机制,帮助开发者在需要高性能随机选取的场景中找到最佳实践。
random.sample()的性能局限
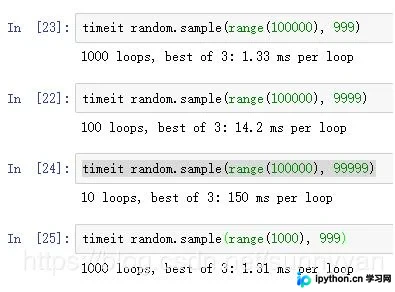
在Python标准库中,random.sample()是一个常用的随机抽样函数,用于从总体(population)中一次性抽取k个不重复的元素。然而,当总体规模N非常大时,该方法的执行速度会显著下降,成为性能瓶颈。这主要是因为其内部实现机制在处理大规模数据时存在开销。
使用numpy.random.choice进行优化
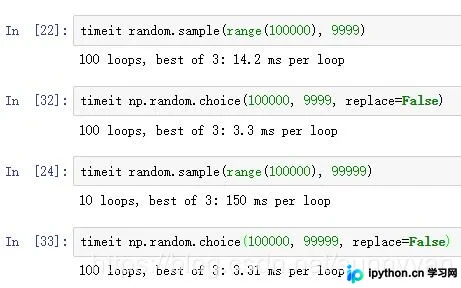
为了提升随机提取的效率,推荐使用NumPy库中的random.choice方法。该方法在处理大规模数据时具有显著的性能优势。在使用numpy.random.choice时,需要注意以下关键参数:
- replace参数:该参数默认为
True,表示有放回抽样。若需实现与random.sample()相同的无放回抽样效果,必须显式将replace设置为False。 - 抽样结果:当
replace=False时,抽取的元素不能重复,这与random.sample()的行为一致。
与random.choice和random.choices的区别
理解不同随机函数的行为对于正确选择替代方案至关重要:
random.choice(seq):从序列(如列表、元组或字符串)中随机选取一个元素并返回。random.choices(population, k):从总体中随机选取k次。每次选取一个元素,允许同一元素被多次选中(有放回抽样)。该方法返回一个列表。random.sample(population, k):从总体中一次抽取k个不重复的元素,返回一个长度为k的列表。
加权随机抽样
在实际应用中,往往需要为不同元素分配不同的被选中概率。NumPy的random.choice支持通过权重参数实现这一需求。
相对权重(weights)
weights参数用于指定每个元素的相对权重值。需要注意的是,总体(population)中元素的数量必须与权重值的数量一一对应。内部机制会将相对权重转换为累积权重以进行抽样。
累积权重(cum_weights)
如果用户已经计算好了累积权重,可以直接通过cum_weights参数传入。这样做可以节省内部将相对权重转换为累积权重的计算工作,进一步提升效率。
总结
综上所述,当面对大规模数据的随机抽样需求且random.sample()性能不足时,numpy.random.choice是一个更优的选择。通过正确配置replace=False以及利用权重参数,可以在保证功能一致性的同时,显著提升执行效率。
以上就是基于Python中random.sample()的替代方案的详细内容,更多关于Python随机抽样性能优化的资料请关注本站其它相关文章!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















