


Python正则表达式完全指南:从字符串处理到爬虫实战

本文深入解析Python中正则表达式的核心概念,涵盖原始字符串定义、基础与预设元字符、边界与重复匹配、分组及贪婪与非贪婪模式。结合爬虫场景,详细演示如何利用re模块提取邮箱、处理相对路径及批量替换,助力开发者高效进行文本处理与数据抓取。
前言
正则表达式在文本处理方面效率极高,绝大多数编程语言都原生支持这一功能。它广泛应用于表单验证、文本提取与替换等场景。在爬虫开发中,熟练掌握正则表达式往往能显著提升数据抓取效率,达到事半功倍的效果。
在正式介绍正则表达式之前,先提出一个实际问题:假设有一段来自豆瓣网页的文本(已做简化),如何从中提取所有出现的邮箱地址?
html = """
  <style>
   .qrcode-app{
    display: block;
    background: url(/pics/qrcode_app4@2x.png) no-repeat;
   }
  </style>

  <div class="reply-doc content">
   <p class="">34613453@qq.com,谢谢了</p>
   <p class="">30604259@qq.com麻烦楼主</p>
  </div>
  <p class="">490010464@163.com<br/>谢谢</p>
  """
若未接触过正则表达式,面对此类问题可能会感到无从下手,且难以找到比正则更优的解决方案。暂且搁置该问题,待掌握正则表达式相关知识后,再来探讨其解决方法。
字符串的表现形式
Python中的字符串有多种表现形式。以u开头的字符串称为Unicode字符串,本文暂不讨论。此外,你可能还见过以下两种写法:
>>> foo = "hello"
>>> bar = r"hello"
前者为常规字符串,后者以r开头,称为原始字符串。二者有何区别?在上述示例中,由于均由普通文本字符组成,因此看似无差异,但通过以下代码可以验证:
>>> foo is bar
True
>>> foo == bar
True
然而,当字符串中包含特殊字符时,情况会有所不同。请看另一个示例:
>>> foo = "\n"
>>> bar = r"\n"

>>> foo, len(foo)
('\n', 1)
>>> bar, len(bar)
('\\n', 2)
>>> foo == bar
False
>>>
"\n"是转义字符,在ASCII码中表示换行符。而r"\n"是原始字符串,原始字符串不对特殊字符进行转义,它仅表示字面意思,即由反斜杠"\"和字符"n"组成的字符串。
定义原始字符串时,可以使用小写r或大写R作为前缀,例如r"\b"或R"\b"均为合法写法。在Python中,正则表达式通常推荐使用原始字符串形式定义,原因如下:
以字符"\b"为例,在ASCII码中它代表退格键,而在正则表达式中,它是匹配单词边界的特殊元字符。为了让正则编译器正确识别其含义,必须使用原始字符串。当然,也可以通过在常规字符串中使用反斜杠"\"进行转义来实现,但原始字符串更为直观。
>>> foo = "\\b"
>>> bar = r"\b"
>>> foo == bar
True
正则基本介绍
正则表达式由普通文本字符和特殊字符(即元字符)两部分组成。元字符赋予了正则表达式强大的表达能力。例如,在正则表达式r"a.d"中,'a'和'd'是普通字符,而'.'是元字符,代表任意单个字符。因此,它能匹配'a1d'、'a2d'或'acd'。其匹配流程如下:
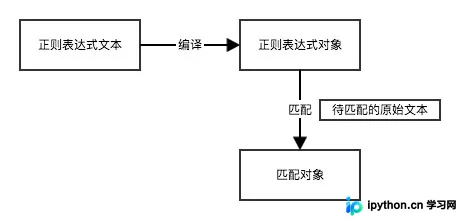
Python内置的re模块专门用于处理正则表达式。
>>> rex = r"a.d" # 正则表达式文本
>>> original_str = "and" # 原始文本
>>> pattern = re.compile(rex) # 正则表达式对象
>>> m = pattern.match(original_str) # 匹配对象
>>> m
<_sre.SRE_Match object at 0x101c85b28>

# 等价于
>>> re.match(r"a.d", "and")
<_sre.SRE_Match object at 0x10a15dcc8>
若原文本字符串与正则表达式匹配,match方法将返回一个Match对象;若不匹配,则返回None。通过判断返回值是否为None,即可实现表单验证等功能。
接下来,我们将学习更多的元字符及其用法。
基本元字符
- .:匹配除换行符以外的任意单个字符。例如,"a.c"可以完全匹配"abc",也能在"abcef"中匹配出"abc"。
- \:转义字符,用于使特殊字符恢复其原本意义。例如,正则表达式1\.2可以匹配字符串"1.2"。
- [...]:匹配方括号内的任意一个字符。例如,a[bcd]e可以匹配abe、ace或ade。该语法还支持范围操作,如"a-z"表示a到z,"0-9"表示0到9。需要注意的是,在"[]"内部,特殊字符不再具有特殊含义,仅表示字面意思,例如[.*]即匹配字符.或*。
- [^...]:字符集取反,表示匹配任何不在括号内的字符。例如,a[^bcd]e可以匹配aee、afe等。
>>> re.match(r"a.c", "abc").group()
'abc'
>>> re.match(r"a.c", "abcef").group()
'abc'
>>> re.match(r"1\.2", "1.2").group()
'1.2'
>>> re.match(r"a[0-9]b", "a2b").group()
'a2b'
>>> re.match(r"a[0-9]b", "a5b11").group()
'a5b'
>>> re.match(r"a[.*?]b", "a.b").group()
'a.b'
>>> re.match(r"abc[^\w]", "abc!123").group()
'abc!
group方法用于返回原字符串中与正则表达式匹配的子字符串。需要注意的是,只有当match方法匹配成功并返回Match对象后,才能调用group方法。
预设元字符
- \w:匹配任意单词字符(包括数字和下划线),等价于[A-Za-z0-9_]。例如,a\wc可以匹配abc或acc。
- \W:匹配任意非单词字符,与\w相反,等价于[^A-Za-z0-9_]。例如,a\Wc可以匹配a!c。
- \s:匹配任意空白字符(包括空格、回车等)。例如,a\sc可以匹配a\nc,其中\n表示回车符。
- \S:匹配任意非空白字符。
- \d:匹配任意数字,等价于[0-9]。例如,a\dc可以匹配a1c或a2c等。
- \D:匹配任意非数字字符。
边界匹配
边界匹配相关的符号专门用于修饰字符的位置。
- ^:匹配字符串的开头。例如,^abc表示匹配以a开头且紧随bc的字符串,如"abc"。
- $:匹配字符串的结尾。例如,hello$表示匹配以hello结尾的字符串。
>>> re.match(r"^abc","abc").group()
'abc'
>>> re.match(r"^abc$","abc").group()
'abc'
重复匹配
前述元字符主要针对单个字符进行匹配。若需匹配重复出现的字符,例如长度为18位的身份证号码,则需要使用重复匹配相关的元字符。
- *:重复匹配零次或多次。
- ?:重复匹配零次或一次。
- +:重复匹配一次或多次。
- {n}:精确重复匹配n次。
- {n,}:重复匹配至少n次。
- {n, m}:重复匹配n到m次。
# 简单匹配身份证号码,前面17位是数字,最后一位可以是数字或者字母X
>>> re.match(r"\d{17}[\dX]", "42350119900101153X").group()
'42350119900101153X'

# 匹配5到12的QQ号码
>>> re.match(r"\d{5,12}$", "4235011990").group()
'4235011990'
逻辑分支
匹配固定电话号码时,不同地区的规则可能不同:部分地区区号为3位、电话为8位,另一些地区区号为4位、电话为7位,且区号与号码间用-分隔。应对此类需求时,需使用逻辑分支条件字符|。它将表达式分为左右两部分,优先尝试匹配左侧部分,若成功则不再匹配右侧,体现逻辑“或”的关系。
# abc|cde 可以匹配abc 或者 cde,但优先匹配abc
>>> re.match(r"aa(abc|cde)","aaabccde").group()
'aaabc'
表达式0\d{2}-\d{8}|0\d{3}-\d{7}以0开头,既能匹配3位区号加8位号码的组合,也能匹配4位区号加7位号码的组合。
>>> re.match(r"0\d{2}-\d{8}|0\d{3}-\d{7}", "0755-4348767").group()
'0755-4348767'
>>> re.match(r"0\d{2}-\d{8}|0\d{3}-\d{7}", "010-34827637").group()
'010-34827637'
分组
前述匹配规则主要针对单个字符。若需对多个字符进行重复匹配,可使用子表达式(即分组)来表示,分组用小括号"()"标识。例如,(abc){2}表示匹配两次"abc"。在匹配IP地址时,可使用(\d{1,3}\.){3}\d{1,3}。由于IP地址由4组数字和3个点组成,前3组数字及点可视为一个分组重复3次,最后一部分为1到3位数字组成的字符串,如"192.168.0.1"。
关于分组,group方法可用于提取匹配的字符串分组。默认情况下,不带参数的group()或group(0)返回整个表达式的匹配结果;第一对括号中的分组可通过group(1)获取,以此类推。
>>> m = re.match(r"(\d+)(\w+)", "123abc")
#分组0,匹配整个正则表达式
>>> m.group()
'123abc'
#等价
>>> m.group(0)
'123abc'
# 分组1,匹配第一对括号
>>> m.group(1)
'123'
# 分组2,匹配第二对括号
>>> m.group(2)
'abc'
>>>
通过分组,我们可以从字符串中提取所需信息。此外,分组还支持命名方式获取。
# 第一个分组的名字是number
# 第二个分组的名字是char
>>> m = re.match(r"(?P<number>\d+)(?P<char>\w+)", "123abc")
>>> m.group("number")
'123'
# 等价
>>> m.group(1)
'123'
贪婪与非贪婪
默认情况下,正则表达式在使整个表达式匹配成功的前提下,尽可能多地匹配字符,这称为贪婪模式,是一种“贪得无厌”的模式。例如,r"a.*b"表示匹配以a开头、b结尾,中间包含任意多个字符的字符串。若用它匹配"aaabcb",它将匹配整个字符串"aaabcb"。
>>> re.match(r"a.*b", "aaabcb").group()
'aaabcb'
若希望尽可能少地匹配,只需在量词后添加问号"?"。在保证匹配成功的前提下,尽可能少地匹配字符。例如,若希望仅匹配"aaab",只需将正则表达式修改为r"a.*?b"。
>>> re.match(r"a.*?b", "aaabcb").group()
'aaab'
>>>
非贪婪模式在爬虫应用中极为常见。例如,在爬取网站并转换为PDF的场景中,若网页img标签涉及相对路径,需将其替换为绝对路径。
>>> html = '<img src="/images/category.png"><img src="/images/js_framework.png">'

# 非贪婪模式就匹配的两个img标签
# 你可以改成贪婪模式看看可以匹配几个
>>> rex = r'<img.*?src="(.*?)">'
>>> re.findall(rex, html)
['/images/category.png', '/images/js_framework.png']
>>>
>>> def fun(match):
...  img_tag = match.group()
...  src = match.group(1)
...  full_src = "http://foofish.net" + src
...  new_img_tag = img_tag.replace(src, full_src)
...  return new_img_tag
...
>>> re.sub(rex, fun, html)
<img src="http://foofish.net/images/category.png"><img src="http://foofish.net/images/js_framework.png">
sub函数可接受一个函数作为替换目标,该函数的返回值将用于替换正则表达式匹配的部分。在此示例中,我们将整个img标签定义为一个正则表达式r'',group()返回的值是<img src="/images/category.png"> ,而group(1)的返回值是/images/category.png。最后,利用replace方法将相对路径替换为绝对路径。
至此,你应该对正则表达式有了初步了解,现在你应该能够解决文章开篇提出的邮箱提取问题了。
正则表达式的基本介绍到此告一段落。虽然代码示例中使用了re模块的多种方法,但尚未正式详细介绍该模块。考虑到文章篇幅,这部分内容将放在下篇,下篇将对re模块的常用方法进行系统介绍。
总结
以上就是本文的全部内容,希望这些内容能对大家的Python学习或工作有所帮助。如有任何疑问,欢迎留言交流,感谢大家对本站的支持。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















