


Python字符编码详解:从原理到Python2与Python3的差异

本文深入解析Python字符编码机制,阐述ASCII、GBK、Unicode及UTF-8的发展与区别。重点讲解Python解释器执行流程中文件读写与内存编码转换原理,对比Python2与Python3在字符串类型(str/bytes/unicode)及默认编码策略上的核心差异,帮助开发者避免编码错误。
前言与核心原则
前言
字符编码问题在开发中极为常见,为确保程序稳定运行,需牢记以下核心原则:
1. 文件以何种编码保存,读取时就必须使用相同的编码打开。
2. 程序执行的第一步是将文件内容从硬盘加载至内存。
3. Unicode作为基础编码(父编码),可以通过encode操作转换为其他特定编码格式。
UTF-8、GBK等属于子编码,它们通过decode操作转换为Unicode。
字符编码基础与演进
一、字符编码的基本概念
计算机底层仅能识别二进制数据,人类编写的代码必须转换为二进制方可被处理。字符转换为二进制的过程依赖于一种标准,该标准建立了字符与特定数字之间的映射关系,此标准即为字符编码。
字符 ——[编码标准]——> 数字
二、字符编码的演进历史
1. ASCII码
计算机起源于美国,其字符编码体系亦始于美国。英语仅包含26个字母及少量符号,因此美国采用了ASCII码(美国信息交换标准码)。在ASCII中,1个字节(Byte)代表一个字符,1 Byte等于8位(bit),可产生2的8次方即256种组合。早期仅使用前7位,涵盖127个字符,已满足英语需求。后续将拉丁文字符纳入第8位,使ASCII码资源耗尽,但足以支持英语及拉丁语系国家的使用。
2. GBK编码
尽管早期科技水平有限,中国仍于1980年发布了适用于中文的字符编码标准GBK。GBK采用双字节表示一个汉字,2的16次方即65536种组合,足以覆盖常用汉字需求。
与此同时,其他国家也制定了各自的编码标准,例如日本的Shift_JIS和韩国的Euc-kr等。
3. Unicode
在字符编码鼎盛时期,存在数百种互不兼容的编码标准,这严重阻碍了国际间的数据互通。为此,Unicode应运而生。1994年,国际标准化组织发布了被称为“万国码”的Unicode标准,采用双字节表示一个字符,提供65536种组合,能够涵盖全球绝大多数语言的字符。
4. UTF-8编码
Unicode虽功能强大,但存在存储效率低下的问题:原本只需单字节表示的英文字符,在Unicode中需占用双字节,导致存储空间翻倍。为解决此问题,UTF-8被提出。UTF-8采用变长编码:英文字符占用1个字节,中文字符占用3个字节,从而在保持兼容性的同时节省空间。
Unicode将所有字符统一固定为双字节,转换效率高,但存储空间占用较大。
UTF-8对不同字符采用不同长度表示,显著节省存储空间,但转换效率略低于Unicode。
内存中通常使用Unicode编码,因为内存的主要目的是加速数据处理,因此宁愿牺牲部分空间也要保证处理速度。
硬盘存储和网络传输主要使用UTF-8编码。这是因为磁盘I/O和网络I/O的延迟远高于UTF-8的转换耗时,且在网络传输中节省带宽至关重要。
Python解释器执行流程
三、Python解释器的执行流程
第一阶段:Python解释器启动,其作用类似于启动了一个文本编辑器。
第二阶段:Python解释器作为文本编辑器,打开目标文件(如t.py),并将文件内容从硬盘读取至内存。
第三阶段:Python解释器对已加载到内存中的代码进行解释执行。
在第二阶段中,文件在保存时具有特定的字符编码。Python解释器打开文件时,需指定与保存时相同的编码方式(Python 2默认编码为ASCII,Python 3默认编码为UTF-8)。若文件保存编码与解释器默认编码不一致,需在文件头部添加#coding:指定编码声明,告知解释器使用指定编码读取文件,从而避免错误。
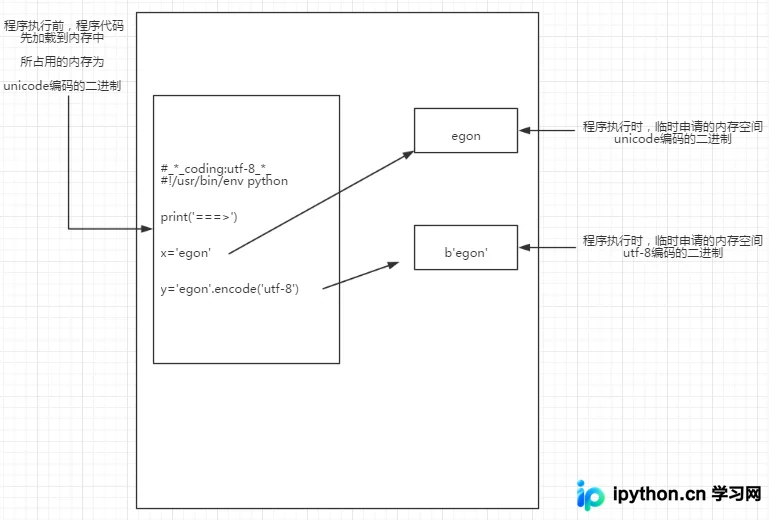
第三阶段涉及读取已加载到内存的代码(默认编码为Unicode),随后执行代码。执行过程中若遇到变量定义等操作,将在内存中开辟新空间。需注意,新开辟的内存空间不一定存储Unicode,用户可在定义变量时指定编码格式。此时开辟的空间仅用于存放任意编码格式的代码。以Python 3为例进行说明。
编码与解码机制解析
四、编码与解码机制
保存文件是将内存中的数据持久化至硬盘的过程。
读取文件是将硬盘中的数据加载至内存的过程。
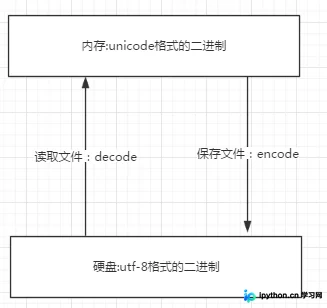
Unicode作为父编码,UTF-8、GBK等作为子编码。若要将子编码转换为其他编码,必须先将其转换为父编码(Unicode),再由父编码转换为其他子编码。
解码(decode)是指将子编码转换为父编码(Unicode)的过程。
编码(encode)是指将父编码(Unicode)转换为其他子编码的过程。
如前所述,文件读入内存后通常变为Unicode编码(默认情况,也可通过指令更改)。从硬盘读取文件的过程,即是将硬盘中的UTF-8编码解码为Unicode。
文件保存时,是将内存数据写入硬盘的过程。由于硬盘中存储的是UTF-8编码,因此需要将内存中的Unicode编码转换为UTF-8编码。
Python 2与Python 3的差异对比
五、Python 2与Python 3的核心区别
1. Python 2的默认编码为ASCII,直接打开UTF-8保存的文件会报错,需在文件头部添加#coding: utf-8声明。
在Python 2中,str类型被识别为Bytes(字节序列),即str是编码后的结果。Python 2内部默认执行的操作是:在str前添加u前缀转换为Unicode,然后再encode为bytes。
Python 2包含两种字符串类型:str和Unicode。str可通过在字符串前添加'u'前缀转换为Unicode类型。
2. Python 3的默认编码为UTF-8,可直接打开UTF-8保存的文件。
在Python 3中,str类型被识别为Unicode。
Python 3同样包含两种字符串类型:bytes和str。其中,bytes即为字节序列,str即为Unicode字符串。
终端打印与编码处理
六、终端打印机制
首先需明确,Windows终端的默认编码为GBK。
终端是运行在内存中的应用程序,因此print()函数的打印过程是从内存到内存的操作。对于Unicode编码,打印通常不会出错;但在Python 2中,除添加'u'前缀的字符串外,其他字符串均为Bytes类型。此时终端期望GBK编码,而Python 2中指定的是UTF-8或默认ASCII编码,导致终端打印时出现乱码或错误。
以上为当前对字符编码的理解,若后续发现错误或表述不清之处,将及时修正。字符编码确实是一个复杂的领域。
以上关于Python基础字符编码的内容即为本文全部分享,希望能对读者有所帮助,欢迎支持本站。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















