


Python实现八大排序算法详解:快速、堆、归并与基数排序

本文接续前篇,详细解析Python实现的剩余四种核心排序算法:快速排序、堆排序、归并排序及基数排序。文章深入阐述各算法的分治思想、时间复杂度特性及优缺点,并提供Python代码实现与优化技巧,如快速排序的三者取中法及基数排序的桶分布逻辑,助力开发者掌握高效排序策略。
承接上一篇关于Python实现八大排序算法(Part 1)的内容,本文将重点介绍并实现剩余的四种排序算法:快速排序、堆排序、归并排序以及基数排序。
5、快速排序
在平均性能方面,快速排序通常被认为是同数量级(O(nlog2n))排序方法中表现最优的一种。
算法核心思想:
假设有一组无序数据a[1]、a[2]、……a[n],目标是将其按升序排列。算法首先选取任意一个数据a[x]作为基准值(pivot)。通过比较和交换操作,将a[x]放置到排序后的第k个位置,确保a[1]至a[k-1]区间内的所有数据均小于a[x],而a[k+1]至a[n]区间内的所有数据均大于a[x]。随后,采用分治策略,分别对a[1]至a[k-1]和a[k+1]至a[n]这两组子序列递归执行快速排序。 优点:执行速度极快,数据移动次数较少; 缺点:排序过程不稳定。
Python代码实现:
def quick_sort(list):
  little = []
  pivotList = []
  large = []
  # 递归出口
  if len(list) <= 1:
    return list
  else:
    # 将第一个值做为基准
    pivot = list[0]
    for i in list:
      # 将比基准小的值放到less数列
      if i < pivot:
        little.append(i)
      # 将比基准大的值放到more数列
      elif i > pivot:
        large.append(i)
      # 将和基准相同的值保存在基准数列
      else:
        pivotList.append(i)
    # 对less数列和more数列继续进行快速排序
    little = quick_sort(little)
    large = quick_sort(large)
    return little + pivotList + large
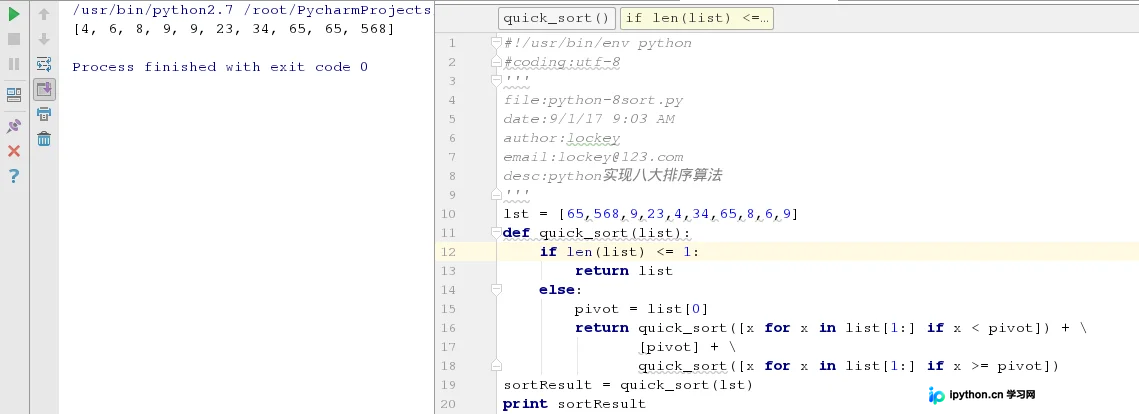
以下代码片段源自《Python Cookbook》第二版,展示了如何用极简的三行代码实现Python快速排序。
#!/usr/bin/env python
#coding:utf-8
'''
file:python-8sort.py
date:9/1/17 9:03 AM
author:lockey
email:lockey@123.com
desc:python实现八大排序算法
'''
lst = [65,568,9,23,4,34,65,8,6,9]
def quick_sort(list):
  if len(list) <= 1:
    return list
  else:
    pivot = list[0]
    return quick_sort([x for x in list[1:] if x < pivot]) + \
        [pivot] + \
        quick_sort([x for x in list[1:] if x >= pivot])
运行测试结果截图:
此外,还存在更精简的语法糖写法,仅需一行代码即可完成:
quick_sort = lambda xs : ( (len(xs) <= 1 and [xs]) or [ quick_sort( [x for x in xs[1:] if x < xs[0]] ) + [xs[0]] + quick_sort( [x for x in xs[1:] if x >= xs[0]] ) ] )[0]
需要注意的是,如果初始序列的关键码已经有序或基本有序,快速排序的性能会退化至冒泡排序的水平。为了改进这一情况,通常采用“三者取中法”来选择基准记录,即从排序区间的两个端点和中间点这三个记录的关键码中,选取居中的值作为支点。需要强调的是,快速排序属于不稳定排序方法。
在算法改进实践中,一种常见策略是仅对长度大于k的子序列递归调用快速排序,使原序列达到基本有序状态,随后对整个序列使用插入排序进行最终排序。实践表明,这种改进算法能有效降低时间复杂度,且当k值设定为8左右时,算法性能达到最佳。
6、堆排序(Heap Sort)
堆排序属于树形选择排序,是对直接选择排序的一种高效改进。
优点:执行效率高; 缺点:排序不稳定。
堆的定义如下:对于包含n个元素的序列(h1,h2,...,hn),若满足(hi>=h2i, hi>=h2i+1)或(hi<=h2i, hi<=h2i+1)(其中i=1,2,...,n/2),则称该序列为堆。本文仅讨论满足前者条件的大顶堆。根据定义,堆顶元素(即序列的第一个元素)必然是最大值。完全二叉树可以直观地表示堆的结构,其中堆顶为根节点,其余元素分布为左子树和右子树。
算法核心思想:
初始状态下,将待排序数的序列视为一棵顺序存储的二叉树,并通过调整存储顺序使其成为一个堆,此时堆的根节点包含最大值。接着,将根节点与堆的最后一个节点交换位置,然后对剩余的(n-1)个节点重新调整以形成新的堆。重复此过程,直到堆中仅剩两个节点并进行交换,最终得到包含n个节点的有序序列。从算法描述来看,堆排序包含两个主要过程:一是建立初始堆,二是反复交换堆顶与末尾元素并调整堆。因此,堆排序主要由两个函数构成:用于建堆的渗透函数,以及反复调用渗透函数以实现排序的主函数。
Python代码实现:
# -*- coding: UTF-8 -*-
'''
Created on 2017年9月2日
Running environment:win7.x86_64 eclipse python3
@author: Lockey
'''
lst = [65,568,9,23,4,34,65,8,6,9]
def adjust_heap(lists, i, size):# 调整堆
  lchild = 2 * i + 1;rchild = 2 * i + 2
  max = i
  if i < size / 2:
    if lchild < size and lists[lchild] > lists[max]:
      max = lchild
    if rchild < size and lists[rchild] > lists[max]:
      max = rchild
    if max != i:
      lists[max], lists[i] = lists[i], lists[max]
      adjust_heap(lists, max, size)
def build_heap(lists, size):# 创建堆
  halfsize = int(size/2)
  for i in range(0, halfsize)[::-1]:
    adjust_heap(lists, i, size)
def heap_sort(lists):# 堆排序
  size = len(lists)
  build_heap(lists, size)
  for i in range(0, size)[::-1]:
    lists[0], lists[i] = lists[i], lists[0]
    adjust_heap(lists, 0, i)
    print(lists)
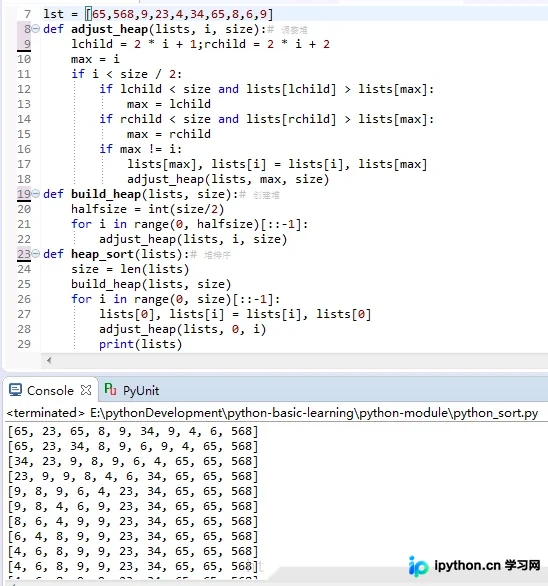
结果示例:
7、归并排序
算法核心思想:
归并(Merge)排序是一种基于归并操作的有效排序算法,也是分治法的典型应用。其核心在于将已有序的子序列合并,从而生成完全有序的序列;即先使每个子序列有序,再使子序列段间有序。若将两个有序表合并成一个有序表,则称为二路归并。
归并过程具体为:比较a[i]和a[j]的大小,若a[i]≤a[j],则将第一个有序表中的元素a[i]复制到结果数组r[k]中,并使索引i和k各加1;否则,将第二个有序表中的元素a[j]复制到r[k]中,并使索引j和k各加1。此过程循环进行,直到其中一个有序表取完,然后将另一个有序表中剩余的元素复制到r中从下标k到下标t的单元。归并排序通常通过递归实现:首先将待排序区间[s,t]以中点二分,接着分别对左边子区间和右边子区间进行排序,最后通过一次归并操作将左右区间合并为有序区间[s,t]。
# -*- coding: UTF-8 -*-
'''
Created on 2017年9月2日
Running environment:win7.x86_64 eclipse python3
@author: Lockey
'''
lst = [65,568,9,23,4,34,65,8,6,9]
def merge(left, right):
  i, j = 0, 0
  result = []
  while i < len(left) and j < len(right):
    if left[i] <= right[j]:
      result.append(left[i])
      i += 1
    else:
      result.append(right[j])
      j += 1
  result += left[i:]
  result += right[j:]
  print(result)
  return result
def merge_sort(lists):# 归并排序
  if len(lists) <= 1:
    return lists
  num = int(len(lists) / 2)
  left = merge_sort(lists[:num])
  right = merge_sort(lists[num:])
  return merge(left, right)
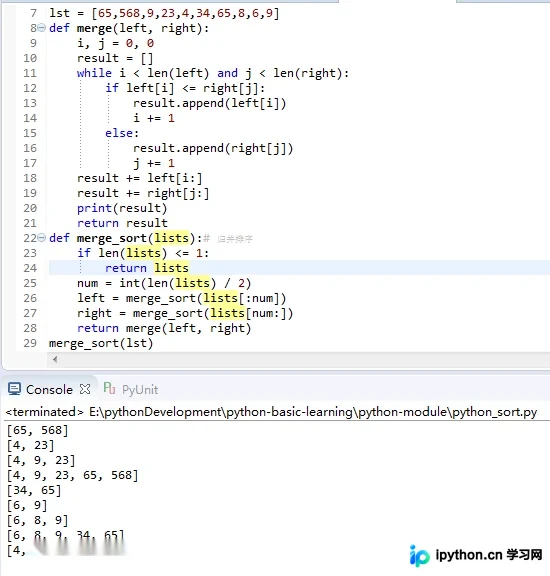
程序运行结果示例:
8、桶排序/基数排序(Radix Sort)
优点:速度极快,效率最高可达O(1); 缺点:
1. 空间复杂度较高,额外开销较大。排序需要两个数组的空间开销:一个存放待排序数组,另一个为桶数组。例如,若待排序值范围从0到m-1,则需要m个桶,即桶数组至少需要m个空间。
2. 待排序元素必须处于一定的数值范围内。
算法核心思想:
该方法将阵列分配到有限数量的桶子中,每个桶子内部再单独进行排序(可能使用其他排序算法或递归使用桶排序)。桶排序可视为鸽巢排序的一种归纳结果。当被排序阵列内的数值分布均匀时,桶排序可使用线性时间(Θ(n))。由于桶排序不属于比较排序,因此不受O(n log n)下限的影响。 简而言之,即把数据分组放入各个桶中,然后对每个桶内的数据进行排序。 例如,需对大小为[1..1000]范围内的n个整数A[1..n]进行排序。
首先,可将桶大小设为10,从而形成100个桶。具体而言,设集合B[1]存储[1..10]的整数,集合B[2]存储(10..20]的整数,……集合B[i]存储((i-1)*10, i*10]的整数,其中i = 1,2,..100。总计100个桶。
然后,对A[1..n]进行从头到尾的扫描,将每个A[i]放入对应的桶B[j]中。接着对这100个桶中的每个桶内的数字进行排序,此时可使用冒泡、选择乃至快排等任意排序算法。
最后,依次输出每个桶内的数字,且确保每个桶中的数字按从小到大顺序输出,从而得到所有数字排好序的完整序列。
假设有n个数字,分为m个桶。若数字分布均匀,则每个桶内平均包含n/m个数字。如果
对每个桶中的数字采用快速排序,那么整个算法的复杂度为
O(n + m * n/m*log(n/m)) = O(n + nlogn - nlogm)
从上式可以看出,当m接近n时,桶排序的复杂度接近O(n)。
当然,上述复杂度的计算基于输入的n个数字均匀分布这一假设。该假设条件较强,实际应用中效果可能不如理论预期。如果所有数字都落入同一个桶中,算法将退化为一般排序。
Python代码实现:
# -*- coding: UTF-8 -*-
'''
Created on 2017年9月2日
Running environment:win7.x86_64 eclipse python3
@author: Lockey
'''
import math
lst = [65,56,9,23,84,34,8,6,9,54,11]
#因为列表数据范围在100以内,所以将使用十个桶来进行排序
def radix_sort(lists, radix=10):
  k = int(math.ceil(math.log(max(lists), radix)))
  bucket = [[] for i in range(radix)]
  for i in range(1, k+1):
    for j in lists:
      gg = int(j/(radix**(i-1))) % (radix**i)
      bucket[gg].append(j)
    del lists[:]
    for z in bucket:
      lists += z
      del z[:]
      print(lists)
  return lists
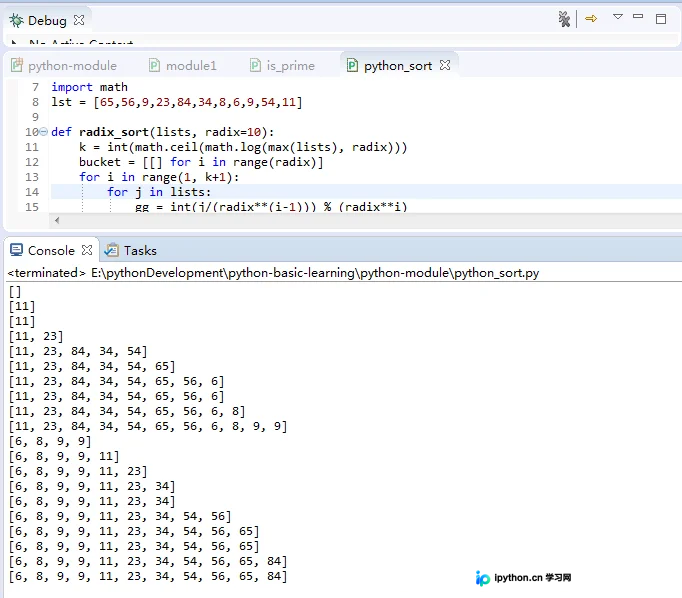
程序运行测试结果:
以上就是本文的全部内容,希望对大家的学习有所帮助,也欢迎大家多多支持本站。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















