


Python实现朴素贝叶斯分类器:从概率论基础到代码实战

本文深入解析基于概率论的朴素贝叶斯分类算法。从贝叶斯定理与条件概率基础入手,阐述核心决策理论,并详细演示在Python中构建词向量、计算特征概率及训练分类器的完整流程。通过社区留言过滤案例,展示如何处理标称型数据,帮助读者掌握这一高效的多类别分类方法。
概率论知识或许已逐渐淡忘。
基于概率论的分类方法:朴素贝叶斯
1. 概述
贝叶斯分类是一类以贝叶斯定理为基础的分类算法总称。本章将首先介绍该算法的理论基础——贝叶斯定理,随后通过具体实例探讨其中最为简单的一种:朴素贝叶斯分类。
2. 贝叶斯理论 & 条件概率
2.1 贝叶斯理论
假设我们拥有一个包含两类数据的数据集,其分布情况如图所示:
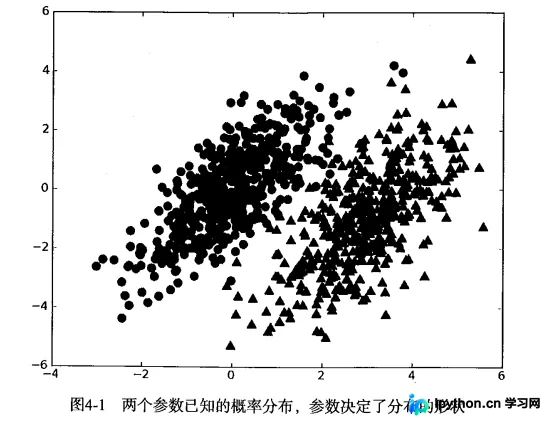
定义 p1(x,y) 为数据点 (x,y) 属于类别 1(图中圆点所示)的概率,p2(x,y) 为数据点 (x,y) 属于类别 2(图中三角形所示)的概率。对于一个新的数据点 (x,y),可依据以下规则判定其类别:
如果 p1(x,y) > p2(x,y) ,那么类别为1
如果 p2(x,y) > p1(x,y) ,那么类别为2
即选择概率值较高的类别作为决策结果。这便是贝叶斯决策理论的核心:选取具有最高后验概率的类别。
2.1.2 条件概率
若你对符号 p(x,y|c1) 已熟悉,可略过本节。
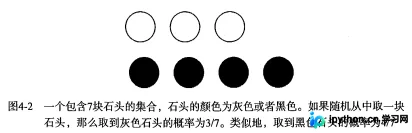
考虑一个装有 7 块石头的罐子,其中 3 块白色,4 块黑色。随机取出一块石头,它是白色的可能性是多少?由于共有 7 种可能的抽取结果,其中 3 种对应白色石头,因此取出白色石头的概率为 3/7。同理,取出黑色石头的概率为 4/7。我们使用 P(white) 表示取到白色石头的概率,其值等于白色石头数量除以总石头数量。
若这 7 块石头按如下方式分布在两个桶中,上述概率应如何计算?
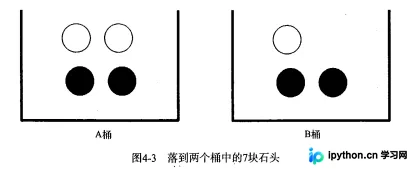
若事先知晓石头所在的桶,计算 P(white) 或 P(black) 的结果将会改变,这即为条件概率(conditional probability)。假设我们要计算从 B 桶中取出白色石头的概率,记作 P(white|bucketB),意为“已知石头出自 B 桶条件下,取出白色石头的概率”。易得 P(white|bucketA) 为 2/4,P(white|bucketB) 为 1/3。
条件概率的计算公式如下:
P(white|bucketB) = P(white and bucketB) / P(bucketB)
首先,用 B 桶中白色石头数除以总石头数,得到 P(white and bucketB) = 1/7。其次,因 B 桶有 3 块石头,总数为 7,故 P(bucketB) = 3/7。因此,P(white|bucketB) = (1/7) / (3/7) = 1/3。
另一种有效的条件概率计算方法称为贝叶斯准则。该准则指导我们如何交换条件与结果:若已知 P(x|c) 而需计算 P(c|x),可使用以下公式:
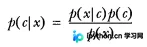
使用条件概率来分类
前文提到贝叶斯决策理论需计算 p1(x, y) 和 p2(x, y):
如果 p1(x, y) > p2(x, y), 那么属于类别 1;
如果 p2(x, y) > p1(X, y), 那么属于类别 2.
这并非贝叶斯决策理论的全部内容。使用 p1() 和 p2() 仅为简化描述,实际需计算比较的是 p(c1|x, y) 和 p(c2|x, y)。其含义是:给定由 x、y 表示的数据点,该点属于类别 c1 的概率是多少?属于类别 c2 的概率又是多少?注意这些概率不同于 p(x, y|c1),但可通过贝叶斯准则交换条件与结果。具体应用贝叶斯准则得到:
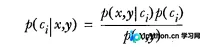
基于上述定义,贝叶斯分类准则定义为:
如果 P(c1|x, y) > P(c2|x, y), 那么属于类别 c1;
如果 P(c2|x, y) > P(c1|x, y), 那么属于类别 c2.
在文档分类任务中,整篇文档(如电子邮件)视为实例,文档中的某些元素构成特征。我们可以观察文档中出现的词汇,将每个词视为一个特征,并以该词是否出现作为特征值。这样,特征数量将与词汇表中的词数一致。
我们假设特征之间相互独立。所谓独立(independence)指统计意义上的独立,即一个特征或单词出现的可能性与其与其他单词相邻无关。例如,“我们”中“我”和“们”出现的概率与它们是否相邻无关。这一假设正是朴素贝叶斯分类器中“朴素(naive)”一词的含义。此外,朴素贝叶斯分类器还假设每个特征同等重要。
Note: 朴素贝叶斯分类器通常有两种实现方式:基于伯努利模型和基于多项式模型。本文采用前一种。该方式不考虑词在文档中出现的次数,仅考虑是否出现,因此相当于假设词是等权重的。
2.2 朴素贝叶斯场景
机器学习的重要应用之一是文档自动分类。
在文档分类中,整篇文档(如电子邮件)是实例,文档中的某些元素构成特征。我们可以观察文档中出现的词,并将每个词作为一个特征,以词的出现或不出现作为特征值,从而得到的特征数目与词汇表中的词数相同。
朴素贝叶斯是前述贝叶斯分类器的扩展,常用于文档分类。下文将进行相关实践项目。
2.3 朴素贝叶斯 原理
朴素贝叶斯 工作原理
1. 提取所有文档中的词条并进行去重。 2. 获取文档的所有类别。 3. 计算每个类别中的文档数目。 4. 对每篇训练文档执行以下操作:
对每个类别: 1. 若词条出现在文档中,则增加该词条的计数值(通过 for 循环或矩阵相加)。 2. 增加该类别下所有词条的总计数值。 对每个类别:
对每个词条: 1. 将该词条的数目除以总词条数目,得到条件概率 P(词条|类别)。 2. 返回该文档属于每个类别的条件概率 P(类别|文档的所有词条)。
2.4 朴素贝叶斯开发流程
收集数据: 可使用任何方法。
准备数据: 需要数值型或者布尔型数据。
分析数据: 当特征数量较多时,绘制特征作用有限,此时使用直方图效果更佳。
训练算法: 计算不同的独立特征的条件概率。
测试算法: 计算错误率。
使用算法: 朴素贝叶斯常见应用为文档分类,但也可用于任意分类场景,不限于文本。
2.5 朴素贝叶斯算法特点
优点: 在数据量较少时仍有效,且能处理多类别问题。 缺点: 对输入数据的预处理方式较为敏感。 适用数据类型: 标称型数据。
2.6 朴素贝叶斯 项目案例
2.6.1 项目案例1
屏蔽社区留言板的侮辱性言论
2.6.1.1 项目概述
构建一个快速过滤器以屏蔽在线社区留言板上的侮辱性言论。若留言包含负面或侮辱性语言,则将其标记为内容不当。为此建立两个类别:侮辱类和非侮辱类,分别用 1 和 0 表示。
2.6.1.2 开发流程
收集数据: 可使用任何方法。
准备数据: 从文本中构建词向量。
分析数据: 检查词条以确保解析正确。
训练算法: 从词向量计算概率。
测试算法: 根据现实情况调整分类器。
使用算法: 对社区留言板言论进行分类。
收集数据: 可使用任何方法。
2.6.1.3 构造词表
def loadDataSet():
  """
  创建数据集
  :return: 单词列表postingList, 所属类别classVec
  """
  postingList = [['my', 'dog', 'has', 'flea', 'problems', 'help', 'please'], #[0,0,1,1,1......]
          ['maybe', 'not', 'take', 'him', 'to', 'dog', 'park', 'stupid'],
          ['my', 'dalmation', 'is', 'so', 'cute', 'I', 'love', 'him'],
          ['stop', 'posting', 'stupid', 'worthless', 'garbage'],
          ['mr', 'licks', 'ate', 'my', 'steak', 'how', 'to', 'stop', 'him'],
          ['quit', 'buying', 'worthless', 'dog', 'food', 'stupid']]
  classVec = [0, 1, 0, 1, 0, 1] # 1 is abusive, 0 not
  return postingList, classVec
2.6.1.4 准备数据: 从文本中构建词向量
def createVocabList(dataSet):
  """
  获取所有单词的集合
  :param dataSet: 数据集
  :return: 所有单词的集合(即不含重复元素的单词列表)
  """
  vocabSet = set([]) # create empty set
  for document in dataSet:
    # 操作符 | 用于求两个集合的并集
    vocabSet = vocabSet | set(document) # union of the two sets
  return list(vocabSet)


def setOfWords2Vec(vocabList, inputSet):
  """
  遍历查看该单词是否出现,出现该单词则将该单词置1
  :param vocabList: 所有单词集合列表
  :param inputSet: 输入数据集
  :return: 匹配列表[0,1,0,1...],其中 1与0 表示词汇表中的单词是否出现在输入的数据集中
  """
  # 创建一个和词汇表等长的向量,并将其元素都设置为0
  returnVec = [0] * len(vocabList)# [0,0......]
  # 遍历文档中的所有单词,如果出现了词汇表中的单词,则将输出的文档向量中的对应值设为1
  for word in inputSet:
    if word in vocabList:
      returnVec[vocabList.index(word)] = 1
    else:
      print "the word: %s is not in my Vocabulary!" % word
  return returnVec
2.6.1.5 分析数据: 检查词条确保解析的正确性
检查函数执行情况,确认词表中无重复单词,必要时可对其进行排序。
>>> listOPosts, listClasses = bayes.loadDataSet()
>>> myVocabList = bayes.createVocabList(listOPosts)
>>> myVocabList
['cute', 'love', 'help', 'garbage', 'quit', 'I', 'problems', 'is', 'park',
'stop', 'flea', 'dalmation', 'licks', 'food', 'not', 'him', 'buying', 'posting', 'has', 'worthless', 'ate', 'to', 'maybe', 'please', 'dog', 'how',
'stupid', 'so', 'take', 'mr', 'steak', 'my']
验证函数有效性。例如:查询 myVocabList 中索引为 2 的元素对应哪个单词?应为 help。该词在第一篇文档中出现,现检查其是否出现在第四篇文档中。
>>> bayes.setOfWords2Vec(myVocabList, listOPosts[0])
[0, 0, 1, 0, 0, 0, 1, 0, 0, 0, 1, 0, 0, 0, 0, 0, 0, 0, 1, 0, 0, 0, 0, 1, 1, 0, 0, 0, 0, 0, 0, 1]

>>> bayes.setOfWords2Vec(myVocabList, listOPosts[3])
[0, 0, 0, 1, 0, 0, 0, 0, 0, 1, 0, 0, 0, 0, 0, 0, 0, 1, 0, 1, 0, 0, 0, 0, 0, 0, 1, 0, 0, 0, 0, 0]
2.6.1.6 训练算法: 从词向量计算概率
已知某词是否出现在文档中,以及该文档所属类别。接下来重写贝叶斯准则,将之前的 x, y 替换为 w。粗体 w 表示向量,即由多个值组成。在此例中,数值个数与词汇表中的词数相同。
利用上述公式,对每个类计算该值,并比较这两个概率值的大小。
首先,通过类别 i(侮辱性留言或非侮辱性留言)中的文档数除以总文档数来计算概率 p(ci)。接着计算 p(w | ci),此处需应用朴素贝叶斯假设。若将 w 展开为独立特征,则上述概率可写作 p(w0, w1, w2…wn | ci)。假设所有词互相独立,该假设亦称条件独立性假设(例如 A 和 B 两人抛骰子,概率互不影响,A 抛 2 点且 B 抛 3 点的概率为 1/6 * 1/6),这意味着可使用 p(w0 | ci)p(w1 | ci)p(w2 | ci)…p(wn | ci) 计算上述概率,从而极大简化计算过程。
2.6.1.7 朴素贝叶斯分类器训练函数
def _trainNB0(trainMatrix, trainCategory):
  """
  训练数据原版
  :param trainMatrix: 文件单词矩阵 [[1,0,1,1,1....],[],[]...]
  :param trainCategory: 文件对应的类别[0,1,1,0....],列表长度等于单词矩阵数,其中的1代表对应的文件是侮辱性文件,0代表不是侮辱性矩阵
  :return:
  """
  # 文件数
  numTrainDocs = len(trainMatrix)
  # 单词数
  numWords = len(trainMatrix[0])
  # 侮辱性文件的出现概率,即trainCategory中所有的1的个数,
  # 代表的就是多少个侮辱性文件,与文件的总数相除就得到了侮辱性文件的出现概率
  pAbusive = sum(trainCategory) / float(numTrainDocs)
  # 构造单词出现次数列表
  p0Num = zeros(numWords) # [0,0,0,.....]
  p1Num = zeros(numWords) # [0,0,0,.....]

  # 整个数据集单词出现总数
  p0Denom = 0.0
  p1Denom = 0.0
  for i in range(numTrainDocs):
    # 是否是侮辱性文件
    if trainCategory[i] == 1:
      # 如果是侮辱性文件,对侮辱性文件的向量进行加和
      p1Num += trainMatrix[i] #[0,1,1,....] + [0,1,1,....]->[0,2,2,...]
      # 对向量中的所有元素进行求和,也就是计算所有侮辱性文件中出现的单词总数
      p1Denom += sum(trainMatrix[i])
    else:
      p0Num += trainMatrix[i]
      p0Denom += sum(trainMatrix[i])
  # 类别1,即侮辱性文档的[P(F1|C1),P(F2|C1),P(F3|C1),P(F4|C1),P(F5|C1)....]列表
  # 即 在1类别下,每个单词出现的概率
  p1Vect = p1Num / p1Denom# [1,2,3,5]/90->[1/90,...]
  # 类别0,即正常文档的[P(F1|C0),P(F2|C0),P(F3|C0),P(F4|C0),P(F5|C0)....]列表
  # 即 在0类别下,每个单词出现的概率
  p0Vect = p0Num / p0Denom
  return p0Vect, p1Vect, pAbusive
总结
以上为本文关于Python编程之基于概率论的分类方法:朴素贝叶斯的全部内容,希望对大家有所帮助。感兴趣的朋友可以参阅本站:Python内存管理方式和垃圾回收算法解析、python基础练习之几个简单的游戏、python使用邻接矩阵构造图代码示例等,有什么问题可以随时留言,小编会及时回复大家的。感谢朋友们对本站网站的支持!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















