


Python实现Apriori算法详解:原理、步骤与代码解析

本文深入解析Apriori算法原理及其在Python中的具体实现。文章详细阐述了通过逐层搜索生成频繁项集的过程,包括连接与剪枝两个核心步骤,并结合交易数据实例演示了C1至L1、L2至C3的迭代逻辑。最后提供了完整的Python代码示例,展示如何利用NumPy和itertools库计算支持度并筛选频繁项集,帮助读者掌握关联规则挖掘的核心技术。
本文将为您详细讲解Apriori算法的基础理论,并展示如何在Python中实现该算法。以下是完整的内容解析。
1. Apriori算法简介
Apriori算法是一种用于挖掘布尔关联规则频繁项集的算法。它利用频繁项集性质的先验知识,采用逐层搜索的迭代策略,即利用K-项集来探索(k+1)项集,从而穷尽数据集中的所有频繁项集。算法首先找到频繁1-项集集合L1,随后利用L1推导频繁2-项集集合L2,接着用L2寻找L3,直到无法找到新的频繁K-项集为止。需要注意的是,每个Lk的生成需要一次数据库扫描。关键性质在于:频繁项集的所有非空子集也必须是频繁的。Apriori性质通过减少搜索空间,显著提高了频繁项集逐层产生的效率。该算法主要由连接和剪枝两个步骤组成。
2. Apriori算法步骤
我们将通过一个具体实例来进行解释:下图展示了一个交易单,其中I1至I5代表5种不同的商品。接下来,我们将通过频繁项集合来找出关联规则。
假设设定的最小支持度阈值为2,这意味着支持度计数小于2的项集将被删除。
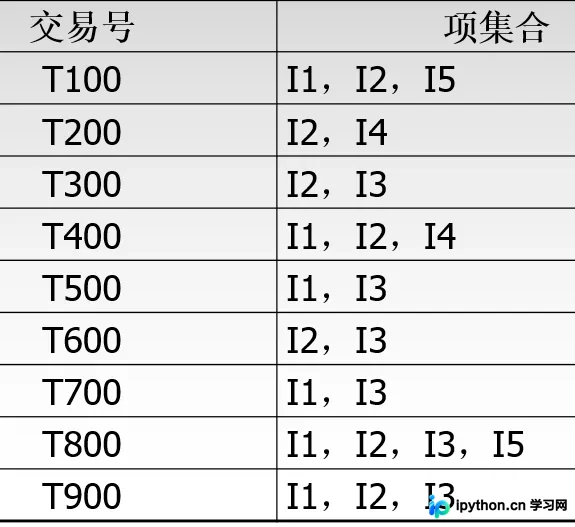
上表的第一行(即第一项交易)表示:I1、I2和I5被同时购买。
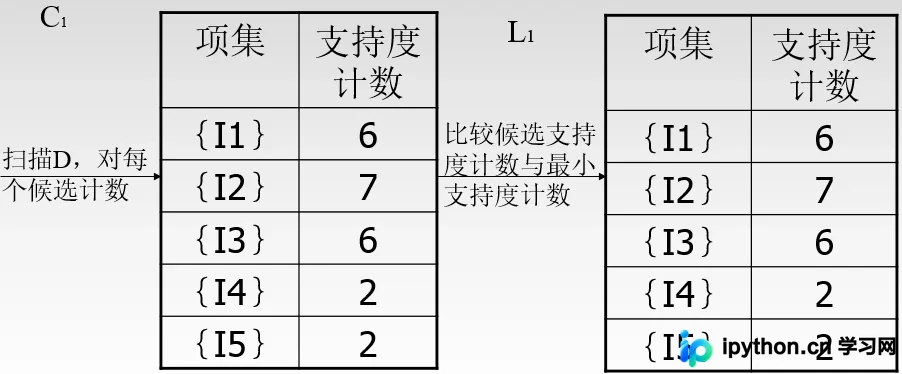
从C1到L1的过程:只需检查支持度是否高于阈值,然后进行取舍。在上图的C1中,所有项的支持度均大于2,因此L1中全部保留。
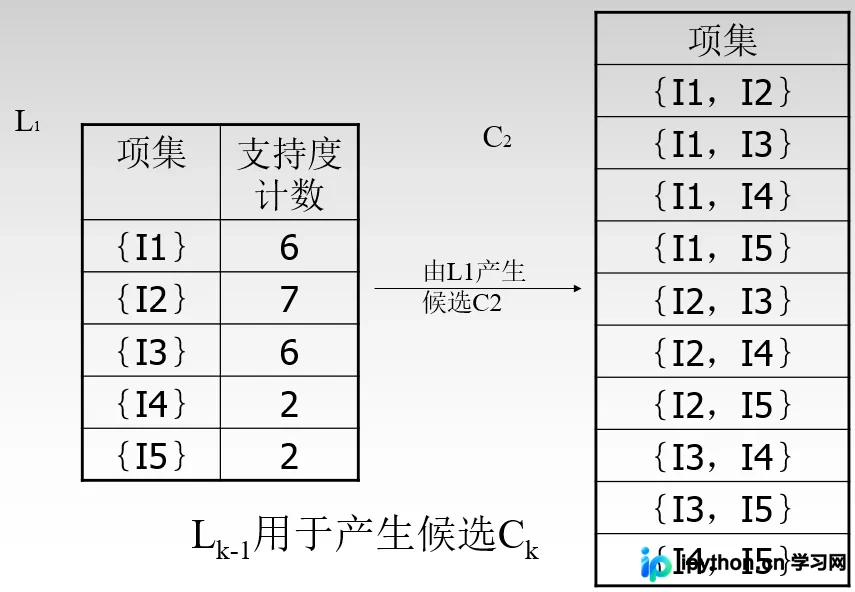
从L1到C2的过程分为三步:
首先遍历并生成L1中所有可能的组合,即(I1,I2)...(I4,I5)。对每一个生成的组合进行拆分,以确保频繁项集的所有非空子集也是频繁的。例如,对于组合(I1,I2),将其拆分为I1和I2。由于I1和I2在L1中均为频繁项,因此该组合被保留。对于剩余的C2项,根据原数据集进行支持度计数。
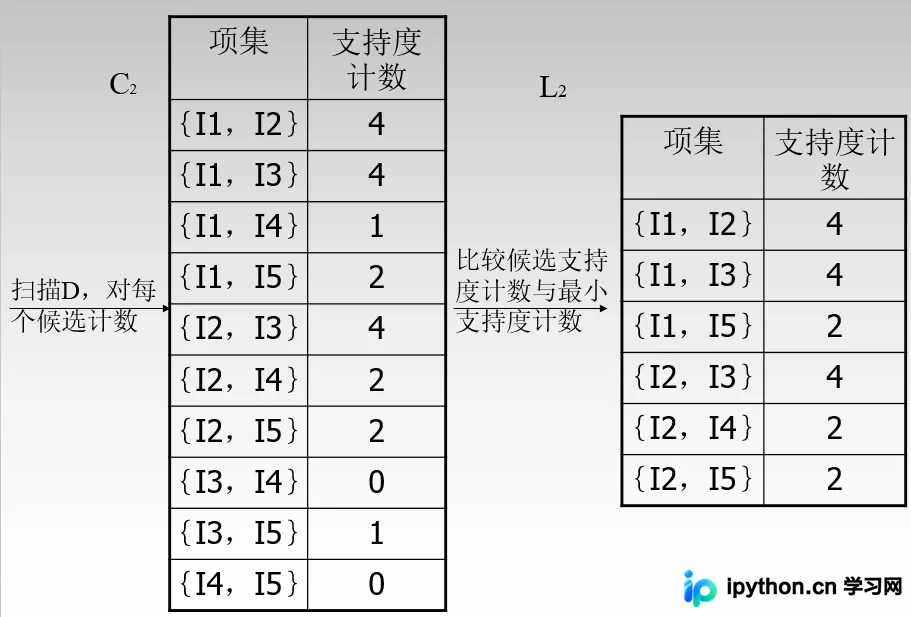
从C2到L2的过程:只需检查支持度是否高于阈值,然后进行取舍。
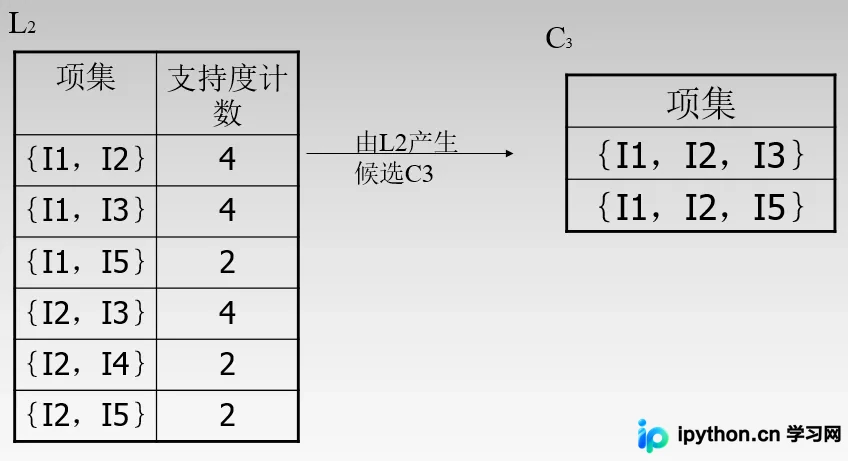
从L2到C3的过程:
遵循上述步骤。首先生成组合(1,2,3)、(1,2,4)、(1,2,5)等。为什么最后只剩下(1,2,3)和(1,2,5)呢?这是因为剪枝过程:将(1,2,4)拆分为(1,2)、(1,4)和(2,4)。然而,由于(1,4)在L2中不存在(即非频繁项),因此该组合被剪枝删除。随后对C3中剩余的组合进行计数,发现(1,2,3)和(1,2,5)的支持度均为2。迭代结束。
因此,算法的整体过程即为 Ck - Lk - Ck+1 的迭代过程:
3. Apriori算法实现
# -*- coding: utf-8 -*-
"""
Created on Sat Dec 9 15:33:45 2017
@author: LPS
"""
import numpy as np
from itertools import combinations # 迭代工具
data = [[1,2,5], [2,4], [2,3], [1,2,4], [1,3], [2,3], [1,3], [1,2,3,5], [1,2,3]]
minsp = 2
d = []
for i in range(len(data)):
 d.extend(data[i])
new_d = list(set(d))
def satisfy(s, s_new, k): # 更新确实存在的L
 e =[]
 ss_new =[]
 for i in range(len(s_new)):
  for j in combinations(s_new[i], k): # 迭代产生所有元素可能性组合
   e.append(list(j))
  if ([l for l in e if l not in s]) ==[] :
   ss_new.append(s_new[i])
  e = []
  return ss_new # 筛选满足条件的结果
def count(s_new): # 返回narray格式的C
 num = 0
 C = np.copy(s_new)
 C = np.column_stack((C, np.zeros(C.shape[0])))
 for i in range(len(s_new)):
  for j in range(len(data)):
   if ([l for l in s_new[i] if l not in data[j]]) ==[] :
    num = num+1
  C[i,-1] = num
  num = 0
 return C
def limit(L): # 删掉不满足阈值的C
 row = []
 for i in range(L.shape[0]):
  if L[i,-1] < minsp :
   row.append(i)
 L = np.delete(L, row, 0)
 return L
def generate(L, k): # 实现由L至C的转换
 s = []
 for i in range(L.shape[0]):
  s.append(list(L[i,:-1]))
 s_new = []
# L = L.delete(L, -1, 1)
# l = L.shape[1]
 for i in range(L.shape[0]-1):
  for j in range(i+1, L.shape[0]):
   if (L[j,-2]>L[i,-2]):
    t = list(np.copy(s[i]))
    t.append(L[j,-2])
    s_new.append(t) # s_new为列表

 s_new = satisfy(s, s_new, k)
 C = count(s_new)
 return C
# 初始的C与L
C = np.zeros([len(new_d), 2])
for i in range(len(new_d)):
 C[i:] = np.array([new_d[i], d.count(new_d[i])])
L = np.copy(C)
L = limit(L)
# 开始迭代
k = 1
while (np.max(L[:,-1]) > minsp):
 C = generate(L, k) # 由L产生C
 L = limit(C)  # 由C产生L
 k = k+1
# 对最终结果去重复
print((list(set([tuple(t) for t in L])))
# 结果为 [(1.0, 2.0, 3.0, 2.0), (1.0, 2.0, 5.0, 2.0)]
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















