


Python蒙特卡洛法计算定积分详解:从基础到重要抽样法

本文详解利用Python通过蒙特卡洛法计算定积分。首先介绍基于均匀采样的基础算法,分析采样数量对精度的影响。随后引入重要抽样法,通过选择与目标函数形状相近的概率密度函数来降低方差,从而提高计算精度。代码示例展示了如何对比传统方法与重要抽样法的效果,适用于需要高精度数值积分的场景。
回顾考研时期,若能掌握此类工具,定积分的计算将变得轻松许多。当然,这并非当时的真实情况,但它确实启发了一种新思路:利用编程语言处理更复杂的数学问题。接下来进入具体技术环节。
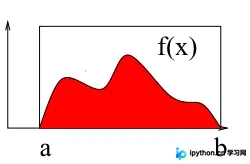
如上图所示,计算区间[a, b]上f(x)的积分,本质是求解曲线与X轴围成的红色区域面积。本文将以区间[2, 3]上的定积分∫(x²+4*x*sin(x))dx为例,演示蒙特卡洛法的计算过程。
# -*- coding: utf-8 -*-
import numpy as np
import matplotlib.pyplot as plt

def f(x):
  return x**2 + 4*x*np.sin(x)
def intf(x):
  return x**3/3.0+4.0*np.sin(x) - 4.0*x*np.cos(x)
a = 2;
b = 3;
# use N draws
N= 10000
X = np.random.uniform(low=a, high=b, size=N) # N values uniformly drawn from a to b
Y =f(X)  # CALCULATE THE f(x)
# 蒙特卡洛法计算定积分:面积=宽度*平均高度
Imc= (b-a) * np.sum(Y)/ N;
exactval=intf(b)-intf(a)
print "Monte Carlo estimation=",Imc, "Exact number=", intf(b)-intf(a)
# --How does the accuracy depends on the number of points(samples)? Lets try the same 1-D integral
# The Monte Carlo methods yield approximate answers whose accuracy depends on the number of draws.
Imc=np.zeros(1000)
Na = np.linspace(0,1000,1000)
exactval= intf(b)-intf(a)
for N in np.arange(0,1000):
  X = np.random.uniform(low=a, high=b, size=N) # N values uniformly drawn from a to b
  Y =f(X)  # CALCULATE THE f(x)
  Imc[N]= (b-a) * np.sum(Y)/ N;
plt.plot(Na[10:],np.sqrt((Imc[10:]-exactval)**2), alpha=0.7)
plt.plot(Na[10:], 1/np.sqrt(Na[10:]), 'r')
plt.xlabel("N")
plt.ylabel("sqrt((Imc-ExactValue)$^2$)")
plt.show()
>>>
Monte Carlo estimation= 11.8181144118 Exact number= 11.8113589251
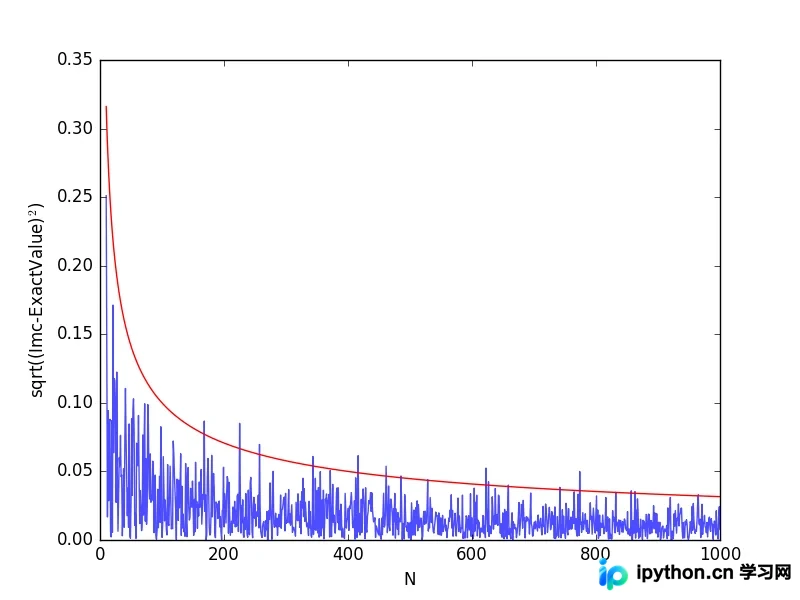
从上图可见,随着采样点数的增加,计算误差逐渐缩小。提升模拟结果精确度主要有两个方向:一是增加试验次数N;二是降低方差σ²。单纯增加试验次数会导致计算时间显著增加,并非高效方案。下文将介绍重要抽样法,旨在通过减小方差来提升积分计算的精度。
重要抽样法的核心在于,它不直接从原始过程的概率分布中抽样,而是从修改后的概率分布中进行抽样,使得对模拟结果影响显著的事件更频繁出现,从而提升抽样效率,减少在无关紧要事件上的计算耗时。例如,在区间[a, b]上求解g(x)的积分,若采用均匀抽样,函数值较小的区间产生的抽样点与函数值较大的区间产生的抽样点数量相近,效率显然较低。我们可以将抽样概率密度函数调整为f(x),使其形状与g(x)相近,从而确保对积分贡献较大的抽样值出现概率高于贡献较小的值。此时,积分运算可改写为:
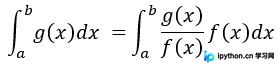
其中x是按照概率密度f(x)抽样获得的随机变量,在区间[a, b]内应满足:
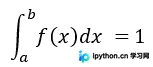
因此,积分值I可以视为随机变量 Y = g(x)/f(x)的期望,式中xi是服从概率密度f(x)的采样点。
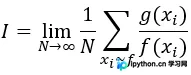
下面的例子采用一个正态分布函数f(x)来近似g(x)=sin(x)*x,并依据正态分布选取采样值,计算区间[0, pi]上的积分∫g(x)dx。
# -*- coding: utf-8 -*-
# Example: Calculate ∫sin(x)xdx

# The function has a shape that is similar to Gaussian and therefore
# we choose here a Gaussian as importance sampling distribution.
from scipy import stats
from scipy.stats import norm
import numpy as np
import matplotlib.pyplot as plt
mu = 2;
sig =.7;
f = lambda x: np.sin(x)*x
infun = lambda x: np.sin(x)-x*np.cos(x)
p = lambda x: (1/np.sqrt(2*np.pi*sig**2))*np.exp(-(x-mu)**2/(2.0*sig**2))
normfun = lambda x: norm.cdf(x-mu, scale=sig)

plt.figure(figsize=(18,8)) # set the figure size
# range of integration
xmax =np.pi
xmin =0
# Number of draws
N =1000
# Just want to plot the function
x=np.linspace(xmin, xmax, 1000)
plt.subplot(1,2,1)
plt.plot(x, f(x), 'b', label=u'Original $x\sin(x)$')
plt.plot(x, p(x), 'r', label=u'Importance Sampling Function: Normal')
plt.xlabel('x')
plt.legend()
# =============================================
# EXACT SOLUTION
# =============================================
Iexact = infun(xmax)-infun(xmin)
print Iexact
# ============================================
# VANILLA MONTE CARLO
# ============================================
Ivmc = np.zeros(1000)
for k in np.arange(0,1000):
  x = np.random.uniform(low=xmin, high=xmax, size=N)
  Ivmc[k] = (xmax-xmin)*np.mean(f(x))
# ============================================
# IMPORTANCE SAMPLING
# ============================================
# CHOOSE Gaussian so it similar to the original functions

# Importance sampling: choose the random points so that
# more points are chosen around the peak, less where the integrand is small.
Iis = np.zeros(1000)
for k in np.arange(0,1000):
  # DRAW FROM THE GAUSSIAN: xis~N(mu,sig^2)
  xis = mu + sig*np.random.randn(N,1);
  xis = xis[ (xis<xmax) & (xis>xmin)] ;
  # normalization for gaussian from 0..pi
  normal = normfun(np.pi)-normfun(0)   # 注意:概率密度函数在采样区间[0 pi]上的积分需要等于1
  Iis[k] =np.mean(f(xis)/p(xis))*normal  # 因此,此处需要乘一个系数即p(x)在[0 pi]上的积分
plt.subplot(1,2,2)
plt.hist(Iis,30, histtype='step', label=u'Importance Sampling');
plt.hist(Ivmc, 30, color='r',histtype='step', label=u'Vanilla MC');
plt.vlines(np.pi, 0, 100, color='g', linestyle='dashed')
plt.legend()
plt.show()
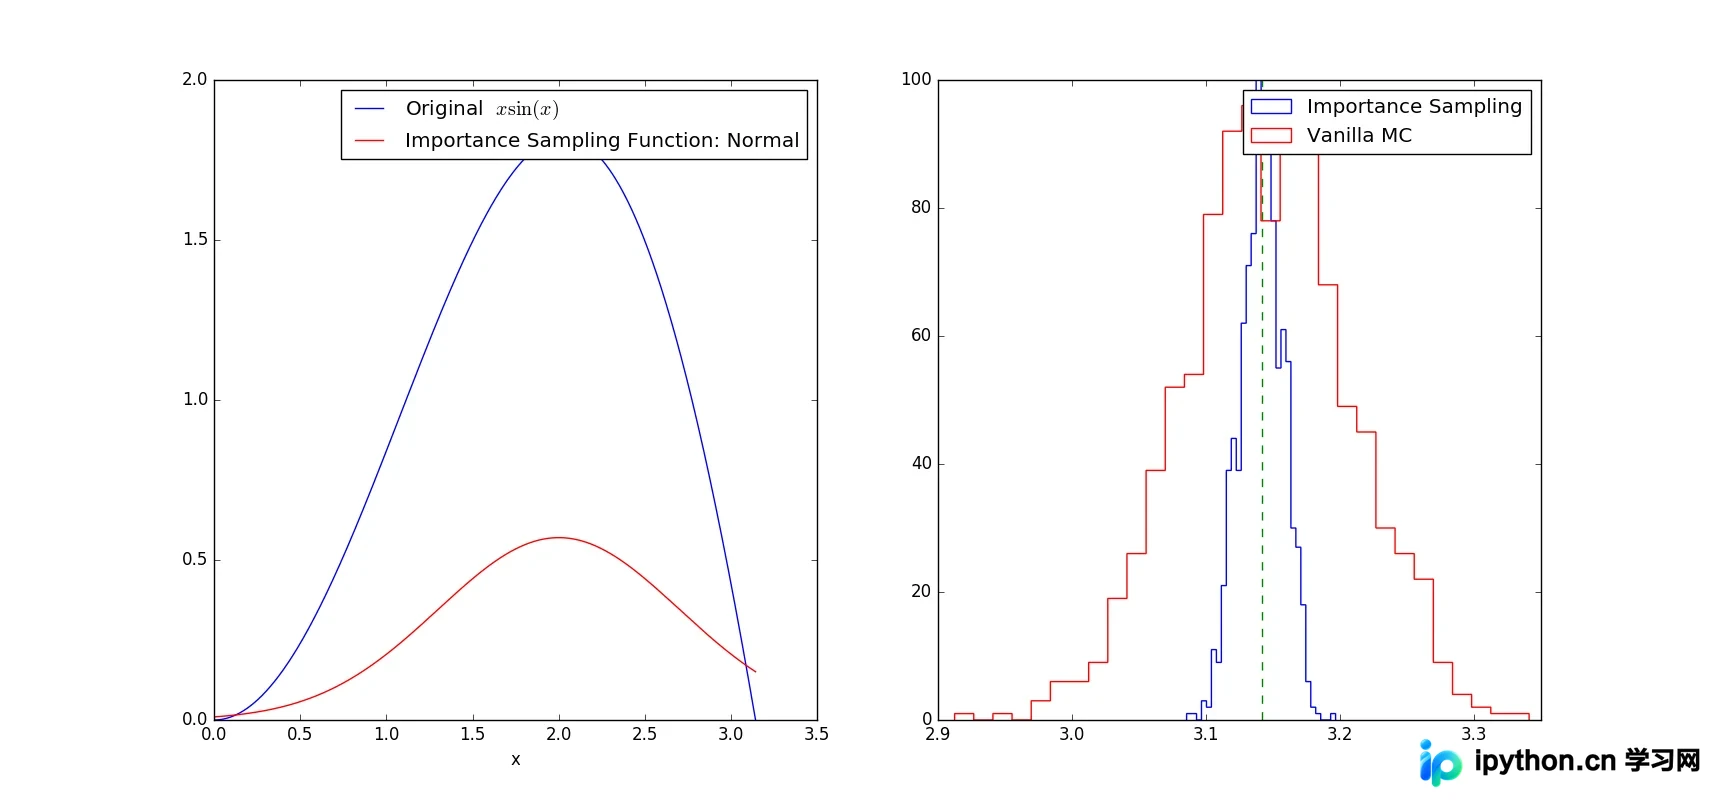
从图中可以看出,曲线sin(x)*x的形状与正态分布曲线形状相近,因此在曲线峰值处的采样点数目会比曲线上位置较低的地方更多。精确计算结果为pi。从右侧图表可见,两种方法均计算定积分1000次,结果集中在精确值pi=3.1415附近最多,离精确值越远数量越少,符合常规分布。然而,采用传统方法(红色直方图)计算出的积分值方差明显大于采用重要抽样法(蓝色直方图)的结果。因此,使用重要抽样法可以有效降低方差,提高精度。需注意:函数f(x)的选择会影响计算结果的精度,当选择的函数f(x)与g(x)差异较大时,计算结果的方差也会随之增大。
总结
以上就是本文关于python编程通过蒙特卡洛法计算定积分详解的全部内容,希望对大家有所帮助。感兴趣的朋友可以继续参阅本站:
python实现机械分词之逆向最大匹配算法代码示例
K-近邻算法的python实现代码分享
Python实现字符串匹配算法代码示例
如有不足之处,欢迎留言指出。感谢朋友们对本站的支持!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















