


Python统计数组元素频次:从暴力排序到桶计数法

本文介绍在Python中统计数组元素出现次数的两种方法。首先分析基于排序的暴力解法,指出其逻辑复杂且效率较低。随后重点讲解利用“桶”思想的优化方案,通过固定长度数组直接映射元素频次,实现O(N)时间复杂度。最后延伸介绍基于桶统计结果的桶排序实现,展示如何将频次统计与排序结合,适用于元素范围有限的场景。
题目要求:
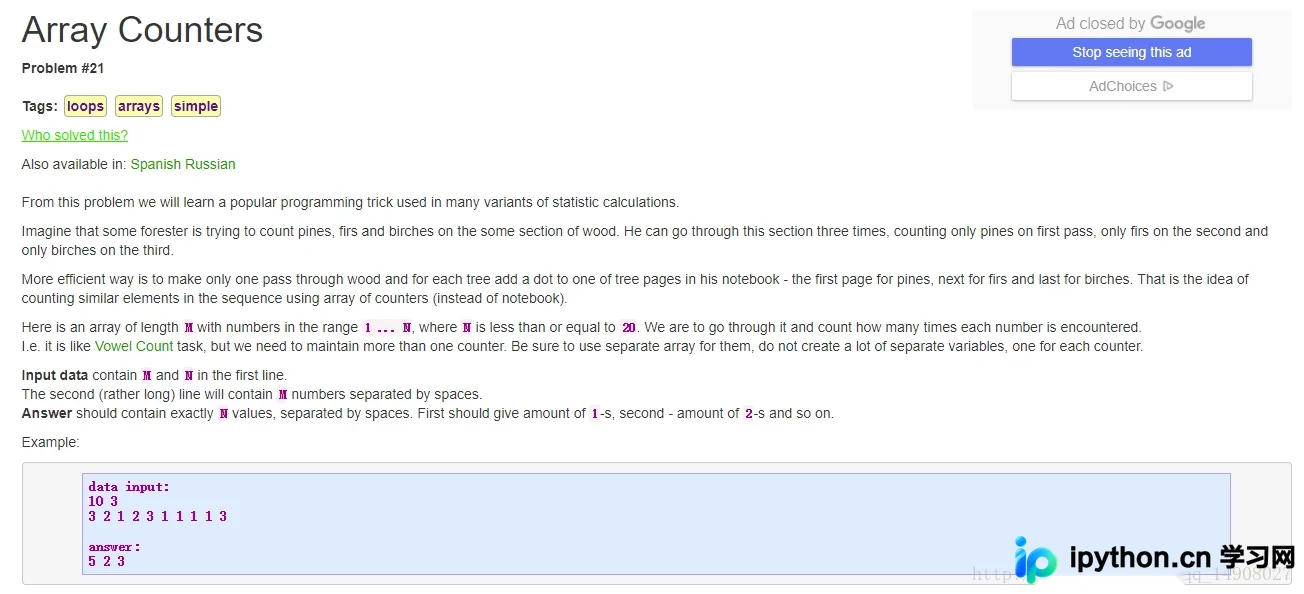
解法一:通过比较元素是否相等进行统计
思路说明:
这是大多数人最先想到的直观方法。首先对数组进行从小到大排序,然后初始化一个变量 min=0(用于记录当前相同数字组的起始索引)。接着遍历排序后的数组,当发现相邻两个元素不相等时,计算当前组的数量 count = i - min,并将当前索引 i 赋值给 min 作为下一组的起始点。当遍历到最后一个元素时,需额外计算最后一组的数量,即数组长度减去上一轮循环结束时的 min 值(此时 min 指向最后一组第一个元素的索引)。尽管逻辑可行,但这种解法因效率较低通常不被面试官青睐。
(m, n) = input().split()
ar = [int(x) for x in input().split()]
res = []
ar.sort()
min = 0
for i in range(1,len(ar)) :
  if ar[i-1] != ar[i]:
    count = i - min
    min = i
    res.append(str(count))
  if i == (len(ar)-1):
    count = len(ar)-min
    res.append(str(count))
print(' '.join(res))
解法二:利用桶(Bucket)思想进行计算
思路:获取输入数组后,首先确定数组长度。根据题目约束 N<=20,可知数组中的元素值不会超过 20。因此,我们可以定义一个长度为 20 的一维数组 res,并将其所有元素初始化为 0,这足以容纳所有可能的计数结果。先展示核心代码,再进行详细解析。
(m, n) = input().split()
ar = [int(x) for x in input().split()]
result = []
res = [0 for x in range(20)]
for a in ar:
  res[a-1]+=1
for r in res:
  if r != 0:
    result.append(str(r))
print(' '.join(result))
上述代码的核心逻辑仅包含以下两行关键操作:
for a in ar:
  res[a-1]+=1
我们遍历输入数组 ar 中的每一个元素 a,使用 res[a] 的值来代表数字 a 出现的次数。在每次循环中,我们都能找到对应的“桶”来存放该元素,只需将该桶的计数值加 1 即可。例如,当 ar = [2, 2, 1, 4] 时:
循环1:
a = 2
res[2] = 0+1 = 1
循环2:
a = 2
res[2] = 1 +1 =2
循环3:
a = 1
res[1] = 0+1 = 1
循环4:
a = 4
res[4] = 0+1 = 1
这样我们得到的 res = [0, 1 ,2 ,0 ,1 ,0 ····]
延伸应用:桶排序
基于上述思路,我们得到了一个新的数组 res。仔细分析可知,res 中索引 i 处的值代表数字 i 出现的次数(例如 res[1]=1 表示 1 出现 1 次,res[2]=2 表示 2 出现 2 次)。利用数组索引天然有序的特性,我们可以衍生出桶排序的概念。忽略值为 0 的情况,使用两层循环:外层循环遍历 res 的长度 len(res),索引为 i;内层循环执行 res[i] 次,索引为 j。这意味着如果某个数字出现 k 次,就输出 k 次该数字。例如 1 出现 1 次则输出 1 个 1,2 出现 2 次则输出 2 个 2,4 出现 1 次则输出 1 个 4。扩展代码如下:
#省略上述代码
for i in range(len(res)):
  if res[i] != 0:
    for j in range(res[i]):
      result.append(i)
print(result)
执行结果如下:
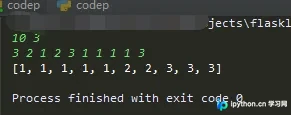
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















