


Python实现KNN分类算法:原理、代码与鸢尾花数据集测试

本文详细解析Python中KNN(K-Nearest Neighbor)分类算法的实现原理与代码。通过鸢尾花数据集,演示如何加载数据、计算欧拉与曼哈顿距离,并完成分类预测。文章包含完整Python代码示例及测试集结果分析,探讨算法鲁棒性与计算开销,适合机器学习初学者参考。
本文分享了使用Python实现KNN分类算法的具体代码,供读者参考学习。
KNN(K-Nearest Neighbor,K个最邻近样本节点)是机器学习中较为简单的分类算法之一。在分类前,KNN分类器会读取大量带有分类标签的样本数据作为参照。当对类别未知的样本进行分类时,算法会计算当前样本与所有参照样本的差异。这种差异通过数据点在特征多维空间中的距离来衡量:距离越近,样本间差异越小,属于同一类别的可能性越大。KNN算法基于此原理,计算待预测样本与参照空间中所有样本的距离,找出距离最近的K个参照样本,统计其中占比最多的类别,并将其作为预测结果。
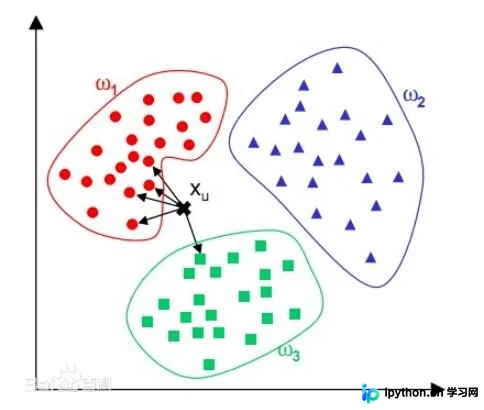
KNN模型结构简单,不涉及复杂的模型训练过程,但每次预测都需要计算该点与所有已知点的距离。因此,随着参照样本集数量的增加,KNN分类器的计算开销会呈比例增长,这使得KNN不太适合样本数量极少的数据集。尽管后续出现了多种改进算法,旨在提高速率或准确率,但均基于“距离越近,相似性越大”这一核心原则。本文利用Python实现了KNN的最原始版本,采用机器学习中常用的鸢尾花数据集,并在原数据集中添加了少量噪声数据,以测试KNN算法的鲁棒性。
本文使用的数据集为鸢尾花数据集,下载地址见。
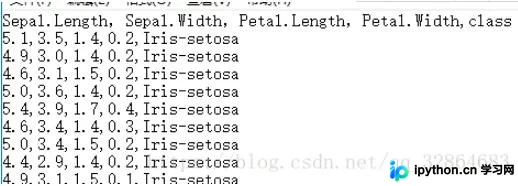
训练集包含90个数据样本,分为2类,每类45个数据,每个数据包含4个属性。
属性定义如下: Sepal.Length(花萼长度),单位为cm; Sepal.Width(花萼宽度),单位为cm; Petal.Length(花瓣长度),单位为cm; Petal.Width(花瓣宽度),单位为cm。
分类种类包括:Iris Setosa(山鸢尾)、Iris Versicolour(杂色鸢尾)。 作者此前主要使用C++,近期开始学习Python,此次通过实现KNN算法进行练习。具体代码如下:
#coding=utf-8
import math
#定义鸢尾花的数据类
class Iris:
 data=[]
 label=[]
 pass
#定义一个读取莺尾花数据集的函数
def load_dataset(filename="Iris_train.txt"):
 f=open(filename)
 line=f.readline().strip()
 propty=line.split(',')#属性名
 dataset=[]#保存每一个样本的数据信息
 label=[]#保存样本的标签
 while line:
 line=f.readline().strip()
 if(not line):
 break
 temp=line.split(',')
 content=[]
 for i in temp[0:-1]:
 content.append(float(i))
 dataset.append(content)
 label.append(temp[-1])
 total=Iris()
 total.data=dataset
 total.label=label
 return total#返回数据集

#定义一个Knn分类器类
class KnnClassifier:
 def __init__(self,k,type="Euler"):#初始化的时候定义正整数K和距离计算方式
 self.k=k
 self.type=type
 self.dataloaded=False
 def load_traindata(self,traindata):#加载数据集
 self.data=traindata.data
 self.label=traindata.label
 self.label_set=set(traindata.label)
 self.dataloaded=True#是否加载数据集的标记

 def Euler_dist(self,x,y):# 欧拉距离计算方法,x、y都是向量
 sum=0
 for i,j in zip(x,y):
 sum+=math.sqrt((i-j)**2)
 return sum
 def Manhattan_dist(self,x,y):#曼哈顿距离计算方法,x、y都是向量
 sum=0
 for i,j in zip(x,y):
 sum+=abs(i-j)
 return sum
 def predict(self,temp):#预测函数,读入一个预测样本的数据,temp是一个向量
 if(not self.dataloaded):#判断是否有训练数据
 print "No train_data load in"
 return
 distance_and_label=[]
 if(self.type=="Euler"):#判断距离计算方式,欧拉距离或者曼哈顿距离
 for i,j in zip(self.data,self.label):
 dist=self.Euler_dist(temp,i)
 distance_and_label.append([dist,j])
 else:
 if(self.type=="Manhattan"):
 for i,j in zip(self.data,self.label):
 dist=self.Manhattan_dist(temp,i)
 distance_and_label.append([dist,j])
 else:
 print "type choice error"
 #获取K个最邻近的样本的距离和类别标签
 neighborhood=sorted(distance_and_label,cmp=lambda x,y : cmp(x[0],y[0]))[0:self.k]
 neighborhood_class=[]
 for i in neighborhood:
 neighborhood_class.append(i[1])
 class_set=set(neighborhood_class)
 neighborhood_class_count=[]
 print "In k nearest neighborhoods:"
 #统计该K个最邻近点中各个类别的个数
 for i in class_set:
 a=neighborhood_class.count(i)
 neighborhood_class_count.append([i,a])
 print "class: ",i," count: ",a
 result=sorted(neighborhood_class_count,cmp=lambda x,y : cmp(x[1],y[1]))[-1][0]
 print "result: ",result
 return result#返回预测的类别

if __name__ == '__main__':
 traindata=load_dataset()#training data
 testdata=load_dataset("Iris_test.txt")#testing data
 #新建一个Knn分类器的K为20,默认为欧拉距离计算方式
 kc=KnnClassifier(20)
 kc.load_traindata(traindata)
 predict_result=[]
 #预测测试集testdata中所有待预测样本的结果
 for i,j in zip(testdata.data,testdata.label):
 predict_result.append([i,kc.predict(i),j])
 correct_count=0
 #将预测结果和正确结果进行比对,计算该次预测的准确率
 for i in predict_result:
 if(i[1]==i[2]):
 correct_count+=1
 ratio=float(correct_count)/len(predict_result)
 print "correct predicting ratio",ratio
测试集中11个待测样本点的分类结果如下:
In k nearest neighborhoods:
class: Iris-setosa count: 20
result: Iris-setosa
In k nearest neighborhoods:
class: Iris-setosa count: 20
result: Iris-setosa
In k nearest neighborhoods:
class: Iris-setosa count: 20
result: Iris-setosa
In k nearest neighborhoods:
class: Iris-setosa count: 20
result: Iris-setosa
In k nearest neighborhoods:
class: Iris-setosa count: 20
result: Iris-setosa
In k nearest neighborhoods:
class: Iris-versicolor count: 20
result: Iris-versicolor
In k nearest neighborhoods:
class: Iris-versicolor count: 20
result: Iris-versicolor
In k nearest neighborhoods:
class: Iris-versicolor count: 20
result: Iris-versicolor
In k nearest neighborhoods:
class: Iris-versicolor count: 20
result: Iris-versicolor
In k nearest neighborhoods:
class: Iris-versicolor count: 20
result: Iris-versicolor
In k nearest neighborhoods:
class: Iris-setosa count: 18
class: Iris-versicolor count: 2
result: Iris-setosa
correct predicting ratio 0.909090909091
KNN算法中的距离计算有多种方法,适用于不同的数据集。本代码仅实现了欧拉距离(Euler distance)和曼哈顿距离(Manhattan distance)两种计算方式。由于测试集数据是从原数据集中抽取的,数据量较小,结果可能无法充分体现KNN的性能,因此程序运行结果仅供参考。
以上就是本文的全部内容,希望对大家的学习有所帮助,也欢迎大家继续支持本站。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















