


Python线性回归实战:从理论到模型评估与变量筛选

本文详解Python线性回归实战,涵盖一元及多元回归理论、误差项假设验证及参数求解方法(矩估计、最小二乘、极大似然)。通过武汉市房价预测案例,演示利用Python进行相关性分析、变量筛选及模型评估,重点解析R-squared、F检验、t检验及DW值等关键指标的实际应用。
一、线性回归的理论
1)线性回归的基本概念
线性回归属于有监督学习算法,旨在描述自变量与因变量之间的线性相关关系,具体可细分为一元线性回归和多元线性回归。其中,一元线性回归仅涉及一个自变量与一个因变量,可视作多元线性回归的特殊情形。该算法既可用于预测也可用于分类,通过回归方程能够直观展示自变量对因变量的影响程度。
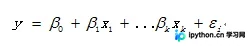
线性回归模型的构建基于以下核心假设: (1) 误差项的均值为0,且误差项与解释变量之间不存在线性相关关系
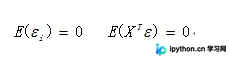
(2) 误差项遵循独立同分布原则,即各误差项相互独立且方差保持一致。
(3) 解释变量之间保持线性无关。
(4) 正态性假设,即误差项服从正态分布。
上述假设为建立回归模型的基础条件,因此在得出回归结果后需逐一进行验证。若发现不满足特定假定,则必须对模型进行相应修正。
2) 模型的参数求解
(1)矩估计
该方法通常利用样本矩来推断总体参数,例如常用样本的一阶原点矩来估计总体均值,利用二阶中心矩来估计总体方差。
(2)最小二乘估计
最小二乘估计主要适用于因变量为连续型数据的情况,其中最常用的是普通最小二乘法(Ordinary Least Square,OLS)。其核心原理是选择回归模型,使得所有观测值的残差平方和降至最低。设预测值为,对应实际值为,残差平方和为,最小二乘估计旨在求解使L最小的参数值。对于线性回归而言,求得的参数值是唯一的。
(3)极大似然估计
极大似然估计基于概率思想,要求已知样本的概率分布。其参数估计值旨在使大量样本出现的概率最大化,通过似然函数进行度量。似然函数定义为各样本密度函数的乘积,为便于求解,通常对其取对数并加负号转化为求极小值问题,从而得到参数的估计结果。
3)模型的优缺点
优点:结果易于理解,计算过程不复杂。
缺点:对非线性数据的拟合效果不佳。
二、用Python实现线性回归的小例子
本例数据来源于网络爬虫,以武汉市商品房价格为因变量,选取几个相关关键词的百度指数搜索量作为自变量。
鉴于本文自变量多达98个,首要任务是进行变量筛选。首先通过相关系数矩阵剔除不相关变量,依据Pearson相关系数矩阵进行选取。通常选取相关系数大于0.3的变量进行回归分析,但由于本文变量较多,采取先手动筛选再利用相关系数选取的策略,最终确定选取相关系数大于0.55的变量进行回归分析。
经相关系数分析,最终选取8个变量进行后续分析,相关Python代码如下:
# -*- coding: utf-8 -*-
#### Required Packages
import sys
reload(sys)
sys.setdefaultencoding('utf-8')
import matplotlib.pyplot as plt
import numpy as np
import pandas as pd
import statsmodels.api as sm
data = pd.read_csv('Hdata.csv')
print data
dataset = np.array(data)
######相关性分析
X = dataset[:,1:98]
y = dataset[:,0]
cor = np.corrcoef(dataset,rowvar=0)[:,0]
######输出相关矩阵的第一列
print cor
#######筛选后的数据读取
data1 = pd.read_csv('H1data.csv')
dataset1 = np.array(data)
######筛选后的变量######
X1 = dataset1[:,1:8]
Y1 = dataset1[:,0]
est = sm.OLS(Y1,X1).fit()
print est.summary()
线性回归的具体结果如下所示:
OLS RegressionResults
=======================================================================
Dep. Variable:           y  R-squared:            0.978
Model:              OLS  Adj. R-squared:         0.974
Method:         Least Squares F-statistic:          287.5
Date:        Sat, 08 Apr 2017  Prob (F-statistic):      9.35e-36
Time:            15:15:14  Log-Likelihood:        -442.82
No. Observations:         53  AIC:               899.6
Df Residuals:           46  BIC:               913.4
Df Model:              7
Covariance Type:      nonrobust
=======================================================================
         coef  std err     t   P>|t|   [95.0% Conf. Int.]
-----------------------------------------------------------------------
x1      -0.3691   0.494  -0.747   0.0459    -1.364   0.626
x2       0.3249   0.353   0.920   0.0362    -0.386   1.036
x3       1.0987   0.837   1.312   0.0196    -0.587   2.784
x4       0.7613   0.790   0.964   0.0340    -0.829   2.351
x5      -1.5766   1.099  -1.435   0.0158    -3.789   0.636
x6      -0.1572   1.077  -0.146   0.0885    -2.325   2.011
x7       3.2003   1.603   1.997   0.052    -0.026   6.427
=======================================================================
Omnibus:            0.413  Durbin-Watson:          1.748
Prob(Omnibus):         0.814  Jarque-Bera (JB):        0.100
Skew:              0.097  Prob(JB):            0.951
Kurtosis:            3.089  Cond. No.             95.5
=======================================================================
从回归分析结果可见,模型的拟合优度R-squared为0.978,表明模型拟合效果良好,可据此大小判定拟合效果的优劣。模型整体显著性可通过F统计量判断,结果显示F统计量对应的P值显著小于0.05(0.05为显著性水平,也可选0.01),说明模型整体显著。F检验通过仅意味着被解释变量可由这些解释变量解释,并不代表每个解释变量均显著。各变量的显著性需查看t检验统计量,若t检验对应的P值小于0.05(0.01或0.1亦可,视具体情况而定,一般取0.05)则视为显著。从结果看,X6和X7变量的P值大于0.05,即这两个变量对被解释变量的影响不显著,应予剔除。但若仅关注预测问题,可不剔除;若需研究解释变量对被解释变量的影响程度,则需进一步研究。接着查看DW值,其值为1.748,表明模型不存在自相关性。再看JB检验统计量,该统计量用于检验正态性假设,JB值对应的P值为0.951,显著大于0.05,可认为模型满足正态性假设。关于参数的实际意义,本文不再赘述。
对于DW值判断相关性的依据如下:
当DW=0时,残差序列存在完全正自相关,
当DW=(0,2)时,残差序列存在正自相关,
当DW=2时,残差序列无自相关,
当DW=(2,4)时,残差序列存在负自相关,
当DW=4时,残差序列存在完全负自相关。
建立模型的一般步骤简述如下:
(1) 根据数据表现形式选取合适的模型
(2) 对选取的模型选用适用的参数估计方法
(3) 对参数结果进行检验
(4) 对结果进行解释
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















