


Python抓取网络小说并生成Kindle可读文本的实战代码

本文分享使用Python抓取网络小说的完整代码与思路。针对网页编码(如GBK与gb18030)导致的解码错误提供解决方案,利用BeautifulSoup提取标题、正文及下一章链接,实现自动循环抓取。代码包含主函数、URL解析及文件写入逻辑,最终生成适合Kindle导入的TXT文本,并建议配合epubBuilder进行二次排版以优化阅读体验。
阅读网络小说时,用户通常习惯先积累一定章节,再导入Kindle等设备离线阅读。当积累章节较多时,单纯依靠手动复制粘贴效率极低且过时,因此本文介绍一种自动化获取方案。
选择Python作为实现工具,主要因其具备强大的文本处理能力和完善的网络支持,且拥有丰富的第三方库可供调用,无需重复造轮子。相较于C语言,Python在开发效率和便捷性上优势明显,实际体验后更能体会这一点。
在编写代码前,需先分析目标网页的结构。
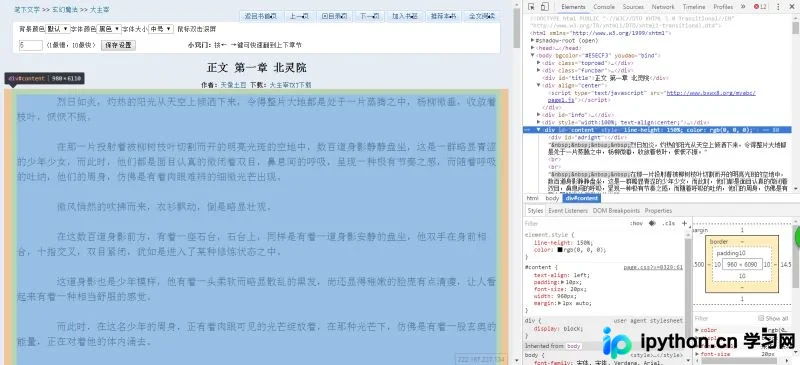
抓取过程主要需要提取以下三个关键信息:
- 文章的标题,对应HTML元素为<div id="title">正文 第一章 北灵院</div>。
- 文章的正文内容,对应HTML元素为<div id="content" style="line-height: 150%; color: rgb(0, 0, 0);">。
- 下一章的链接地址,对应HTML元素为<a href="11455541.html" rel="external nofollow" >下一页</a>。
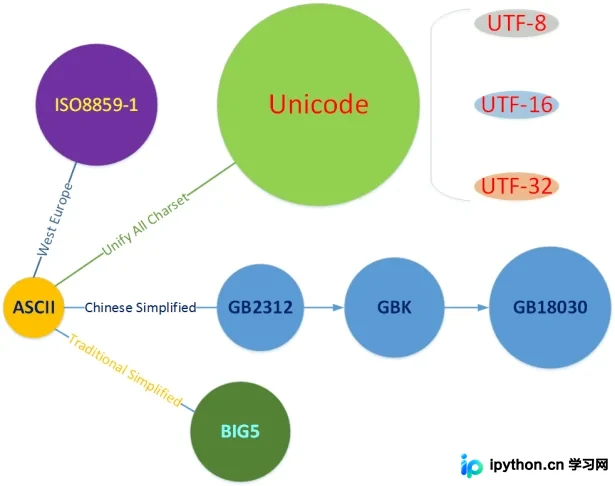
此外,必须注意网页的字符编码。该示例网页采用GBK编码,但在实际运行中直接使用GBK解码可能会引发网页解码错误。
错误信息表现为:UnicodeDecodeError: ‘gbk' codec can't decode bytes in position 2-3: illegal multibyte sequence。
为解决此问题,建议改用gb18030编码进行解码,即可成功解决问题。这通常是因为修仙类网络小说中包含大量生僻或特殊字符,GBK编码无法完全覆盖,而gb18030作为更全面的字符集能够兼容这些内容,体现了字符编码标准的差异。
以下是完整的源代码实现。
考虑到读者对代码的需求,这里直接提供核心代码部分。
程序的主函数逻辑如下。
#主函数
if __name__ == '__main__':
  global numChapter
  global NOVERL

  NOVERL = '大主宰.txt'
  #NOVERL = '择天记.txt'
  NOVERL = '武动乾坤.txt'


  if(NOVERL == '大主宰.txt'):
    textStartURL = 'http://www.bxwx8.org/b/62/62724/11455540.html';#大主宰第一章的URL
    textStartURL = 'http://www.bxwx8.org/b/62/62724/28019405.html';#第一千两百三十七章 鬼大师
  else:
    textStartURL = 'http://www.bxwx8.org/b/98/98289/17069215.html';#择天记第一章URL
    textStartURL = 'http://www.bxwx8.org/b/98/98289/28088874.html';#择天记第七十八章 合剑术

    textStartURL = 'http://www.bxwx8.org/b/35/35282/5839471.html';#武动乾坤第一章
    #textStartURL = 'http://www.bxwx8.org/b/35/35282/7620539.html';#武动乾坤
  nextURL = textStartURL;

  isEnd = False

  f = open(NOVERL, 'w', encoding='utf-8')
  f.close()

  numChapter = 0;
  while(not isEnd):
    nextURL,isEnd = findNextTextURL(nextURL)

  print('end of capture!')
  print('获取到 ' + str(numChapter) + ' 章')
核心功能包括获取小说正文内容以及解析下一章的URL地址。
#找到 下一章节的URL
#获取小说内容
def findNextTextURL(url):
  global numChapter
  global NOVERL
  #如果nextURL == endURL 则返回false

  if(NOVERL == '大主宰.txt'):
    endURL = 'http://www.bxwx8.org/b/62/62724/index.html'#大主宰
    headURL = 'http://www.bxwx8.org/b/62/62724/'#大主宰
  else:
    endURL = 'http://www.bxwx8.org/b/98/98289/index.html'#择天记
    headURL = 'http://www.bxwx8.org/b/98/98289/'#择天记

    endURL = 'http://www.bxwx8.org/b/35/35282/index.html'#武动乾坤
    headURL = 'http://www.bxwx8.org/b/35/35282/'#武动乾坤

  isEnd = False


  resp   = urllib.request.urlopen(url)

  #处理的字符的确是gbk的,但是其中夹杂的部分特殊字符,
  #是gbk编码中所没有的如果有些特殊字符是GB18030中有的,但是是gbk中没有的。
  #则用gbk去解码,去所不支持的字符,也比如会出错。
  #所以,此种情况,可以尝试用和当前编码(gbk)所兼容的但所包含字符更多的编码(gb18030)去解码,或许就可以了。
  #allHtml = resp.read().decode('gbk')#
  allHtml = resp.read().decode('gb18030')#

  textSoup = BeautifulSoup(allHtml)

  #章节名
  strChapter = textSoup.find(id='title').getText().split(r'【')[0]
  strChapter = strChapter.split(r'(')[0]
  strChapter = strChapter.replace('正文 ','') + '\n'
  numChapter = numChapter + 1
  strID = '#' + str(numChapter) + '-'
  strChapter = strID + strChapter

  strChapter = strChapter + '\n------------------------------\n' + url + '\n------------------------------\n'
  #小说正文
  strNovel = textSoup.find(id='content').getText()
  strNovel = strNovel.replace('  ','\n')

  #除去正文中多余的第XXX章
  strMatch = r"第[\u4e00-\u9fa5]+章"
  list2replace = re.findall(strMatch, strNovel)
  if list2replace:
    str2replace = list2replace[0]
    strNovel = strNovel.replace(str2replace, '')

  #合并章节和正文
  strNovel = strChapter + strNovel + '\n------------------------------\n------------------------------\n'

  #写到txt文件中
  write2TXT(strNovel)

  #获取下一个章节的URL
  nextURL = re.findall(r'var next_page = "[\w]+.html"', allHtml)[0]
  nextURL = nextURL.replace(r'"', '')
  nextURL = nextURL.replace(r'var next_page = ', '')
  nextURL = headURL + nextURL

  print(numChapter)#章节数
  print(strChapter)#章节名字
  print((nextURL))#下一章URL


  if(endURL == nextURL):
    isEnd = True

  return nextURL,isEnd
将抓取到的内容写入TXT文件。
#写到文本文件中
def write2TXT(txt):
  global NOVERL

  f = open(NOVERL, 'a', encoding='utf-8')
  f.write(txt + '\n\n')
  f.close()
程序运行结束后的说明与注意事项。
有三个关键点需要说明:
- 生成的TXT文本排版较为简单,在Kindle原生系统中无法实现自动分章功能(多看阅读等第三方阅读器支持较好)。为了获得更好的阅读体验,建议使用epubBuilder软件对TXT进行二次排版,转换为MOBI格式后再导入Kindle。
- 本程序是针对特定网站结构编写的,若目标网站改版,部分细节代码可能需要重新调整。不过,整体的抓取框架逻辑仍然具有通用性,可以复用。
- 网络小说虽具娱乐性,但过度沉迷可能影响个人发展。阅读时请保持理性,适度享受。
本文总结。
以上为Python下载网络小说的实例代码详解,希望能为读者提供帮助。感兴趣的用户可参考本站其他相关专题,如有疏漏欢迎留言指正,感谢支持。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















