


Python TCP Socket粘包与分包处理详解

本文详解Python中TCP Socket开发常见的粘包与分包问题。通过定义包含版本号、长度和指令的固定包头协议,结合struct模块与FIFO缓冲区机制,实现数据的正确解析。文章提供服务器端与客户端完整代码示例,涵盖Nagle算法导致的粘包及MSS限制引发的分包场景,并展示如何在Twisted框架中复用该逻辑。
概述
在TCP Socket开发过程中,处理数据包的粘包(Sticking)和分包(Fragmentation)是必经环节。解决这一问题的核心思路是在应用层自定义通信协议,结构为:消息头部 + 消息长度 + 消息正文。本文将以Python语言为例,详细阐述具体的实现步骤。
那什么是粘包和分包呢?
关于分包和粘包
粘包现象:发送方连续发送两个字符串“hello”和“world”,接收方却一次性接收到了合并后的字符串“helloworld”。
分包现象:发送方发送一个字符串“helloworld”,接收方却将其拆分为两个独立的字符串“hello”和“world”。
尽管Socket通信存在上述问题,但TCP传输协议保证了以下两点特性:
- 顺序不变。例如发送方按顺序发送“hello”,接收方也必然按顺序接收到“hello”。这是TCP协议的承诺,也是解决分包和粘包问题的关键依据。
- 分割的包中间不会插入其他无关数据。
因此,使用Socket通信时必须自定义一套协议。目前最通用的协议标准格式为:消息头部(包头)+ 消息长度 + 消息正文。
TCP为什么会分包
TCP以段(Segment)为单位发送数据。建立TCP连接后,存在一个最大报文段长度(MSS)。如果应用层数据包超过MSS,TCP会将应用层数据拆分,分成多个段发送。此时,接收端的应用层必须将这些TCP包拼接起来,才能正确处理数据。
相关地,路由器有一个最大传输单元(MTU),通常为1500字节。扣除IP头部20字节后,留给TCP的数据部分仅为MTU-20字节。因此,一般TCP的MSS值为MTU-20=1460字节。
当应用层数据超过1460字节时,TCP会自动将其分割为多个数据包发送。
扩展阅读
TCP的RFC定义MSS的默认值为536,这是因为RFC 791规定任何IP设备都必须至少能接收576字节大小的数据(实际上576是拨号网络的MTU,减去IP头的20字节即为536)。 TCP为什么会粘包
有时,为了提高网络利用率,TCP会使用Nagle算法。该算法规定,如果发送端有待发送的数据量很小,会延迟发送。如果应用层向TCP发送数据的速度很快,TCP可能会将多个应用层数据包“粘”在一起,最终只向接收端发送一个TCP数据包。
开发环境
- Python版本:3.5.1
- 操作系统:Windows 10 x64
消息头部(包含消息长度)
消息头部不一定仅由一个字节(如0xAA)组成,它可以包含协议版本号、指令类型等字段。当然,也可以将消息长度合并到消息头部中。唯一的要求是包头长度必须固定,而包体长度可变。以下是我自定义的一个包头结构:
| 版本号(ver) | 消息长度(bodySize) | 指令(cmd) |
|---|
版本号、消息长度、指令数据类型均为无符号32位整型变量,因此该消息长度固定为4×3=12字节。在Python中由于缺乏类型定义,通常使用struct模块来生成包头。示例代码如下:
import struct
import json

ver = 1
body = json.dumps(dict(hello="world"))
print(body) # {"hello": "world"}
cmd = 101
header = [ver, body.__len__(), cmd]
headPack = struct.pack("!3I", *header)
print(headPack) # b'\x00\x00\x00\x01\x00\x00\x00\x12\x00\x00\x00e'
关于用自定义结束符分割数据包
有人可能想通过自定义结束符来分割每个数据包,这样传输时就不需要指定长度甚至不需要包头。但如果这样做,网络传输性能损失巨大,因为每读取一个字节都要进行一次if判断以检查是否为结束符。因此,建议仍采用“消息头部+消息长度+消息正文”的方式。
此外,使用自定义结束符时,如果消息正文中恰好出现该符号,会导致后续数据被截断。此时还需要处理符号转义(类似于\r\n中的反斜杠处理)。因此,非常不建议使用结束符来分割数据包。
消息正文
消息正文的数据格式可以使用Json格式,通常用于存放独特信息。在下面的代码中,我使用{"hello":"world"}数据来进行测试。在Python中,使用json模块来生成json数据。
Python示例
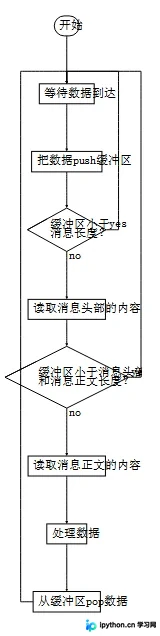
下面使用Python代码展示如何处理TCP Socket的粘包和分包。核心在于维护一个FIFO队列接收缓冲区dataBuffer,并通过一个小while循环进行判断处理。
具体流程如下:将从socket读取到的数据追加到dataBuffer末尾(入队),然后进入小循环。如果dataBuffer的内容长度小于消息长度(bodySize),则跳出小循环继续接收;如果大于消息长度,则从缓冲区读取包头并获取包体的长度,再判断整个缓冲区是否大于“消息头部+消息长度”。如果小于,则跳出小循环继续接收;如果大于,则读取包体内容,处理数据,最后将本次的消息头部和消息正文从dataBuffer中移除(出队)。
下面用Markdown绘制了一个流程图。
服务器端代码
# Python Version:3.5.1
import socket
import struct

HOST = ''
PORT = 1234

dataBuffer = bytes()
headerSize = 12

sn = 0
def dataHandle(headPack, body):
  global sn
  sn += 1
  print("第%s个数据包" % sn)
  print("ver:%s, bodySize:%s, cmd:%s" % headPack)
  print(body.decode())
  print("")

if __name__ == '__main__':
  with socket.socket(socket.AF_INET, socket.SOCK_STREAM) as s:
    s.bind((HOST, PORT))
    s.listen(1)
    conn, addr = s.accept()
    with conn:
      print('Connected by', addr)
      while True:
        data = conn.recv(1024)
        if data:
          # 把数据存入缓冲区,类似于push数据
          dataBuffer += data
          while True:
            if len(dataBuffer) < headerSize:
              print("数据包(%s Byte)小于消息头部长度,跳出小循环" % len(dataBuffer))
              break

            # 读取包头
            # struct中:!代表Network order,3I代表3个unsigned int数据
            headPack = struct.unpack('!3I', dataBuffer[:headerSize])
            bodySize = headPack[1]

            # 分包情况处理,跳出函数继续接收数据
            if len(dataBuffer) < headerSize+bodySize :
              print("数据包(%s Byte)不完整(总共%s Byte),跳出小循环" % (len(dataBuffer), headerSize+bodySize))
              break
            # 读取消息正文的内容
            body = dataBuffer[headerSize:headerSize+bodySize]

            # 数据处理
            dataHandle(headPack, body)

            # 粘包情况的处理
            dataBuffer = dataBuffer[headerSize+bodySize:] # 获取下一个数据包,类似于把数据pop出
测试服务器端的客户端代码
下面附上用于测试粘包和分包的客户端代码。
# Python Version:3.5.1
import socket
import time
import struct
import json

host = "localhost"
port = 1234

ADDR = (host, port)

if __name__ == '__main__':
  client = socket.socket()
  client.connect(ADDR)

  # 正常数据包定义
  ver = 1
  body = json.dumps(dict(hello="world"))
  print(body)
  cmd = 101
  header = [ver, body.__len__(), cmd]
  headPack = struct.pack("!3I", *header)
  sendData1 = headPack+body.encode()

  # 分包数据定义
  ver = 2
  body = json.dumps(dict(hello="world2"))
  print(body)
  cmd = 102
  header = [ver, body.__len__(), cmd]
  headPack = struct.pack("!3I", *header)
  sendData2_1 = headPack+body[:2].encode()
  sendData2_2 = body[2:].encode()

  # 粘包数据定义
  ver = 3
  body1 = json.dumps(dict(hello="world3"))
  print(body1)
  cmd = 103
  header = [ver, body1.__len__(), cmd]
  headPack1 = struct.pack("!3I", *header)

  ver = 4
  body2 = json.dumps(dict(hello="world4"))
  print(body2)
  cmd = 104
  header = [ver, body2.__len__(), cmd]
  headPack2 = struct.pack("!3I", *header)

  sendData3 = headPack1+body1.encode()+headPack2+body2.encode()


  # 正常数据包
  client.send(sendData1)
  time.sleep(3)

  # 分包测试
  client.send(sendData2_1)
  time.sleep(0.2)
  client.send(sendData2_2)
  time.sleep(3)

  # 粘包测试
  client.send(sendData3)
  time.sleep(3)
  client.close()
服务器端打印结果
下面是测试输出的打印结果,可见接收方已经完美地处理了粘包和分包问题。
Connected by ('127.0.0.1', 23297)
第1个数据包
ver:1, bodySize:18, cmd:101
{"hello": "world"}

数据包(0 Byte)小于包头长度,跳出小循环
数据包(14 Byte)不完整(总共31 Byte),跳出小循环
第2个数据包
ver:2, bodySize:19, cmd:102
{"hello": "world2"}

数据包(0 Byte)小于包头长度,跳出小循环
第3个数据包
ver:3, bodySize:19, cmd:103
{"hello": "world3"}

第4个数据包
ver:4, bodySize:19, cmd:104
{"hello": "world4"}
在框架下处理粘包和分包
实际上,无论是使用阻塞还是异步Socket开发框架,框架本身都会提供一个接收数据的方法供开发者调用,通常开发者需要覆写该方法。下面是在Twisted开发框架中处理粘包和分包的示例,仅展示核心程序:
# Twiested
class MyProtocol(Protocol):
  _data_buffer = bytes()

  # 代码省略

  def dataReceived(self, data):
    """Called whenever data is received."""
    self._data_buffer += data
    headerSize = 12

    while True:
      if len(self._data_buffer) < headerSize:
        return

      # 读取消息头部
      # struct中:!代表Network order,3I代表3个unsigned int数据
      headPack = struct.unpack('!3I', self._data_buffer[:headerSize])
      # 获取消息正文长度
      bodySize = headPack[1]

      # 分包情况处理
      if len(self._data_buffer) < headerSize+bodySize :
        return

      # 读取消息正文的内容
      body = self._data_buffer[headerSize:headerSize+bodySize]
      # 处理数据
      self.dataHandle(headPack, body)
      # 粘包情况的处理
      self._data_buffer = self._data_buffer[headerSize+bodySize:]
总结
以上就是本文关于Python TCP Socket粘包和分包处理的详解全部内容,希望对大家有所帮助。感兴趣的朋友可以继续参阅本站其他相关专题,如有不足之处,欢迎留言指出。感谢朋友们对本站的支持!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















