


Python实现K-Means聚类算法详解与代码解析

本文详细解析了Python中K-Means聚类算法的实现过程。从算法原理出发,通过构建寻找最近质心、计算新质心及迭代优化等核心函数,逐步演示如何对二维数据进行聚类。文章提供了完整的Python代码示例,包括数据加载、初始质心设定、迭代过程及结果可视化,帮助读者深入理解并掌握K-Means算法的实际应用。
本文分享了Python中K-Means聚类算法的具体实现代码,供读者参考学习。
1. K-Means聚类算法原理
K-means是一种典型的基于距离的聚类算法,它利用距离作为相似性的评价指标,即认为两个对象之间的距离越近,其相似度就越高。该算法的基本思想是:以空间中k个点为中心进行聚类,将最靠近这些中心的对象归入相应的类。通过迭代更新各聚类中心的值,直至获得最佳的聚类结果。最终目标是使各个聚类内部尽可能紧凑,而不同聚类之间尽可能分离。 算法的大致流程如下:(1)随机选取k个点作为初始种子点(这些点不一定属于原始数据集);(2)分别计算每个数据点到这k个种子点的距离,将数据点归入距离最近的种子点所在的类别;(3)重新计算k个种子点的坐标(常用方法是求属于该类的数据点坐标的平均值作为新的坐标);(4)重复步骤2和3,直到种子点坐标不再变化或达到预设的循环次数。
2. 数据准备与初步聚类中心寻找
数据采用Matlab加载格式(mat文件),其中包含变量X,数据来源为指定链接(读者可自行下载)。变量X是一个300*2维的矩阵,由于是二维数据,因此聚类过程基本上是在平面坐标系中的一些点进行。
我们首先构建一个用于初步寻找聚类中心(centroids,即质心)的函数,并随机设置初始质心,通过欧氏距离初步判断X中的每个变量属于哪个质心。相关代码如下:
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt
import seaborn as sb
from scipy.io import loadmat

def find_closest_centroids(X, centroids):
  m = X.shape[0]
  k = centroids.shape[0] #要聚类的类别个数
  idx = np.zeros(m)

  for i in range(m):
    min_dist = 1000000 #迭代终止条件
    for j in range(k):
      dist = np.sum((X[i,:] - centroids[j,:]) ** 2)
      if dist < min_dist:
        # 记录当前最短距离和其中心的索引值
        min_dist = dist
        idx[i] = j

  return idx
data = loadmat('D:\python\Python ml\ex7data2.mat')
X = data['X']
initial_centroids = np.array([[3, 3], [6, 2], [8, 5]])

idx = find_closest_centroids(X, initial_centroids)
idx[0:3]
在上述代码中,首先生成了m(此处为300)个0向量,即idx,假设X中的每个变量初始时均属于第0类。随后,根据与初始质心的距离计算dist = np.sum((X[i,:] - centroids[j,:]) ** 2),初步判断每个变量应归属哪个类别,并最终用计算结果替代idx中的初始0值。
3. 迭代寻找质心位置并实现K-Means算法
上述idx生成的300维向量用于判断X中每个变量的归属类别。在此基础上,我们需要不断调整初始质心的位置,以寻找最优的质心分布。
def compute_centroids(X, idx, k):
  m, n = X.shape
  centroids = np.zeros((k, n))

  for i in range(k):
    indices = np.where(idx == i)
    centroids[i,:] = (np.sum(X[indices,:], axis=1) / len(indices[0])).ravel()
  #这里简单的将该类中心的所有数值求平均值作为新的类中心
return centroids
compute_centroids(X, idx, 3)
基于上述函数,我们构建kmeans函数来实现K-means聚类算法。根据得到的每个变量的归属类别与质心坐标,进行可视化展示。
def run_k_means(X, initial_centroids, max_iters):
  m, n = X.shape
  k = initial_centroids.shape[0]
  idx = np.zeros(m)
  centroids = initial_centroids

  for i in range(max_iters):
    idx = find_closest_centroids(X, centroids)
    centroids = compute_centroids(X, idx, k)

  return idx, centroids
idx, centroids = run_k_means(X, initial_centroids, 10)
cluster1 = X[np.where(idx == 0)[0],:] #获取X中属于第一个类别的数据集合,即类别1的点
cluster2 = X[np.where(idx == 1)[0],:]
cluster3 = X[np.where(idx == 2)[0],:]

fig, ax = plt.subplots(figsize=(12,8))
ax.scatter(cluster1[:,0], cluster1[:,1], s=30, color='r', label='Cluster 1')
ax.scatter(cluster2[:,0], cluster2[:,1], s=30, color='g', label='Cluster 2')
ax.scatter(cluster3[:,0], cluster3[:,1], s=30, color='b', label='Cluster 3')
ax.legend()
plt.show()
得到的图形如下所示:
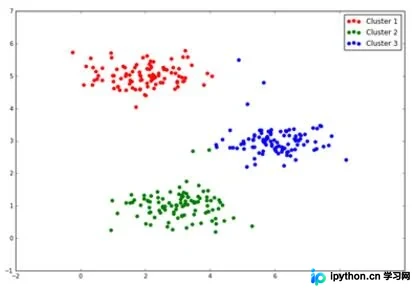
[图片占位符,由程序原样保留]
4. 关于初始化质心的设置
前文设置的初始质心为:[3, 3], [6, 2], [8, 5],这是事先设定的,并由此生成idx(表示每一变量归属类别的向量),这是后续进行K-Means聚类的基础。实际上,对于二维以上的数据,由于无法在平面坐标轴上直观展示,很难一开始就设定较好的初始质心。此外,初始质心的设定可能会影响算法的收敛性。因此,我们需要构造一个初始化质心设定函数,以便更好地设置初始质心。
def init_centroids(X, k):
  m, n = X.shape
  centroids = np.zeros((k, n)) #初始化零矩阵
  idx = np.random.randint(0, m, k) #返回0-m之间的整数值

  for i in range(k):
    centroids[i,:] = X[idx[i],:]

return centroids
init_centroids(X, 3)
这里生成的初始质心位置,实际上是从X的数据中随机选取3个变量作为初始值。在此基础上,令initial_centroids = init_centroids(X, 3),然后代入前边的代码中,重新运行一遍即可。
以上就是本文的全部内容,希望对大家的学习有所帮助,也希望大家多多支持本站。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















