


Python即时网络爬虫项目:从C++转向Python的动机与架构解析

本文详解Python即时网络爬虫项目的启动背景,作者从C++转向Python的考量,以及“即时”在系统部署、数据流和模块集成层面的定义。项目旨在通过模块化提取器解决80%的数据抓取工作量,实现快速部署与批量数据收割。
作为一名资深开发者,面对Python当前的热度,我难以抑制尝试的热情。
此前我对Python持保留态度,曾因Drupal系统升级导致PHP代码大量重构,遗留隐患至今未除,因此担心Python也会面临类似的语言版本迭代风险(如关于Python 3的争议)。然而,基于我在C++、Java和JavaScript爬虫开发上超过10年的经验,为了追求极致性能,C++仍是首选,因其标准体系完善且经过充分测试后运行稳定。在GooSeeker项目中,我们的核心目标是“数据收割”,让各类用户都能体验批量获取互联网数据的便捷。此次启动“即时网络爬虫”,旨在填补“收割”模式未覆盖的场景,具体体现在以下几个方面:
- 系统层面:“即时”意味着数据应用系统的快速部署能力。
- 数据流层面:“即时”指从数据采集到使用的零延迟,单个数据对象可独立全流程处理,无需等待整批数据入库后再提取使用。
- 此外,“即时”还意味着网络爬虫作为嵌入模块,需与整个信息处理系统深度集成。
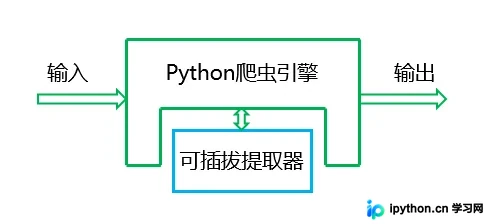
鉴于众多开发者关注Python网络爬虫,我制定了建立高模块化软件部件的计划,专门解决最耗时的内容提取问题。有观点指出,大数据链条中数据准备占80%工作量,同理,网络数据抓取中约80%的工作量在于为不同网站的数据结构编写抓取规则。
我将该组件构想为一个小机器(见上图),输入原始网页,输出结构化内容。其核心是可替换的“提取器”指令块,旨在消除用户调试正则表达式或XPath的困扰。
这是一个开放项目。两年前我们曾启动一个面向某商业集团的手机即时网络爬虫项目,因商业原因未公开。本项目将沿用相同的思想与方法,但采用当前流行的Python语言,并公开所有资料、成果及踩坑经验,邀请大家共同参与。
近期进行的实验包括:
Python使用XSLT提取网页数据 Python爬虫结合Selenium与PhantomJS抓取Ajax及动态HTML内容
以上内容希望能为各位的学习提供参考,欢迎支持本站。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















