


Python Pickle库详解:序列化与反序列化实战指南

本文深入解析Python标准库Pickle的序列化与反序列化机制。详细讲解pickle.dump、pickle.dumps、pickle.load及pickle.loads等核心API的参数用法,对比Protocol版本差异,并通过完整代码示例展示如何将Python对象持久化存储至.pkl文件及在网络间高效传输。
前文曾通过简单示例介绍机器学习概念并提及pickle库,本文将对该库的使用进行更深入的阐述。
首先需要明确,为何在编程中必须进行序列化和反序列化操作?
首要原因是便于存储。序列化过程将文本或对象信息转换为二进制数据流,使得数据能够方便地存储在硬盘中。当需要读取文件时,从硬盘获取数据并执行反序列化,即可还原原始数据。在Python程序运行过程中生成的字符串、列表、字典等数据,若希望长久保存以便后续使用,而非仅存在于易失的内存中(关机断电即丢失),Python标准库中的Pickle模块便派上了用场。它能将对象转换为可传输或存储的格式。
其次是便于传输。在两个进程进行远程通信时,双方可以发送各种类型的数据。无论数据类型如何,最终都会以二进制序列的形式在网络中传输。发送方需将对象转换为字节序列以便网络传输;接收方则需将接收到的字节序列恢复为原始对象。
(此处引用前文:通过简单示例来理解什么是机器学习)
Pickle是Python语言的一个标准模块,安装Python环境后已内置该库,无需单独安装。
Pickle模块实现了基本的数据序列化和反序列化功能。通过其序列化操作,可以将程序中运行的对象信息保存到文件中,实现永久存储;通过反序列化操作,则可以从文件中重建之前保存的对象实例。
在官方文档介绍中,序列化操作的英文描述包含多个词汇,如“serializing”、“pickling”、“serialization”、“marshalling”或“flattening”等,它们均指代序列化的含义。相应的,反序列化操作的英文词汇包括“de-serializing”、“unpickling”、“deserailization”等。为避免混淆,通常使用“pickling”/“unpickling”或“serialization”/“deserailization”这一对术语。
Pickle模块以二进制形式将序列化后的数据保存到文件中(文件后缀通常为“.pkl”),因此无法直接打开预览。相比之下,Python的另一个序列化标准模块JSON是“human-readable”(人类可读)的,可以直接用文本编辑器(如Notepad++)打开查看。
Pickle模块主要包含两类接口:序列化和反序列化。
其中,序列化操作包括以下方法:
pickle.dump()
Pickler(file, protocol).dump(obj)
反序列化操作包括以下方法:
pickle.load()
Unpickler(file).load()
2 序列化操作详解
2.1 序列化方法pickle.dump()
序列化的主要方法为 pickle.dump(),。该方法的相关参数定义如下:
pickle.dump(obj, file, protocol=None,*,fix_imports=True)
此方法的功能是将序列化后的对象obj以二进制形式写入指定的文件file中,从而实现保存。其底层功能等同于调用 Pickler(file, protocol).dump(obj)。
关于参数file,有一个关键注意事项:必须以二进制模式进行操作(写入)。
参考前文的案例如下:
import picklewith open('svm_model_iris.pkl', 'wb') as f:
 pickle.dump(svm_classifier, f)
在此案例中,file参数为'svm_model_iris.pkl'',并且以二进制写入模式('wb')进行操作。
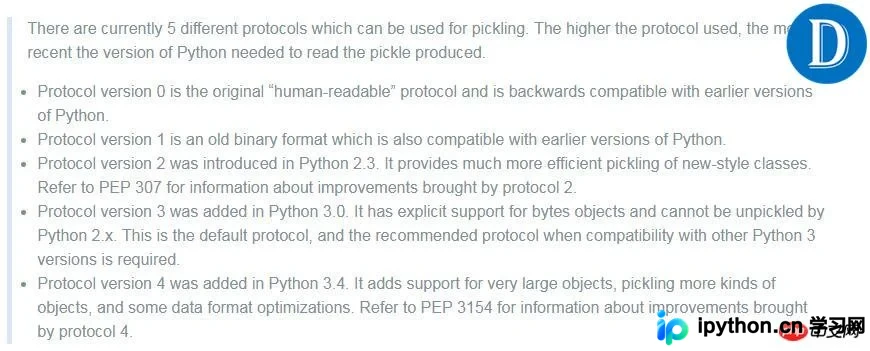
关于参数protocol,共有5种不同的类型,即(0, 1, 2, 3, 4)。其中,(0, 1, 2)对应Python的早期版本,而(3, 4)则是Python 3之后的版本标准。
此外,参数中可选用 pickle.HIGHEST_PROTOCOL 和 pickle.DEFAULT_PROTOCOL。在当前Python 3.5版本中,pickle.HIGHEST_PROTOCOL的值为4,pickle.DEFAULT_PROTOCOL的值为3。当protocol参数设置为负数时,表示选择当前环境下的pickle.HIGHEST_PROTOCOL。
关于参数protocol的官方详细说明如下:
2.2 序列化方法pickle.dumps()
pickle.dumps()方法的参数定义如下:
pickle.dumps(obj, protocol=None,*,fix_imports=True)
pickle.dumps()方法与pickle.dump()方法的区别在于,pickle.dumps()方法不需要将数据写入文件,而是直接返回一个序列化的bytes对象。
2.3 序列化方法Pickler(file, protocol).dump(obj)
Pickle模块提供了面向对象的序列化类方法,即 class pickle.Pickler(file, protocol=None,*,fix_imports=True),该Pickler类拥有dump()方法。
Pickler(file, protocol).dump(obj) 实现的功能与pickle.dump() 是完全一致的。
关于Pickler类的其他方法,请参考官方API文档。
(插播说明:技术文章转发较多,本文源自微信公众号:“Python数据之道”(ID:PyDataRoad)。)
3 反序列化操作详解
3.1 反序列化方法pickle.load()
反序列化的主要方法为pickle.load(),该方法的相关参数定义如下:
pickle.load(file, *,fix_imports=True, encoding=”ASCII”. errors=”strict”)
此方法的功能是将序列化的对象从文件file中读取出来。其底层功能等同于调用 Unpickler(file).load()。
关于参数file,同样需要注意:必须以二进制模式进行操作(读取)。
参考前文的案例如下:
import picklewith open('svm_model_iris.pkl', 'rb') as f:
 model = pickle.load(f)
在此案例中,file参数为'svm_model_iris.pkl'',并且以二进制读取模式('rb')进行操作。
在读取时,参数protocol是自动选择的,load()方法中无需显式指定该参数。
3.2 反序列化方法pickle.loads()
pickle.loads()方法的参数定义如下:
pickle.loads(bytes_object, *,fix_imports=True, encoding=”ASCII”. errors=”strict”)
pickle.loads()方法与pickle.load()方法的区别在于,pickle.loads()方法是直接从bytes对象中读取序列化的信息,而非从文件中读取。
3.3 反序列化方法Unpickler(file).load()
Pickle模块提供了面向对象的反序列化类方法,即 class pickle.Unpickler(file, *,fix_imports=True, encoding="ASCII", errors="strict"),该Unpickler类拥有load()方法。
Unpickler(file).load() 实现的功能与pickle.load()是一致的。
关于Unpickler类的其他方法,请参考官方API文档。
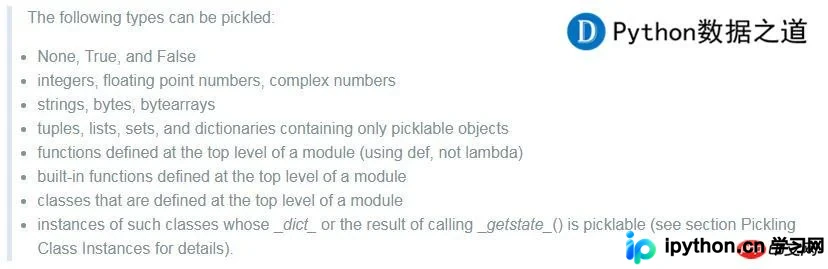
4 哪些类型可以进行序列化和反序列化操作
官方文档对此有明确介绍,此处不再赘述。
写在后面
Pickle模块在实际开发中非常实用。当然,关于Pickle模块还有大量信息值得探索,希望了解更多内容的读者,建议阅读Python官方API文档(library部分)。
以上所述是小编给大家介绍的Python中Pickle库的使用详解,希望对大家有所帮助。如果大家有任何疑问,请留言,小编会及时回复。在此也非常感谢大家对本站网站的支持!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















