


TensorFlow实战:Python实现神经网络基础与核心概念解析

本文通过Python代码示例,详解TensorFlow中神经网络的实现流程,涵盖定义结构、损失函数及会话管理。深入解析计算图、张量与运行模型三大核心概念,并提供变量初始化与GPU指定等实用技巧,帮助开发者快速掌握AI模型训练基础。
TensorFlow神经网络实现概述
本文旨在通过一个简明实例,展示如何在TensorFlow平台上利用Python构建神经网络。训练数据采用随机生成的模拟数据集,主要目标是解决二分类问题。
神经网络训练标准流程
在开始编码前,需明确训练神经网络的标准流程,通常包含以下关键环节:
第一步,定义神经网络的具体架构以及前向传播的输出结果。
第二步,设定损失函数,并选择反向传播优化算法以调整参数。
第三步,创建会话(Session),并在训练数据上迭代执行反向传播优化算法。
值得注意的是,无论神经网络的具体结构如何复杂或变化,上述三个核心步骤始终不变。
完整代码示例与结果分析
以下是完整的实现代码示例:
import tensorflow as tf
#导入TensorFlow工具包并简称为tf

from numpy.random import RandomState
#导入numpy工具包,生成模拟数据集

batch_size = 8
#定义训练数据batch的大小

w1 = tf.Variable(tf.random_normal([2,3],stddev=1,seed=1))
w2 = tf.Variable(tf.random_normal([3,1],stddev=1,seed=1))
#分别定义一二层和二三层之间的网络参数,标准差为1,随机产生的数保持一致

x = tf.placeholder(tf.float32,shape=(None,2),name='x-input')
y_ = tf.placeholder(tf.float32,shape=(None,1),name='y-input')
#输入为两个维度,即两个特征,输出为一个标签,声明数据类型float32,None即一个batch大小
#y_是真实的标签

a = tf.matmul(x,w1)
y = tf.matmul(a,w2)
#定义神经网络前向传播过程

cross_entropy = -tf.reduce_mean(y_ * tf.log(tf.clip_by_value(y,1e-10,1.0)))
train_step = tf.train.AdamOptimizer(0.001).minimize(cross_entropy)
#定义损失函数和反向传播算法

rdm = RandomState(1)
dataset_size = 128
#产生128组数据
X = rdm.rand(dataset_size,2)
Y = [[int(x1+x2 < 1)] for (x1,x2) in X]
#将所有x1+x2<1的样本视为正样本,表示为1;其余为0

#创建会话来运行TensorFlow程序
with tf.Session() as sess:
 init_op = tf.global_variables_initializer()
 #初始化变量
 sess.run(init_op)

 print(sess.run(w1))
 print(sess.run(w2))
 #打印出训练网络之前网络参数的值

 STEPS = 5000
 #设置训练的轮数
 for i in range(STEPS):
  start = (i * batch_size) % dataset_size
  end = min(start+batch_size,dataset_size)
 #每次选取batch_size个样本进行训练

  sess.run(train_step,feed_dict={x:X[start:end],y_:Y[start:end]})
 #通过选取的样本训练神经网络并更新参数

  if i%1000 == 0:
   total_cross_entropy = sess.run(cross_entropy,feed_dict={x:X,y_:Y})
   print("After %d training step(s),cross entropy on all data is %g" % (i,total_cross_entropy))
 #每隔一段时间计算在所有数据上的交叉熵并输出,随着训练的进行,交叉熵逐渐变小

 print(sess.run(w1))
 print(sess.run(w2))
 #打印出训练之后神经网络参数的值
执行上述代码后的运行结果如下所示:
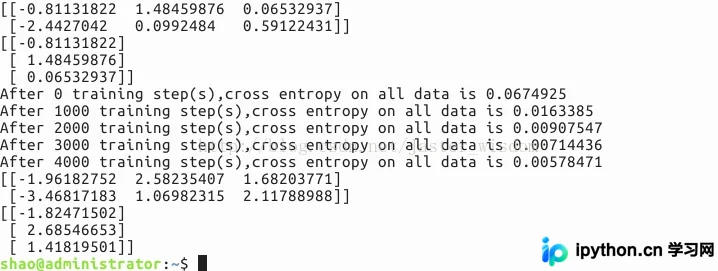
对运行结果的详细解读如下:
首先,代码会打印出训练前的网络参数,这些是随机初始化的数值。随后,在训练过程中每隔1000次迭代输出一次交叉熵值。观察发现,交叉熵数值逐渐减小,这表明模型的分类性能正在逐步提升。最后,输出训练结束后的网络参数值。
推荐一个用于可视化神经网络训练过程的在线工具:点击此处访问。该工具允许用户自定义网络参数大小、层数及学习速率,并以直观形式展示训练过程。例如:
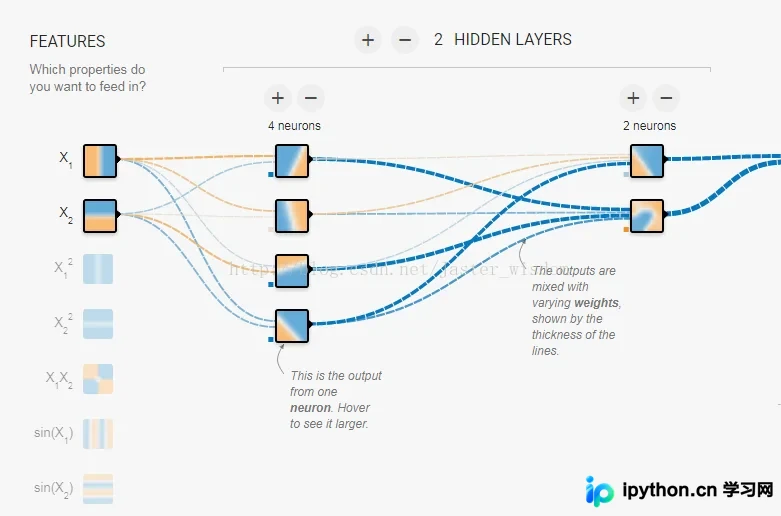
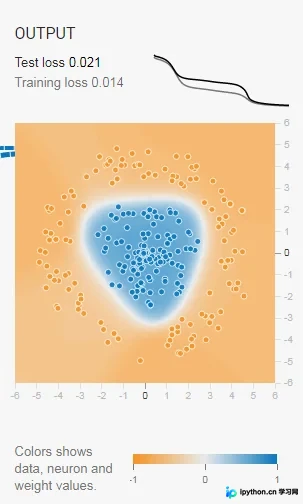
借助此类可视化工具,可以对神经网络的训练机制建立更为深刻的理解。
TensorFlow核心概念解析
此外,补充介绍TensorFlow相关的几个核心知识模块:
计算模型:计算图
1. TensorFlow的计算模型:计算图
“Tensor”意为张量,可简单理解为多维数据结构;“Flow”则体现了其计算模型。Flow意为“流”,直观地表达了张量之间通过计算相互转换的过程。在TensorFlow中,每一个计算操作对应计算图上的一个节点,而节点之间的边则描述了计算之间的依赖关系。
指定使用GPU的方法,相关命令如下:
import tensorflow as tf
a = tf.constant([1.0,2.0],name=“a”)
b = tf.constant([3.0,4.0],name=“b”)
g = tf.Graph()
with g.device(/gpu:0):
result = a + b
sess = tf.Session()
sess.run(result)
数据模型:张量
2. TensorFlow的数据模型:张量
张量是TensorFlow中管理数据的基本形式。零阶张量表示标量,一阶张量为向量(即一维数组),一般而言,第n阶张量可理解为一个n维数组。需要注意的是,张量本身并不存储运算结果,它仅是对计算结果的一个引用。要获取实际计算结果,需使用tf.Session().run(result)语句。
运行模型:会话管理
3. TensorFlow的运行模型:会话
我们使用会话(Session)来执行预先定义好的运算。
创建会话主要有两种方式,第一种方式可能导致内存泄漏,而第二种方式则能有效避免此类问题。
#创建一个会话
sess = tf.Session()
sess.run(…)
#关闭会话使得本次运行中使用的资源得到释放
sess.close()
第二种方式是利用Python的上下文资源管理器来管理会话。
with tf.Session() as sess:
sess.run(…)
这种方式能够自动关闭会话并自动释放相关资源。
神经网络应用示例
4. TensorFlow神经网络示例
使用神经网络解决分类问题通常包含以下四个步骤: ① 提取问题中实体的特征向量作为输入数据。 ② 定义神经网络的结构,并定义如何从输入得到输出,这一过程称为前向传播算法。 ③ 利用训练数据调整神经网络中的参数设置,即训练网络的过程。 ④ 使用训练好的神经网络对未知数据进行预测。
在TensorFlow中声明一个2x3矩阵变量的方法如下:
weight = tf.Variable(tf.random_normal([2,3],stddev=2))
上述代码表示生成均值为0、标准差为2的正态分布随机数。
在TensorFlow中,变量的值在被使用前,必须明确调用初始化过程。以下代码用于一次性初始化所有变量:
sess = tf.Session() init_op = tf.initialize_all_variables()
或者,也可以使用init_op = tf.global_variables_initializer()进行替代。
最后执行sess.run(init_op)完成初始化。
以上就是本文的全部内容,希望对各位的学习有所帮助,也欢迎大家继续支持本站。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















