Python zipfile解压中文乱码修复与完整解压实现
本文解决Python标准库zipfile解压含中文文件名压缩包时出现的乱码问题。通过自定义编码修正函数,结合shutil与os模块,实现复杂zip文件的完整解压,确保目录结构和文件内容完好无损。
10-15
6




本文解决Python标准库zipfile解压含中文文件名压缩包时出现的乱码问题。通过自定义编码修正函数,结合shutil与os模块,实现复杂zip文件的完整解压,确保目录结构和文件内容完好无损。
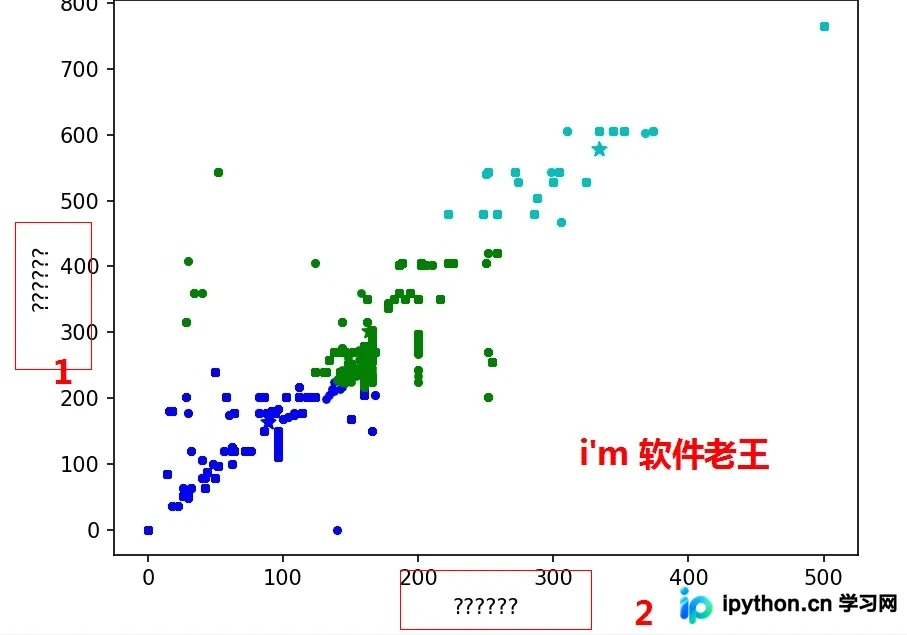
本文详解在Linux服务器环境下使用Python进行K-means算法绘图时,Matplotlib出现中文乱码的解决方案。通过查找字体路径、上传simhei.ttf字体、清除缓存及修改配置文件等步骤,有效解决图表中文显示异常问题,并附带JMeter测试时的UTF-8参数设置建议。
本文详细解析Python连接MySQL时出现的UnicodeEncodeError及中文乱码问题。重点介绍如何在SQLOBJECT中使用use_unicode和charset参数,以及在MySQLdb中通过连接参数、sys.setdefaultencoding和MySQL配置文件my.cnf进行全链路UTF-8编码设置,确保数据读写正常。
本文针对Python3环境下使用HTMLTestRunner生成测试报告时出现的中文乱码问题,深入分析其根本原因。通过对比print输出与文件写入的差异,定位到文件打开方式未指定编码导致的编码错误。文章提供了两种有效的解决方案:一是在打开文件时显式设置encoding='utf-8';二是将写入模式改为二进制'wb'并对字符串进行UTF-8编码。
本文详细介绍在VSCode中运行Python代码时print输出中文出现乱码的三种解决方法。包括添加系统全局变量PYTHONIOENCODING、修改VSCode tasks.json配置文件,以及在代码中强制更改标准输出编码。每种方法均提供具体操作步骤和注意事项,帮助用户快速解决编码问题。
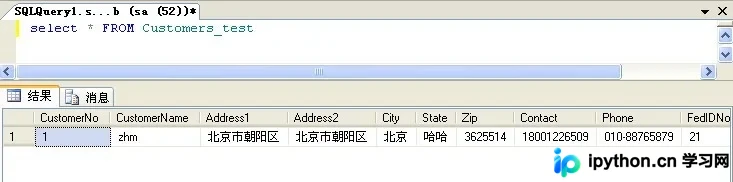
本文详解Python使用pyodbc库连接SQL Server 2008数据库的完整流程,涵盖连接字符串配置、游标操作及事务提交。重点解决中文数据显示为乱码问题,通过指定UTF-8字符集参数实现正确显示,并提供完整代码示例供参考。
本文介绍如何解决Pandas中使用to_json()导出中文数据时出现的\uXXXXXX乱码问题。通过设置force_ascii=False参数,可直接在to_json中保留中文。此外,文章还演示了如何将DataFrame转换为Python原生列表,利用json.dumps的ensure_ascii=False参数生成格式化的JSON数组,并提供了完整的封装类源码供参考。

本文介绍在C#开发中通过Socket通信和MySQL数据库操作时如何避免中文乱码。核心在于统一使用Unicode(UTF-8)编码进行字节流转换,并在MySQL中将存储中文的字段类型设置为nvarchar、nchar或ntext。
本文详解Python使用MySQLdb库插入中文数据时出现的乱码及数据未保存问题。通过设置连接参数charset为utf-8,并在插入前对字符串进行gbk到utf-8的编码转换,可有效解决乱码。同时强调执行插入语句后必须调用conn.commit()提交事务,否则断开连接后数据不会持久化。
本文总结了Python中常见的中文乱码问题及解决方法,涵盖SyntaxError、UnicodeDecodeError和UnicodeEncodeError等典型错误。文章详细解释了decode与encode的工作原理,分析了IDE控制台输出限制,并提供了针对特定环境(如UliPad、Windows XP)的编码转换代码示例,包括处理网页内容时的编码转换策略。
本文介绍如何使用Python的lxml库通过XPath定位HTML文档中的特定元素,并解决提取内容中出现的中文乱码问题。通过html.tostring获取字节流后,利用HTMLParser.unescape方法将HTML实体编码转换为可读字符串,从而完整保留原始文本内容。
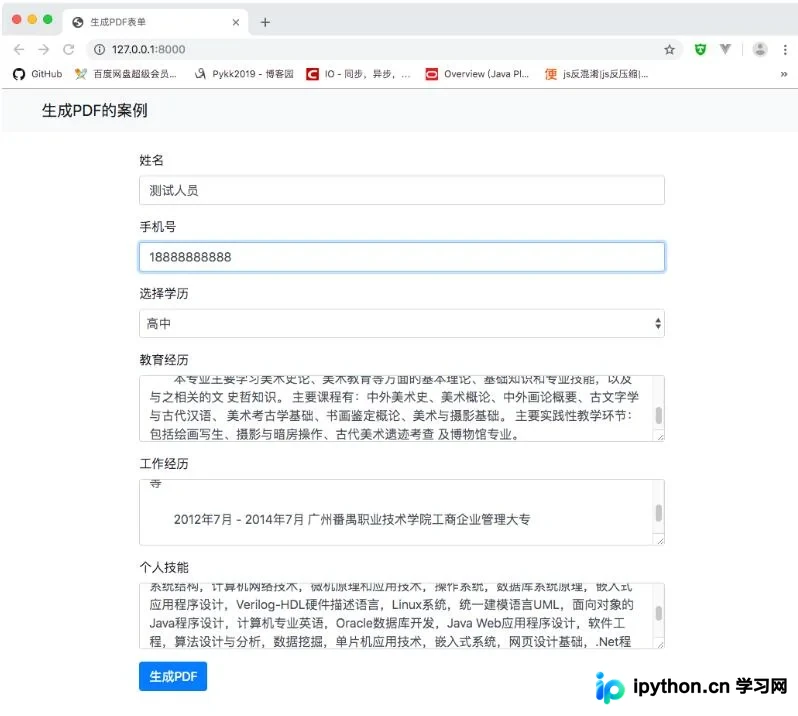
本文介绍如何使用Django结合xhtml2pdf库生成PDF文档,并重点解决中文显示乱码问题。通过配置msyh.ttf字体、编写表单验证与类视图,实现从用户输入到PDF下载的全流程。代码包含FormView构建、PDF响应生成及字体补丁函数的具体实现,帮助开发者快速掌握Django中PDF生成的核心技巧。