SQL Server批量插入数据:Bulk与TVP性能对比及实现
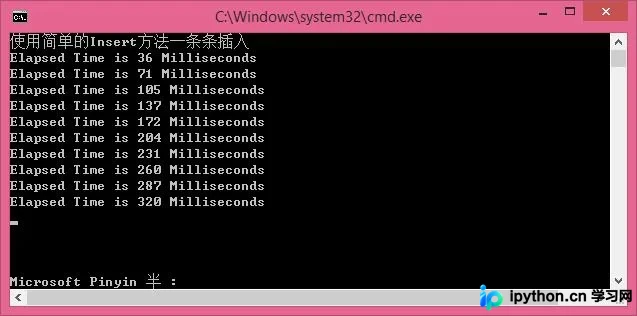
针对SQL Server中大量数据导入需求,传统单条INSERT效率低下。本文通过C#代码实证对比三种方法:普通循环插入、SqlBulkCopy批量复制及表值参数(TVP)。重点详解Bulk与TVP的配置步骤、代码实现及性能差异,提供从建库、定义类型到执行插入的完整流程,帮助开发者在高并发场景下选择最优数据写入策略。
10-16
9




针对SQL Server中大量数据导入需求,传统单条INSERT效率低下。本文通过C#代码实证对比三种方法:普通循环插入、SqlBulkCopy批量复制及表值参数(TVP)。重点详解Bulk与TVP的配置步骤、代码实现及性能差异,提供从建库、定义类型到执行插入的完整流程,帮助开发者在高并发场景下选择最优数据写入策略。
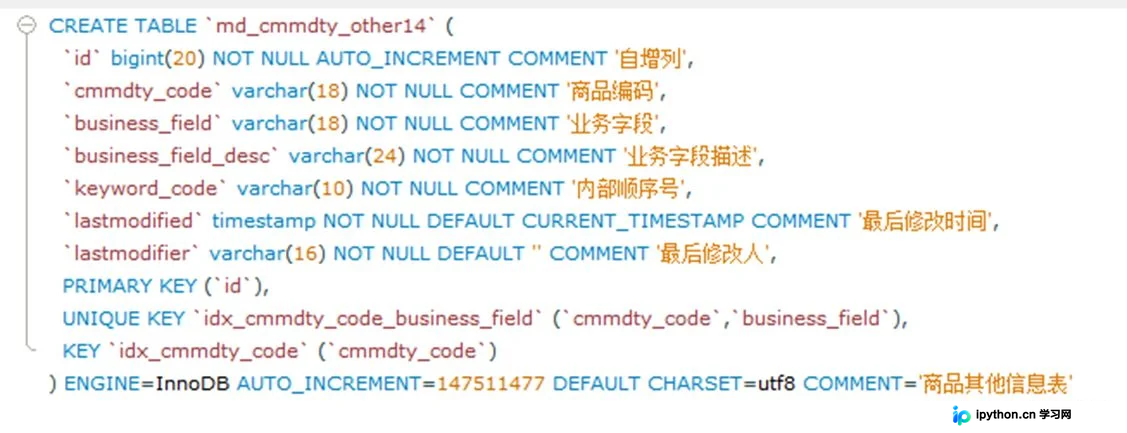
在 MySQL RC 隔离级别下,先删后增操作配合唯一联合索引极易引发死锁。本文通过复现死锁日志和源码分析,指出 RC 级别下唯一键冲突检查会触发间隙锁,导致相邻事务竞争排他锁而形成循环等待。解决方案是废弃先删后增逻辑,采用全量数据的更新与新增合并策略。
针对C#处理MySQL千万级数据的性能瓶颈,本文提出基于MySqlDataReader的原生SQL读取方案和分批合并INSERT的写入策略。通过关闭ORM开销、调整超时参数、利用StringBuilder构建长SQL并控制max_allowed_packet阈值,实现高吞吐量的数据迁移与处理流程。
针对 MySQL 大表深层分页导致的 LIMIT 延迟问题,本文提供三种主流优化策略。通过主键覆盖索引的子查询加速、JOIN 连接分页以及利用 SQL_CALC_FOUND_ROWS 一次性获取总数与数据。实测表明,在偏移量巨大时,基于索引的子查询与 JOIN 方案相比全表扫描有显著性能提升,而 FOUND_ROWS 则能减少二次查询开销,适合需要总行数的场景。
MySQL中较大的Offset值会导致全表扫描并丢弃大量数据,严重影响查询性能。本文介绍一种基于“覆盖索引”结合“延迟关联”的优化策略。通过在子查询中仅返回主键ID并使用覆盖索引快速定位,再与原表进行Inner Join获取完整数据,从而避免回表操作带来的巨大开销,显著提升深分页查询效率。
本文总结了 SQL Server 数据库开发的二十一条核心经验,涵盖工具掌握、性能优化(避免游标、SELECT *)、设计规范(规范化、索引策略)及安全性(事务、死锁预防)。通过具体操作建议,帮助开发者构建高效、健壮的数据库架构。
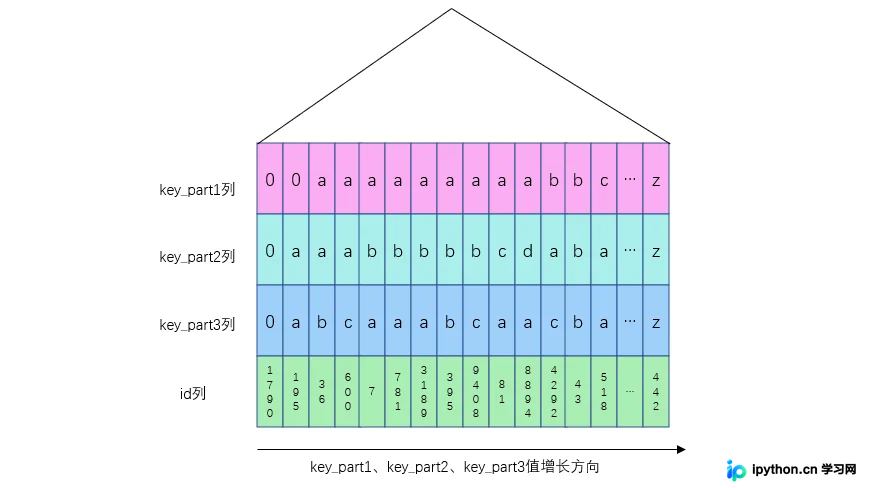
本文深入解析MySQL索引在数据库中的三大核心作用:通过B+树结构减少全表扫描记录数,利用索引有序性实现高效排序(order by)及避免临时表文件排序,以及借助索引顺序直接进行分组统计(group by)。文章结合具体SQL语句与InnoDB存储引擎特性,说明联合索引在排序和分组时的连续列要求,帮助用户理解索引机制以优化查询性能。
在 SQL Server 中,准确测量 SQL 语句的执行耗时是优化性能的关键。本文介绍了两种常用且有效的方法:一是利用 getdate() 和 datediff() 函数手动计算执行前后的毫秒级差值;二是使用 SET STATISTICS TIME ON 开启统计信息,直接获取语句编译和执行所消耗的 CPU 时间及 I/O 开销。通过合理选择工具,您可以快速定位耗时操作。
本文深入解析MySQL索引失效的原理,重点阐述最左前缀匹配原则及范围查询对排序性的影响。通过联合索引(a,b)实例分析单独查b字段、范围查a字段及不等值组合的执行计划,指出函数操作和隐式类型转换导致索引失效的机制。掌握这些规律有助于编写高效SQL并避免性能陷阱。
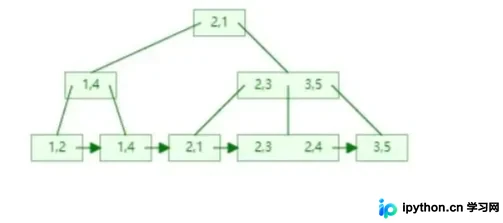
本文介绍 MySQL 中利用 ON DUPLICATE KEY UPDATE 子句实现“存在则更新,不存在则插入”的高效方法。通过解析唯一索引冲突逻辑、受影响行数判断及 VALUES() 函数在多行插入中的应用,帮助开发者简化业务逻辑,提升数据操作性能。
本文深入解析MySQL中IN与EXISTS查询的执行差异。EXISTS通过逐行驱动子查询并返回布尔值,适合子查询结果集大的场景;IN则先执行子查询生成列表再匹配,适合主表大、子查询结果小的场景。实际选择需结合MySQL版本优化器逻辑与数据分布进行测试,避免盲目优化。
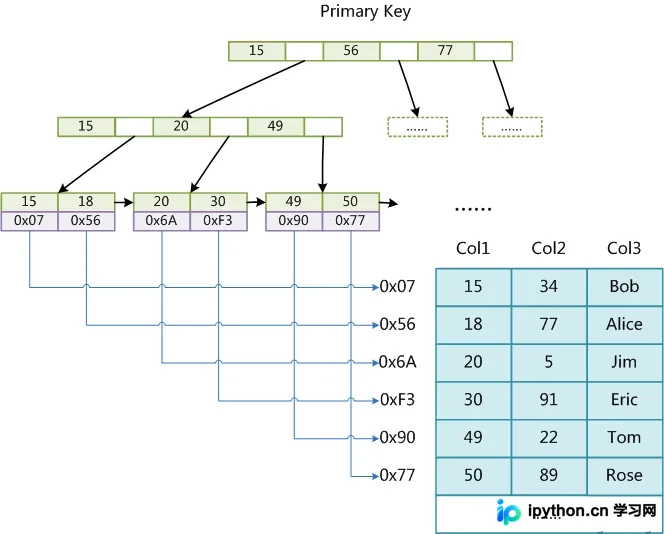
本文深入对比分析MySQL与Lucene的底层索引机制。MySQL基于B+Tree构建聚集与非聚集索引,适合精确匹配与范围查询;而Lucene采用倒排索引结构,通过Term Dictionary、Posting List实现高效的全文检索。文章详细剖析了两种索引在数据结构、内存消耗及联合查询上的核心差异,帮助开发者根据业务需求选择合适的数据存储与检索方案。