Python 使用 kafka-python 库读取 Kafka 消息的完整示例
本文介绍如何在 Python 中通过 kafka-python 库连接 Kafka 集群并消费消息。核心步骤包括安装依赖、编写 setting.py 配置文件指定主机、Topic 和 Group ID,以及使用 KafkaConsumer 订阅主题并循环打印消息详情。
10-13
6




本文介绍如何在 Python 中通过 kafka-python 库连接 Kafka 集群并消费消息。核心步骤包括安装依赖、编写 setting.py 配置文件指定主机、Topic 和 Group ID,以及使用 KafkaConsumer 订阅主题并循环打印消息详情。
本文介绍了如何使用Python的pykafka库连接Kafka集群。通过提供生产者和消费者的完整代码示例,展示了如何配置主机地址、创建客户端、发送消息以及消费消息。该实例适用于希望快速验证Kafka集群连通性及基础功能的开发者,涵盖了从环境配置到核心API调用的关键步骤。
本文介绍如何在 Python 中使用 kafka-python 库实现多线程 Kafka 消费者,并演示如何手动管理 Offset 提交。通过继承 threading.Thread 类创建自定义线程,分别处理不同分区的数据消费。代码展示了如何配置 Broker 列表、指定 Topic 和 Partition,以及在消费循环中手动提交 Offset 以确保消息处理的可靠性。该示例适用于需要高并发处理且对消息顺序或提交时机有特定要求的场景。
本文详细介绍如何使用 Python 连接并消费 Kafka 数据。内容涵盖 kafka-python 模块安装、压缩依赖处理、生产者发送消息示例,以及基于 KafkaConsumer 的消费者实现。重点讲解如何通过多线程机制并行处理不同分区数据,提升消费效率,并提供完整代码参考与官方文档链接。
本文通过Python代码示例,详细讲解Kafka的核心操作。内容涵盖基础的消息生产与消费、基于分区机制的负载均衡策略、利用偏移量(Offset)进行历史数据回溯,以及通过轮询(poll)实现定时批量拉取数据的最佳实践,帮助开发者掌握Kafka在Python环境下的关键应用技巧。

本文介绍使用kafka-python库通过SimpleProducer向Kafka发送批量数据的实现方式。核心逻辑是将数据按Topic分区数(PARTNUM)均分,确保每条数据均匀落入不同Partition。代码展示了如何初始化客户端、计算切片范围并调用send_messages方法,最后关闭连接,适用于需要保证数据负载均衡的场景。
本文介绍如何使用Python的kafka-python库实现Kafka消息的JSON格式读写。重点解析生产者KafkaProducer中value_serializer参数的配置,通过json.dumps将字典编码为UTF-8字节流;以及消费者KafkaConsumer中value_deserializer参数的设置,利用json.loads解析消息。示例包含完整的连接配置、数据构造及循环发送逻辑,适用于需要结构化数据传输的场景。
本文针对每日千万级Kafka数据写入磁盘的场景,探讨了如何高效管理动态生成的文件及计数器。通过对比尝试使用exec等动态语法失败的经历,最终提出利用三个独立字典分别存储计数器、时间戳和分类信息的解决方案。该方法避免了定义海量变量的性能损耗,实现了基于配置条数自动切换文件后缀(tmp转out)的稳定处理流程。
本文详细介绍如何在Go中使用第三方库Sarama实现Kafka消息的生产和消费。通过配置SyncProducer发送消息到指定Topic和分区,并获取Partition ID与Offset验证写入成功;同时演示利用NewConsumer创建多个Partition Consumer协程,遍历所有分区持续拉取最新消息,提供完整的代码示例与关键参数说明。
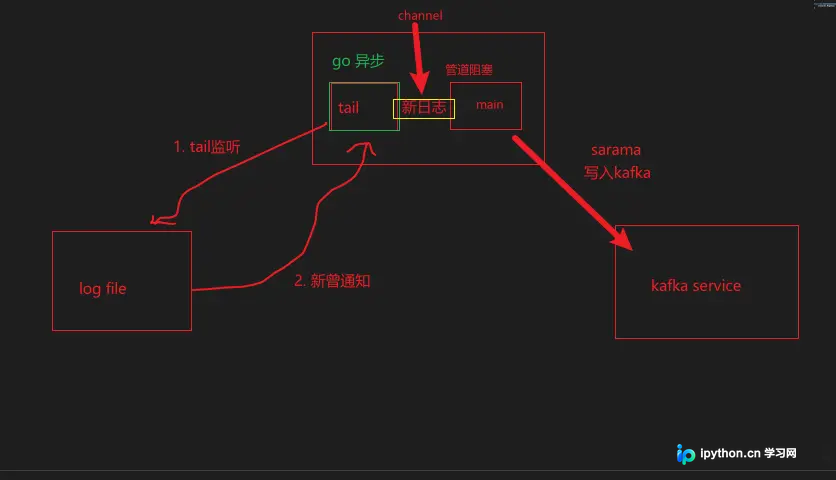
本文介绍如何利用Golang编写程序实时监听日志文件变动,并将其数据流式发送到Kafka集群。通过go-ini管理配置,结合hpcloud/tail库追踪文件新增内容,并使用Shopify/sarama客户端发送消息。代码采用协程与Channel进行异步解耦,适合构建轻量级Logstash替代方案。
本文介绍如何在Python性能测试中,通过多线程快速生成批量Mock数据并发送至Kafka。结合appmetrics库监控TPS速率,使用Faker生成多样化测试数据,实现高效的数据压测准备。
本文介绍利用Python通过pykafka消费Kafka数据,并批量插入Elasticsearch的方法。针对Kafka 0.8版本,使用get_simple_consumer确保多应用不重消费。通过设置consumer_timeout_ms避免阻塞,并配合死循环持续处理。当数据达到阈值时,利用bulk接口批量写入ES,适用于高并发数据场景。



